Edge0 近期正式发布了 Audio8-TTS-Realistic,这是一款参数量为 0.6B 的开放权重文本转语音(TTS)模型。该模型专为零样本语音克隆设计,仅需提供一个参考音频片段及其对应的转录文本,即可完成声音克隆。
- 项目主页:https://edge0-ai.github.io/Audio8_TTS/realistic-0.6b/
- GitHub:https://github.com/Edge0-AI/Audio8_TTS
- 模型:https://huggingface.co/Edge0/Audio8-TTS-Realistic-0.6b
- Audio8-TTS-Realistic-Air:https://www.modelscope.cn/models/Edge0/Audio8-TTS-Realistic-Air
此次更新将支持的语言数量扩展至 23 种,较前代增加了 12 种。其核心价值在于,为开发者提供了一个在参数规模上足够轻量、便于微调与本地部署,同时在多语言准确性上具备竞争力的开源方案。模型权重与代码均已基于 Apache 2.0 协议开源。
Audio8-TTS-Realistic-Air 基于 Audio8-TTS-Preview-0.6b 构建,在保持紧凑的 0.6B 架构和零样本语音克隆能力的同时,实现了显著提升的语音逼真度。
本次发布支持 23 种语言,相比 Preview 版本新增 12 种语言。它使用与 Preview 相同的 Transformers 推理接口。本仓库包含完整的模型检查点、44.1 kHz 神经音频编解码器、分词器、处理器以及自定义 Transformers 代码。
核心架构:双自回归设计提升推理效率
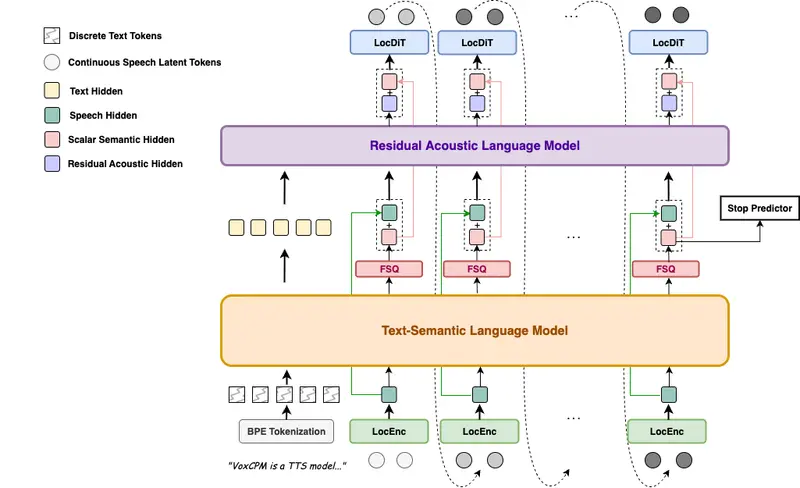
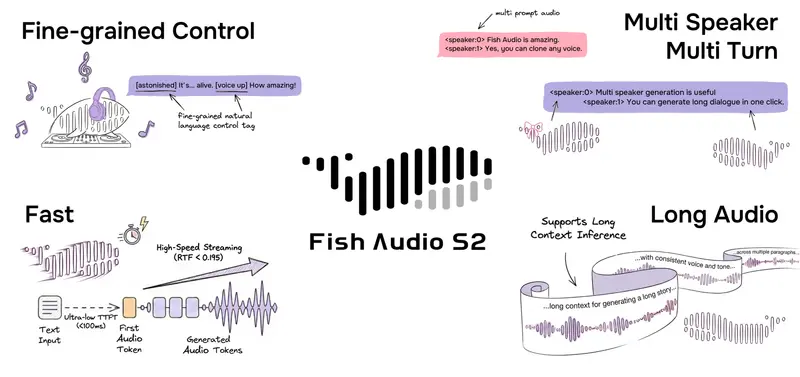
Audio8-TTS-Realistic 采用了受 Fish Audio S2 Pro 启发的双自回归(DualAR)架构,通过分离计算任务来平衡生成质量与速度。
- 慢分支:基于 Qwen2.5 0.5B 架构构建,包含 24 层,宽度为 896,运行频率约为 21.5 帧/秒。该分支负责在每一步预测文本 token 以及第一个音频码本。
- 快分支:一个浅层的 4 层网络,负责并行预测剩余的 9 个音频码本。
这种设计确保了顺序计算仅发生在帧级别,大幅降低了推理过程中的计算开销,同时保持了音频生成的连贯性。
真实感训练:引入评论家模型优化节奏与停顿
传统的词错误率(WER)和说话者相似度(SIM)指标往往无法准确衡量语音的节奏、停顿和时机,导致模型得分高但听感依然生硬。为此,Edge0 团队设计了包含三个阶段的训练流程:
- 多语言监督微调(SFT):建立基础的多语言语音生成能力。
- 组合奖励 GRPO:使用群体相对策略优化,其中 WER 权重设为 0.7,SIM 权重设为 0.3,初步对齐文本准确性与声音相似度。
- 真实感评论家引导的 GRPO:引入一个专门训练的评论家模型,根据同一句子的匹配人类录音对生成结果进行打分。
该评论家模型基于 6 个开源 TTS 系统的质量阶梯进行训练,人类录音位于阶梯顶端。为防止模型作弊,训练中还加入了身份擦除损失,阻止评论家奖励生成器的特定指纹;同时设置了持续时间惩罚,防止模型通过故意放慢语速来欺骗评论家。
基准测试表现与客观局限
在多项公开基准测试中,Audio8-TTS-Realistic 展现了与其参数量相匹配的性能,但也暴露出在特定场景下的局限性。以下为自报错误率数据(越低越好):
- CV3(9 种语言):平均错误率 4.86%,说话者相似度(SIM)0.661。该成绩优于 VoxCPM2(5.35%)和 Qwen3-TTS-1.7B(7.73%)。
- Seed-TTS(英/中):平均错误率 1.25%,SIM 0.704。
- MiniMax(24 种语言):平均错误率 5.89%,SIM 0.754。
性能局限:
尽管在 CV3 基准上表现优异,但在参数量更大的模型面前仍有差距。例如,Higgs TTS 3(约 4B 骨干)在 CV3 和 MiniMax 上的错误率分别为 4.41% 和 2.74%。此外,模型在低资源语言上的表现依然薄弱,例如泰语在 CV3 上的 WER 高达 48.57%,粤语在 MiniMax 上的 CER 达到 31.35%。
工程部署与生态支持
为满足开发者的实际落地需求,Audio8-TTS-Realistic 提供了完善的工程化支持。
- 基础环境:需要 PyTorch 2.5+ 和 Transformers 4.57+,通过
trust_remote_code=True即可加载。仓库内捆绑了检查点、44.1 kHz 神经音频编解码器、分词器及处理器。 - 推理优化:针对 GPU 服务,官方提供了 SGLang Omni 适配器,支持分页注意力机制、动态批处理,并开放了与 OpenAI 兼容的
/v1/audio/speechAPI 接口。 - 开发工具:GitHub 仓库内附带了命令行工具(CLI)、批处理脚本以及监督微调(SFT)脚本,方便开发者进行二次开发与定制化训练。
目前,该模型在 Apple M2 CPU(INT4 ONNX 格式)上的峰值内存占用约为 1.1 至 1.2 GiB,展现了良好的端侧运行潜力,但官方暂未公开 Realistic 版本的 ONNX 导出方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。