英伟达最新发布 Nemotron 3.5 Transcribe,一款开放权重的语音增强语言模型(SALM)。和传统语音系统把语音检测、转写、说话人区分、翻译拆成多个模型串联运行不一样,它在单次前向推理里就承接全部任务,同时还支持针对音频内容直接提问。
- 模型:https://huggingface.co/collections/nvidia/nemotron-35-transcribe
- Demo:https://huggingface.co/spaces/nvidia/nemotron-transcribe
伴随模型发布的,还有用于微调的开源数据管道及大规模数据集 Granary v2,进一步降低了开发者定制专业领域语音模型的门槛。
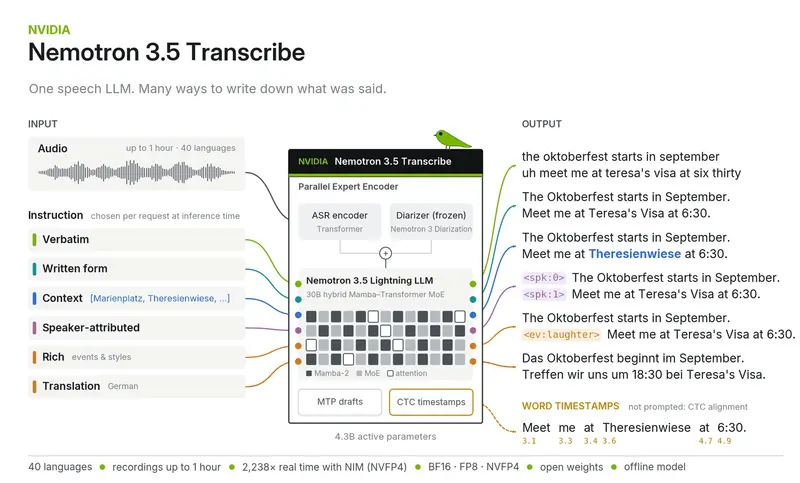
核心架构:高效 MoE 设计与单次传递工作流
Nemotron 3.5 Transcribe 是一款拥有 300 亿(30B)总参数的混合专家(MoE)模型,每次推理仅激活约 40 亿(4B)参数(包含音频编码器)。这种高稀疏度的设计使其在保持强大表达能力的同时,大幅降低了计算和内存需求。
传统转录模型通常需要串联多个独立模型(语音检测 → 转录 → 说话者分离 → 问答),而 Nemotron 3.5 Transcribe 创新性地将这些步骤融合为单次模型传递(Single-pass)。它原生支持 40 种语言,能够处理长达 1 小时的录音(支持 65,536 token 上下文),并最多可同时标记 8 位不同的说话者。
提示词驱动:从“被动转录”到“主动音频理解”
该模型最大的交互亮点在于其高度的提示词驱动(Promptable) 能力。同一个模型检查点,用户可以通过不同的文本指令,将同一段录音转化为截然不同的输出:
- 基础转录:“转录录音并标记每位说话者。”
- 跨语言翻译:“将此音频实时翻译成英语。”
- 智能总结与问答:“这次会议做出了哪些关键决定?”或“提取所有提到的财务数据。”
- 上下文增强:用户可在转录前向模型提供专业术语表或背景对话,显著提升特定领域(如医疗、法律)的转录准确率。
卓越的性能表现与跨平台部署
尽管参数量紧凑,Nemotron 3.5 Transcribe 的性能却远超同级别模型,且具备极强的硬件适应性,可从边缘设备无缝扩展至数据中心:
- 开箱即用的高准确率:在通用测试中,其基础词错误率(WER)为 30.8%;通过精心设计的提示词引导,WER 可进一步降至 20.8%。
- 专业领域微调潜力:在 Eka Care 印度医学语音基准上进行针对性微调后,模型的 WER 惊人地降至 11.8%,展现出极高的专业场景适配能力。
- 全栈硬件支持:模型支持 BF16、FP8 和 NVFP4 精度。它既可以在边缘计算设备(如 Jetson AGX Thor 机器人大脑)或桌面 AI 超级计算机(DGX Spark)上运行,也能在数据中心大展身手。英伟达数据显示,在采用 NVFP4 精度和四分之一模型压缩的 Blackwell 服务器 GPU 上,该模型仅需 3 分钟即可处理完 100 小时的音频数据。
Granary v2:开源数据生态赋能开发者
为了支撑该模型的训练并赋能社区,英伟达将其大规模开源公共多语言语音 AI 数据集 Granary 升级至 v2 版本。使用 NVIDIA NeMo Curator 构建的 Granary v2 实现了显著扩容:
- 规模跃升:公开清单覆盖 48 种语言和 16 个来源语料库,总计高达 463,062 小时的音频数据(远超 v1 版本的 25 种语言)。
- 多样化转录风格:数据集为每个录音生成了三种不同风格的转录稿,开发者可通过提示词向模型请求匹配的风格:
- 完整逐字稿:包含所有“嗯”、“啊”等填充词。
- 数字简化版:将完整的数字拼写转换为符号(如将“一百”转为“100”),提升可读性。
- 纯净版:自动消除所有填充词和非语言声音。
这种丰富的数据管道使开发者能够轻松将不同语言的转录适配为符合特定业务需求的可读格式,并高效微调模型输出。
可用性与未来展望
目前,Nemotron 3.5 Transcribe 已作为开放权重模型在 Hugging Face 上提供演示和检查点下载。开发者不仅可以立即体验其强大的多语言转录、语音翻译、时间戳预测和语言识别能力,还可以利用 Granary v2 数据集和开源微调管道,将其深度适配到医疗、金融、客服等垂直领域的专业知识中。
© 版权声明
文章版权归作者所有,未经允许请勿转载。