Reka 推出 Rho-1 的研究预览版本,这是一款从头训练的19B全模态推理模型。单个神经网络就可以完成文本、图像、视频的理解与生成,同时输出机器人动作,用来替代传统多模态方案里,多个专用模型之间互相传递任务的智能体管线。
- 官方介绍:https://reka.ai/labs/research/rho-1-collapsing-the-multimodal-stack
传统多模态系统大多是管线式架构:主模型做规划,再把任务分发给图像、视频、检测等独立专家模型。模型之间来回交接会带来额外延迟,每个子模型只能看到局部任务信息。
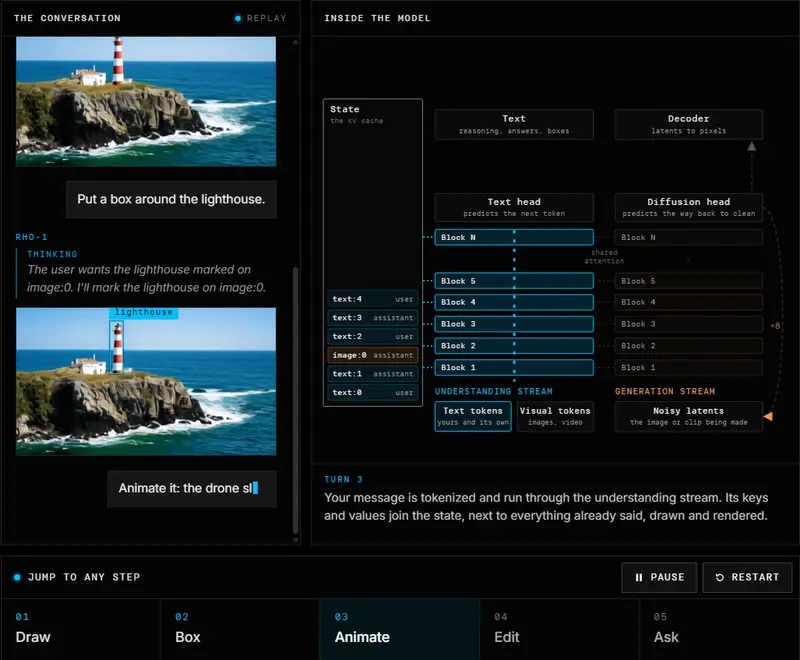
而 Rho-1 取消了这种多模型交接逻辑,文本、视觉信息、机器人动作全部放在同一个上下文窗口,统一用token处理。官方演示里,模型在5轮交互内完成画图、框选物体、动画生成、修改视频暴风雪效果并解释改动全程,全程无需调用额外工具或第二个模型。
核心架构:双数据流,共享KV缓存
模型输入输出分为两类token:
- 离散token:承载文本、符号推理、高层指令
- 连续token:承载图像潜变量、视频帧、机器人动作、本体感知数据
每个Transformer模块内置两组专家权重流:理解流负责语言、视觉解析;生成流负责把潜变量去噪,渲染图像与视频。两条流共享注意力机制,复用同一份KV缓存。
当需要输出画面像素内容时,理解流会发送离散交接token,由生成流基于完整上下文状态完成渲染。训练同时包含离散token的下一词预测,以及连续输出的流匹配任务。
这种设计带来很多便利:目标框坐标直接作为token输出,不需要外接检测器;生成视频首帧可以复用已有图像特征,不用重复编码。
生成速度:基础版与蒸馏版本
- 基础模型:视频生成中位数0.79倍实时,大约6秒就能看到可预览画面;首段剪辑7秒,对比传统多智能体管线13.8秒,耗时大幅缩短。
- 蒸馏版本:将去噪步骤从99步压缩至8步,画质损失很小,生成一段5.3秒的视频剪辑仅需约1秒,内部测试达到顶尖专用图像模型水准,同时文本首token响应速度也很快。
注:速度数据来自厂商内部自测,并非第三方独立基准测试。
世界模型与机器人能力
Rho-1支持流式连续生成,一段视频接一段视频,中途接收新指令并实时更新状态,可实现画面分支推演,例如同一个画面分别模拟向左、向右倾斜两种结果。
面向机器人场景,动作指令与未来画面帧从同一个潜空间解码。在LIBERO仿真测试中,Rho-1可输出7通道机器人动作。为弥补机器人遥操作数据稀缺问题,Reka搭配逆动力学模型,直接从原始视频反推出设备控制信号。
横向对比
Rho-1和字节BAGEL、BAAI Emu3.5、谷歌Genie 3多模态模型关键差异:
- Rho-1原生支持视频生成+输出机器人动作,是少数一体实现视觉生成与具身控制的模型;
- BAGEL、Emu3.5开源开放权重,Rho-1、Genie3暂不开放权重;
- Genie3支持720p 24fps视频,Rho-1视频上限672×384;
- 接入方式:Rho-1目前仅接受邮件申请研究预览,没有公开API。
要点小结
- 定位:19B参数一体化全模态模型,统一处理文本、图像、视频、机器人动作,省去多模型管线切换。
- 架构亮点:理解流+生成流双专家流,共享KV缓存,离散与连续token混合处理。
- 性能:蒸馏版本大幅加速视频生成,5.3秒剪辑约1秒出片。
- 机器人能力:原生输出动作,搭配逆动力学模型,利用普通视频补齐机器人训练数据。
- 现状:仅研究预览,无公开权重、正式API和定价,训练使用320块H100,训练周期3个月。
© 版权声明
文章版权归作者所有,未经允许请勿转载。