微软旗下 GitHub 宣布了一项引发广泛关注的数据政策变更:默认情况下,用户与 GitHub Copilot 的所有交互数据(包括代码片段、注释、文件名等)将被用于训练和改进其 AI 模型。
这意味着,如果你正在使用 Copilot 编写代码,你的劳动成果可能正悄然成为下一代 AI 的“养料”。不过,GitHub 也提供了选择退出(Opt-out)的机制,但需要用户主动操作。
核心变更:你的代码成了训练数据
1. 收集范围极其广泛
GitHub 明确表示,收集的数据不仅限于你输入的代码,还包括:
- 输入与输出:你向 Copilot 提问的内容及其生成的回答。
- 代码上下文:代码片段、注释、文档字符串。
- 元数据:文件名、仓库目录结构、甚至是你使用的编程语言模式。
- 场景:涵盖 VS Code 插件、GitHub 网页版、Copilot CLI 等所有集成环境。
2. 受影响人群
- ✅ 免费个人用户:默认开启收集。
- ✅ 付费个人用户 (Pro):默认开启收集。
- ❌ 企业/商业用户 (Business/Enterprise):不受影响,数据不会被用于训练(这是企业版的核心卖点之一)。
官方理由:GitHub 称此举符合“行业标准”,旨在利用真实开发场景数据,让模型更理解工作流,提供更安全、准确的代码建议,并提前捕获漏洞。
如何保护你的代码?(立即行动指南)
如果你不希望自己的代码被用于训练,必须手动关闭该选项。GitHub 不会自动询问,也不会默认关闭。
操作步骤:
- 登录 GitHub:访问 github.com 并登录你的账户。
- 进入设置:点击右上角头像 → Settings(设置)。
- 找到 Copilot 设置:在左侧边栏中,向下滚动找到 Copilot 选项卡或者直接访问https://github.com/settings/copilot/features
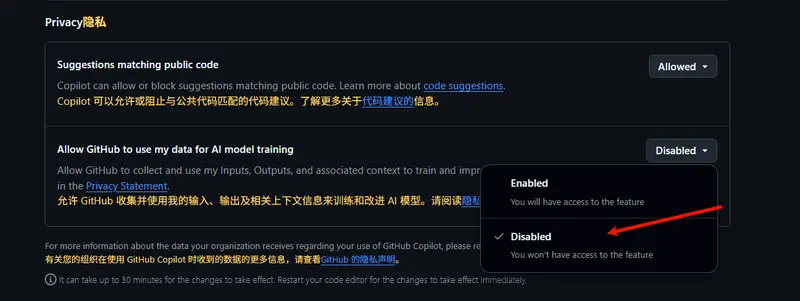
- 调整隐私选项:
- 找到 “Allow GitHub to use my data for AI model training”(允许 GitHub 使用我的代码片段进行 AI 模型训练)选项。
- 将其状态从 “Enabled” 改为 “Disabled”(禁用)。
- 检查多账户:如果你有多个 GitHub 账号(如个人号、工作号、小号),请务必对每个账号重复此操作,设置不互通。
为什么这很重要?
1. 知识产权与泄露风险
虽然 GitHub 承诺会进行脱敏处理,但对于开发专有算法、未开源项目或处理敏感逻辑的开发者而言,代码被纳入公共训练集仍存在潜在的逻辑泄露风险。未来其他用户通过 Copilot 可能会生成与你高度相似的代码结构。
2. “行业惯例”背后的博弈
GitHub 辩称这是“行业惯例”(参考 Meta、谷歌等做法),但这实际上是将免费/个人用户的产品体验转化为数据资产。付费个人用户($10/月)在未明确告知的情况下也被纳入其中,引发了关于“付费是否应享有更高隐私权”的争议。
3. 企业版的护城河
这一政策进一步凸显了 Copilot Business/Enterprise 的价值。对于公司而言,只有购买企业版才能从合同和法律层面确保代码不被用于训练。这也倒逼更多团队从个人版迁移至企业版。
建议
- 立即检查:无论你是否在意,建议立刻登录账号确认设置状态,掌握主动权。
- 敏感项目隔离:对于高度机密的项目,即使退出了训练,也建议在非联网环境或使用本地大模型进行开发。
- 关注后续:随着 AI 法规(如欧盟 AI 法案)的完善,此类数据政策可能会面临更多法律挑战,需保持关注。
代码是你的智慧结晶,是否共享应由你决定,而非默认被“征用”。 花一分钟去设置里关掉它,是对自己劳动成果最基本的尊重。
© 版权声明
文章版权归作者所有,未经允许请勿转载。