2026年9月短短30天,Anthropic、OpenAI、Google DeepMind接连推出四款顶级闭源前沿模型:Claude Fable 5.1、GPT-6 Astra、GPT-6.1 Sol、Gemini 4 Argon。其中原定更强的GPT-6.1 Astra,在9月28日因内部安全与授权测试不达标直接取消发布,GPT-6 Astra保留为OpenAI当前旗舰。(PS:其实少了Opus 5.5 和 Sonnet 5.5 )
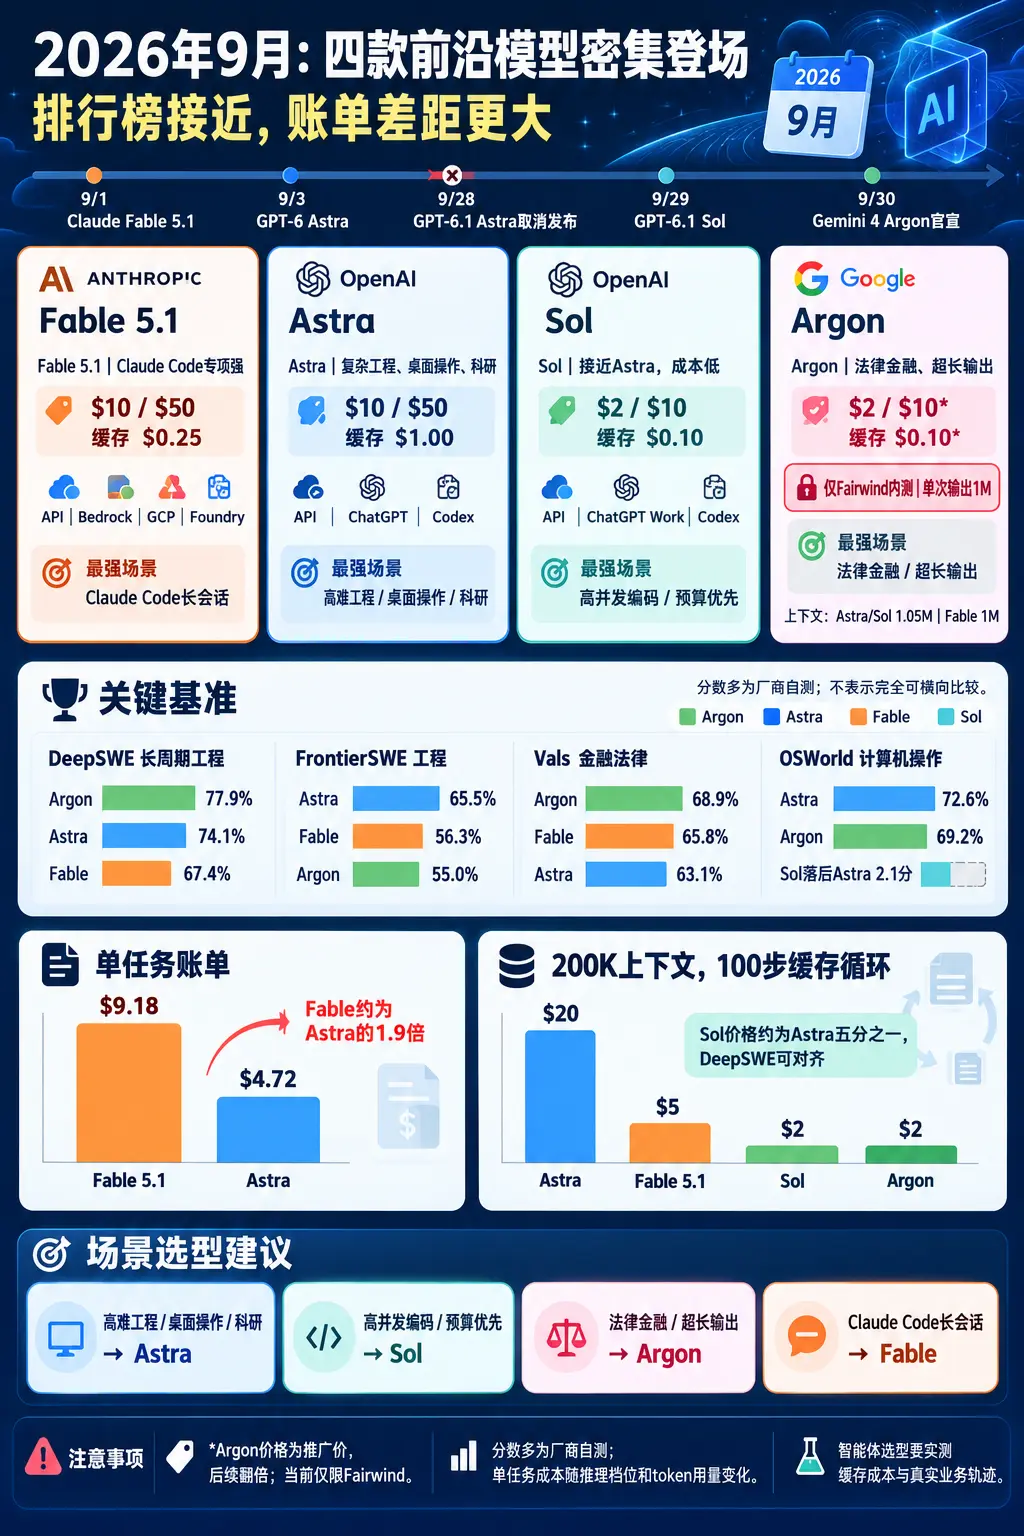
基准测试分数差距并没有各家宣传稿拉开得那么悬殊,但定价、访问权限、单任务实际成本差异巨大,选型更要看业务负载,而非单纯排行榜。(信息来源)
规格、定价与访问权限
| 特性 | GPT-6 Astra | GPT-6.1 Sol | Gemini 4 Argon | Claude Fable 5.1 |
|---|---|---|---|---|
| 开发方 | OpenAI | OpenAI | Google DeepMind | Anthropic |
| 发布时间 | 2026.9.3 | 2026.9.29 | 2026.9.30官宣 | 2026.9.1 |
| 访问渠道 | OpenAI API、ChatGPT、Codex | OpenAI API、ChatGPT Work、Codex | 仅限Fairwind Program | Claude API、Bedrock、GCP、Microsoft Foundry |
| 输入/输出(每百万token) | $10 / $50 | $2 / $10 | $2 / $10(推广价,后续翻倍至$4/$20) | $10 / $50 |
| 缓存输入(每百万token) | $1.00 | $0.10 | $0.10(推广期) | $0.25 |
| 长提示词加价 | 超过272K:$20 / $75 | 超过272K:输入×2,输出×1.5 | 未披露 | 1M内统一价格,无额外加价 |
| 上下文窗口 | 1.05M | 1.05M | 未公开 | 1M |
| 单次最大输出 | 128K | 128K | 1M | 128K |
| 推理强度 | 5档努力级别 | 5档努力级别 | 未披露 | 低/中/高3档 |
| 开放权重 | 否 | 否 | 否 | 否 |
缓存价格对AI智能体至关重要。智能体会反复发送系统提示词、工具Schema与历史上下文。Astra缓存读取成本是Fable 5.1的4倍、Sol的10倍。Argon是四款里唯一支持单次输出100万token的模型,其余三款上限均为128K。
基准评测:各有所长,没有全能王者
- Gemini 4 Argon:长视野软件工程DeepSWE v1.1、金融/法律/税务Vals Index得分领先;CWE-bench漏洞修复与Astra并列第一
- GPT-6 Astra:前沿软件工程FrontierSWE v2、OSWorld-2.0计算机使用基准领跑;Terminal-Bench Science科研任务最强
- Claude Fable 5.1:在Claude Code编码智能体专项索引拿到最高分;独立AI智力指数分数更高
- GPT-6.1 Sol:DeepSWE v1.1可以达到Astra同级水平,但价格仅为Astra五分之一;OSWorld 2.0略低于Astra,但单任务成本大幅降低
| 基准项目 | 测试方向 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| DeepSWE v1.1 | 长周期软件工程 | 77.9% | 74.1% | 67.4% |
| Vals Index | 金融、编码、法律税务 | 68.9% | 63.1% | 65.8% |
| FrontierSWE v2 | 前沿软件工程 | 55.0% | 65.5% | 56.3% |
| Terminal-Bench 4.0 | 终端智能体任务 | 57.4% | 58.2% | 57.9% |
| CWE-bench v1 | 漏洞修复 | 68%(并列) | 68%(并列) | 58% |
| OSWorld-2.0 | 计算机操作智能体 | 69.2% | 72.6% | 无Google公布数据 |
GPT-6.1 Sol未列入Google对比表,OpenAI内部数据显示:DeepSWE可对齐Astra;OSWorld-2.0仅落后Astra 2.1分,成本大幅下降。
单任务真实成本:标价相同,账单差异巨大
即使token标价一致,不同模型完成同一个任务消耗的token总量不同,最终账单差距明显:
- Claude Fable 5.1:单任务约$9.18
- GPT-6 Astra:单任务约$4.72,Fable约为Astra的1.9倍;原因是Fable tokenizer生成token数量更多,文本同等内容多出约30%token
缓存密集型智能体场景(200K上下文循环调用),缓存成本对比:
| 模型 | 缓存费率/百万token | 单步缓存开销 | 100步循环总开销 |
|---|---|---|---|
| GPT-6 Astra | $1.00 | $0.20 | $20.00 |
| Claude Fable 5.1 | $0.25 | $0.05 | $5.00 |
| GPT-6.1 Sol | $0.10 | $0.02 | $2.00 |
| Gemini 4 Argon(推广价) | $0.10 | $0.02 | $2.00 |
智能体长循环任务中,缓存成本会直接反转模型性价比排名,选型建议用自己业务真实运行轨迹实测。
场景选型推荐
| 业务场景 | 推荐模型 | 理由 | 备选 |
|---|---|---|---|
| 高并发编码智能体、CI机器人、PR代码审查 | GPT-6.1 Sol | DeepSWE对标Astra,低价+极低缓存开销 | Gemini 4 Argon(开放后) |
| 高难度开放式工程难题 | GPT-6 Astra | FrontierSWE v2得分最高 | Claude Fable 5.1 |
| 浏览器/桌面计算机使用智能体 | GPT-6 Astra | OSWorld 2.0 72.6%领先 | GPT-6.1 Sol |
| Claude Code长代码会话 | Claude Fable 5.1 | 编码智能体专项得分最高 | GPT-6 Astra |
| 硬核科研与研究任务 | GPT-6 Astra | Terminal-Bench Science 68.1%领先 | GPT-6.1 Sol |
| 法律文书、金融业务自动化 | Gemini 4 Argon | Vals Index、AutomationBench、Harvey Legal领先 | GPT-6.1 Sol |
| 超长单次输出:大型代码重构、完整长篇报告 | Gemini 4 Argon | 唯一支持单次1M token输出 | 其余模型多轮拆分 |
| 漏洞挖掘、漏洞修补 | Gemini 4 Argon / GPT-6 Astra | CWE-bench v1并列68% | Claude Fable 5.1 |
| 预算受限,追求前沿能力性价比 | GPT-6.1 Sol | 公开最低价 | Gemini 4 Argon(推广期,仅限Fairwind) |
访问限制提醒:Argon目前仅对Fairwind网络防御项目开放;Astra完整攻击性安全能力被放在OpenAI Daybreak计划,公开版本会拒绝高危攻击性网络任务;Anthropic的无限制版本Claude Mythos 5.1同样需要特殊准入。
注意事项
- 大部分基准为厂商自测,不同厂商评测环境存在差异,分数不能直接横向硬对比;
- Fable 5.1基准是开启生产安全防护的条件下跑出,高危任务会路由到其他模型,可能拖累OSWorld等分数;
- Gemini 4 Argon的低价是临时推广价,未来将涨价一倍,且输入上下文上限并未对外披露;
- 单任务成本是快照数据,模型推理努力档位会显著改变token消耗和账单金额。
核心要点
- GPT-6.1 Sol以Astra五分之一价格,在长周期软件工程任务上对齐旗舰Astra,是多数团队的默认首选;
- GPT-6 Astra擅长复杂软件工程、桌面/浏览器智能体、科研任务,计算机使用基准一枝独秀;
- Gemini 4 Argon长文本输出能力独一档,法律金融业务表现突出,但现阶段仅限特定项目内测,价格未来上调;
- Claude Fable 5.1标价与Astra一致,但单任务实际成本更高,在Claude Code编码场景优势明显,缓存成本低于Astra;
- 面向循环执行的AI智能体,缓存价格是不可忽略的关键指标,Sol与Argon的缓存成本优势巨大。
© 版权声明
文章版权归作者所有,未经允许请勿转载。