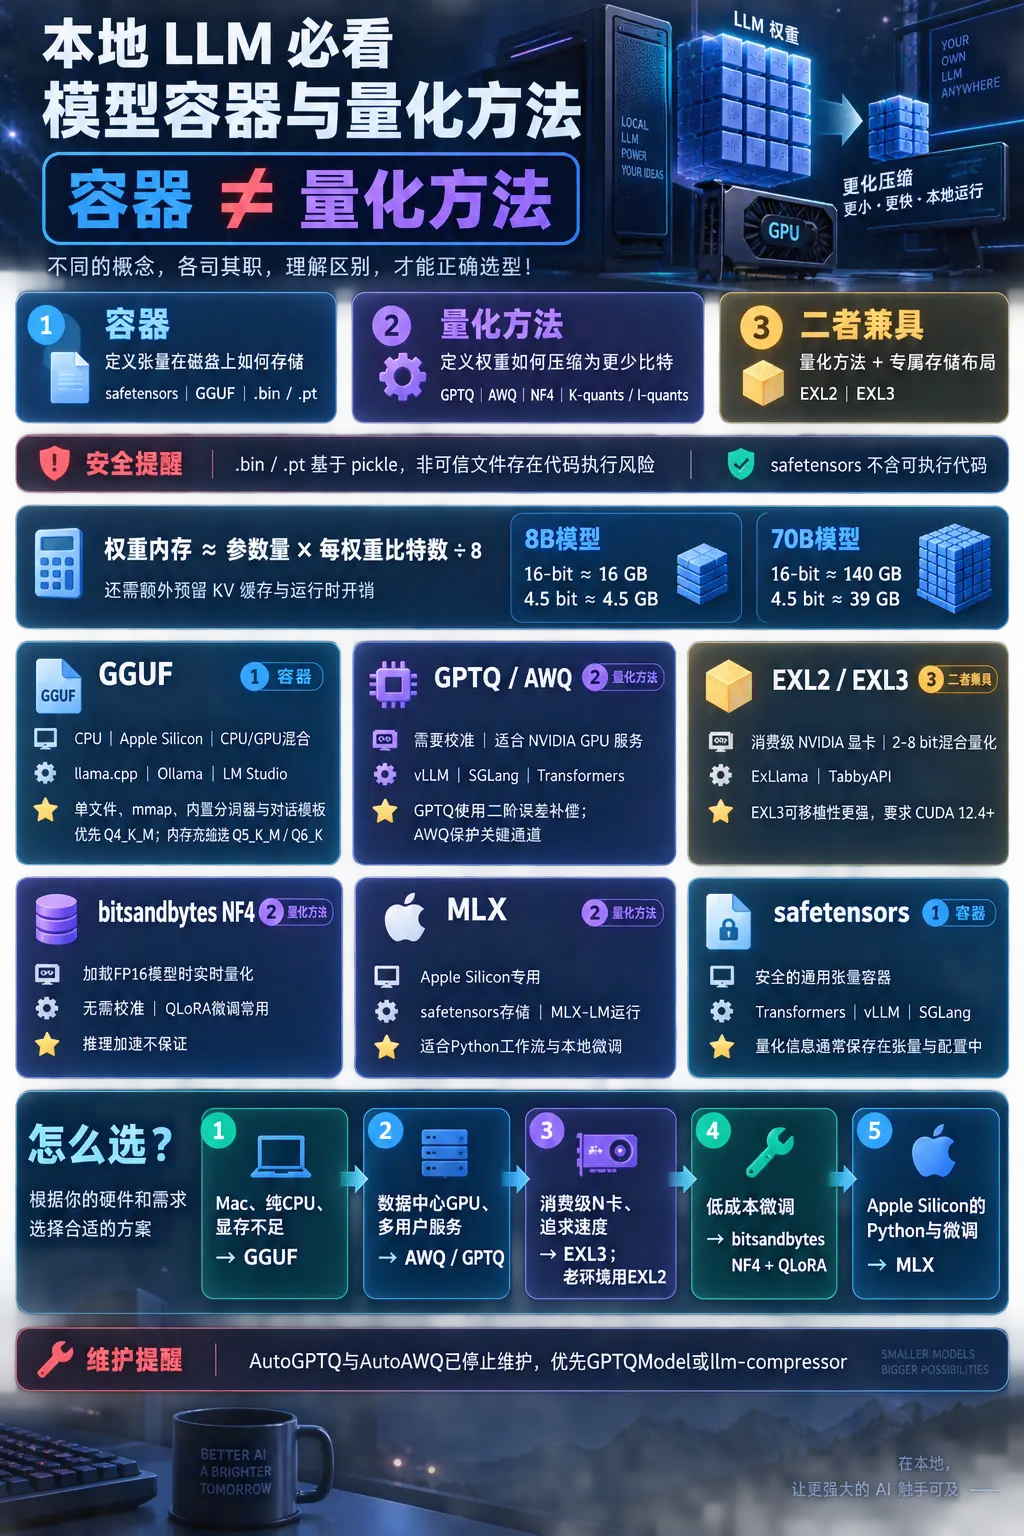
很多新手在本地部署大模型时,很容易混淆模型容器和量化方法这两个概念,这也是看懂GGUF、GPTQ、AWQ、EXL2等名词的关键。容器定义张量在磁盘上如何存储;量化方法定义权重如何压缩至更少比特。
- 容器:safetensors、GGUF、PyTorch pickle(.bin/.pt)
- 量化方法:GPTQ、AWQ、bitsandbytes NF4、llama.cpp K-quants / I-quants
- 二者兼具:EXL2、EXL3,是量化方法+绑定推理库的专属存储布局
内存估算简易公式
权重内存 ≈ 参数量 × 每权重比特数 ÷ 8
仅代表权重占用,KV缓存、运行时开销需要额外增加内存
| 模型 | 16-bit | 约4.5bit/权重 |
|---|---|---|
| 8B | ~16 GB | ~4.5 GB |
| 70B | ~140 GB | ~39 GB |
1. 全精度:safetensors 与 PyTorch .bin
未量化模型一般采用16bit权重,文件为pytorch_model.bin或model.safetensors。
传统.bin/.pt基于Python pickle,加载文件可执行任意代码,加载非可信模型存在安全隐患。
Safetensors由HuggingFace推出,无任何可执行代码,文件由JSON头部+原始张量缓冲区构成,支持内存映射、分块加载,现已纳入PyTorch Foundation项目。
注意:GPTQ、AWQ、EXL2、EXL3、MLX量化模型,底层文件很多也是safetensors。量化信息保存在张量内容与配置文件,并不是全新容器格式。
2. GGUF(llama.cpp)
GGUF是llama.cpp生态原生二进制格式,2023年8月发布,用来替代旧版GGML。
旧GGML系列无法记录模型架构,新增超参数就会破坏文件兼容性。GGUF采用带类型键值元数据,可扩展且向前兼容。
设计目标:单文件分发、可扩展、支持mmap、加载简单,文件内置权重、分词器、特殊token、Jinja对话模板。
GGUF量化后缀含义
以Q4_K_M.gguf为例,后缀代表量化方案
| 类型 | 原理 | 每权重比特数 |
|---|---|---|
| Q4_0 / Q4_1(旧) | 32权重块4bit就近取整,Q4_1额外增加块最小值 | 4.5 / 5.0 |
| Q8_0(旧标签) | 32权重块8bit就近取整 | 8.5 |
| Q2_K | 超级块16块×16权重,4bit缩放与最小值 | 2.625 |
| Q3_K | 16块×16权重,6bit缩放 | 3.4375 |
| Q4_K | 8块×32权重,6bit缩放最小值 | 4.5 |
| Q5_K | 8块×32权重,6bit缩放最小值 | 5.5 |
| Q6_K | 16块×16权重,8bit缩放 | 6.5625 |
| IQ4_XS | 256权重超级块,基于重要性矩阵 | 4.25 |
| IQ3_XXS | I-quant系列 | 3.06 |
| IQ2_XXS | I-quant系列 | 2.06 |
| IQ1_S | I-quant系列 | 1.56 |
_S / _M / _L代表混合量化,不是独立量化类型。Q4_K_M就是部分张量使用Q6_K,其余使用Q4_K,因此平均比特略高于4.5bit。
新增类型还有TQ1_0、TQ2_0三进制权重、MXFP4 4bit微缩放浮点。
量化质量权衡(Llama-2-7B参考)
| 量化 | 困惑度 | 相对FP16变化 | 文件大小 |
|---|---|---|---|
| FP16 | 5.9565 | 基线 | 13.0 GB |
| Q8_0 | 5.9584 | +0.03% | 7.0 GB |
| Q6_K | 5.9642 | +0.13% | 5.5 GB |
| Q5_K_M | 5.9796 | +0.39% | 4.8 GB |
| Q4_K_M | 6.0565 | +1.68% | 4.1 GB |
该测试基于7B老模型,新模型量化衰减表现会存在差异。
imatrix重要性矩阵
GGUF量化支持校准数据。llama-imatrix可基于文本计算重要性矩阵,llama-quantize --imatrix借助该矩阵提升低比特量化质量。1bit、2bit低比特量化如果不传入imatrix,工具会给出警告。
运行环境
GGUF原生适配llama.cpp、Ollama、LM Studio、GPT4All。vLLM虽支持,但属于实验性功能,需要额外插件,优化程度有限。
3. GPTQ
GPTQ于2022年10月发布,ICLR2023论文。属于训练后一次性权重量化,借助海森矩阵二阶信息做权重舍入,通过未量化权重补偿量化误差,仅需要少量校准数据集,不需要重训练。
- 性能:单A100上8B模型校准约20分钟;175B模型可在4GPU小时内量化至3~4bit,精度损失很小。
- 命名标签:
4bit-128g,128g即组大小;act-order(desc_act)按权重重要性排序,提升量化质量。
2026工具现状:原始AutoGPTQ已经停止维护;GPTQModel替代AutoGPTQ/AutoAWQ,输出模型可直接在Transformers、vLLM、SGLang运行;llm-compressor也支持GPTQ,输出compressed-tensors格式。
4. AWQ
AWQ(激活感知权重量化)来自MIT韩松团队,2023年6月发布,拿下MLSys 2024最佳论文。
核心思路:不是所有权重价值均等,保护约1%关键权重即可大幅降低量化误差。AWQ依靠激活幅度识别重要通道,而非权重本身,通过等价数学变换放大关键通道,统一硬件友好格式。无需反向传播,不容易在校准集上过拟合。
- 速度:TinyChat运行时相比FP16快3倍以上;8B模型A100校准仅10分钟,约为GPTQ耗时一半。
2026工具现状:AutoAWQ弃用,推荐使用vLLM的llm-compressor工作流;Apple Silicon的MLX-LM同样支持AWQ。
5. EXL2(ExLlamaV2)
EXL2是ExLlamaV2推理库专属格式,面向消费级NVIDIA显卡,支持2~8bit量化。
特点:支持层内、跨层混合比特,列级差异化分配比特;自动尝试多种量化方案,在校准集上测量误差,在目标比特限制下最小化最坏误差。
文件名一般标注4.65bpw这类非整数比特,而不是固定4bit。
推理服务推荐TabbyAPI,提供OpenAI兼容接口;张量经过重命名,很难在其他框架复用。
6. EXL3(ExLlamaV3)
EXL3为EXL2继任方案,基于Cornell QTIP网格编码量化。
- 转换简单:输入HF模型+目标比特,转换过程实时计算Hessian矩阵
- 成本可控:小模型几分钟,70B级别模型单张RTX4090耗时数小时
- 极低比特可用:Llama-3.1-70B在1.6bit下仍保持连贯输出,搭配3bit输出层+4K缓存,可装入16GB显存内
- 相比EXL2,张量结构保留更好,可移植性提升
新增能力:2–8bit KV缓存量化、张量/专家并行、投机解码、多模态,新版支持MoE模型CPU卸载。硬件依赖CUDA12.4+,ROCm尚在开发中。
7. bitsandbytes NF4 / INT8:加载时量化
bitsandbytes不属于预量化模型,是加载FP16模型时实时量化。NF4是适配正态分布权重的4bit NormalFloat,支持双重量化进一步节省显存,是QLoRA微调的主流方案。
- 无需校准数据集
- 推理加速不保证
- 单张48GB GPU即可完成65B模型QLoRA微调
8. MLX(Apple Silicon)
MLX-LM是苹果机器学习团队开发,专门在Apple Silicon上运行、微调大模型。MLX量化模型存储在safetensors,使用mlx_lm.convert做量化转换。Mac平台本地部署,GGUF与MLX都是主流方案。
其他量化相关名词
- compressed-tensors / FP8:llm-compressor输出格式,支持FP8、NVFP4等;FP8需要H100/H200/B100等新硬件才能发挥性能
- HQQ:免校准快速量化,低于4bit时精度衰减明显
- SINQ:免校准即时量化,已经集成进Transformers
- AQLM、SpQR、VPTQ、HIGGS:面向2bit以下的前沿研究量化算法
格式横向对比
| 格式 | 类型 | 是否需要校准 | 最优硬件 | 主流运行时 |
|---|---|---|---|---|
| Safetensors(16-bit) | 容器 | 无 | 显存充足GPU | Transformers、vLLM、SGLang |
| GGUF | 容器+量化类型 | 可选imatrix | CPU、Apple Silicon、CPU/GPU混合 | llama.cpp、Ollama、LM Studio |
| GPTQ | 量化方法,存储于safetensors | 需要 | NVIDIA GPU | vLLM、SGLang、Transformers |
| AWQ | 量化方法,存储于safetensors | 需要 | NVIDIA GPU | vLLM、SGLang、Transformers |
| EXL2 | 量化方法+专属布局 | 需要 | 消费级N卡 | ExLlamaV2、TabbyAPI |
| EXL3 | 量化方法+专属布局 | 内置转换 | 消费级N卡 | ExLlamaV3、TabbyAPI |
| bitsandbytes NF4 | 加载时量化 | 无 | NVIDIA/Intel GPU | Transformers、PEFT |
| MLX | 量化方法,存储于safetensors | 默认无 | Apple Silicon | MLX-LM |
选型决策框架与工具链现状
| 使用场景 | 推荐格式 | 关键理由 |
|---|---|---|
| Mac / 纯 CPU / 模型超 VRAM | GGUF (Q4_K_M 起) | 原生支持 CPU+Apple Silicon,混合卸载成熟 |
| 数据中心多用户服务 | AWQ/GPTQ (vLLM/SGLang) 或 FP8 | GPU 吞吐优化,生态完善 |
| 消费级 NVIDIA 单用户高吞吐 | EXL3 (TabbyAPI) | 细粒度比特率,极致 TPS |
| 预算内微调 | bitsandbytes NF4 + QLoRA | 无需校准,显存占用最低 |
| Apple Silicon Python 工作流 | MLX | 原生框架集成,微调支持 |
工具链重要更新:AutoGPTQ/AutoAWQ 已停止维护;llm-compressor 成为 vLLM 官方推荐的 AWQ/GPTQ 工作流;EXL3 需 CUDA ≥12.4,ROCm 支持待实现;FP8/compressed-tensors 需 H100/H200/B100/MI300 等新硬件才能发挥优势。
实践注意事项
- GGUF 质量验证:低比特(IQ1/IQ2)必须提供 imatrix,否则
llama-quantize会警告;Q8_0 虽被 HF 标为“旧版”,仍是近乎无损首选。 - EXL2 跨框架限制:张量重命名导致难以在非 ExLlama 环境复用,迁移前需确认兼容性。
- 校准数据代表性:GPTQ/AWQ/EXL2 的性能高度依赖校准集分布,生产环境应使用业务真实数据而非通用语料。
- 安全加载习惯:始终优先使用 safetensors;若必须加载 .bin,务必验证来源可信度并在隔离环境中测试。
- 基准时效性:文中困惑度数据来自 2023 年 Llama-2-7B,新架构(如 MoE、长上下文)对量化敏感度不同,部署前需重新评估。
掌握格式本质而非盲目追随榜单,才能在快速演进的 LLM 基础设施中做出稳健的技术决策。(来源)
来源:
规范和官方文档
- GGUF 规范 — https://github.com/ggml-org/ggml/blob/master/docs/gguf.md
- Hugging Face Hub: GGUF — https://huggingface.co/docs/hub/gguf
- llama.cpp imatrix README — https://github.com/ggml-org/llama.cpp/blob/master/tools/imatrix/README.md
- llama.cpp quantize README — https://github.com/ggml-org/llama.cpp/blob/master/tools/quantize/README.md
- Qwen 文档:llama.cpp 量化 — https://qwen.readthedocs.io/en/latest/quantization/llama.cpp.html
- Unsloth 文档:保存为 GGUF — https://unsloth.ai/docs/basics/inference-and-deployment/saving-to-gguf
- Hugging Face skills:量化参考 — https://github.com/huggingface/skills/blob/main/skills/huggingface-local-models/references/quantization.md
- vLLM: GGUF — https://docs.vllm.ai/en/latest/features/quantization/gguf/
- vLLM: AutoAWQ — https://docs.vllm.ai/en/stable/features/quantization/auto_awq/
- vLLM RFC #30136(旧版量化格式)— https://github.com/vllm-project/vllm/issues/30136
- llm-compressor — https://github.com/vllm-project/llm-compressor
- llm-compressor:保存模型 — https://docs.vllm.ai/projects/llm-compressor/en/latest/guides/saving_a_model/
- Transformers:选择量化方法 — https://huggingface.co/docs/transformers/quantization/selecting
- Transformers:量化概念 — https://huggingface.co/docs/transformers/quantization/concept_guide
- Safetensors — https://github.com/safetensors/safetensors
- PyTorch Foundation: Safetensors — https://pytorch.org/projects/safetensors/
- Hugging Face Hub: MLX — https://huggingface.co/docs/hub/en/mlx
论文
- GPTQ(arXiv 2210.17323)— https://arxiv.org/abs/2210.17323
- GPTQ 官方代码(ICLR 2023)— https://github.com/ist-daslab/gptq
- AWQ(arXiv 2306.00978)— https://arxiv.org/abs/2306.00978
- AWQ(MLSys 2024)— https://proceedings.mlsys.org/paper_files/paper/2024/hash/42a452cbafa9dd64e9ba4aa95cc1ef21-Abstract-Conference.html
- QLoRA(arXiv 2305.14314)— https://arxiv.org/abs/2305.14314
- QTIP(arXiv 2406.11235)— https://arxiv.org/abs/2406.11235
库
- ExLlamaV2 — https://github.com/turboderp-org/exllamav2
- ExLlamaV3 — https://github.com/turboderp-org/exllamav3
- EXL3 格式说明 — https://github.com/turboderp-org/exllamav3/blob/master/doc/exl3.md
- GPTQModel — https://github.com/ModelCloud/GPTQModel
- AutoAWQ(已弃用)— https://pypi.org/project/autoawq/
- MLX-LM — https://github.com/ml-explore/mlx-lm
© 版权声明
文章版权归作者所有,未经允许请勿转载。