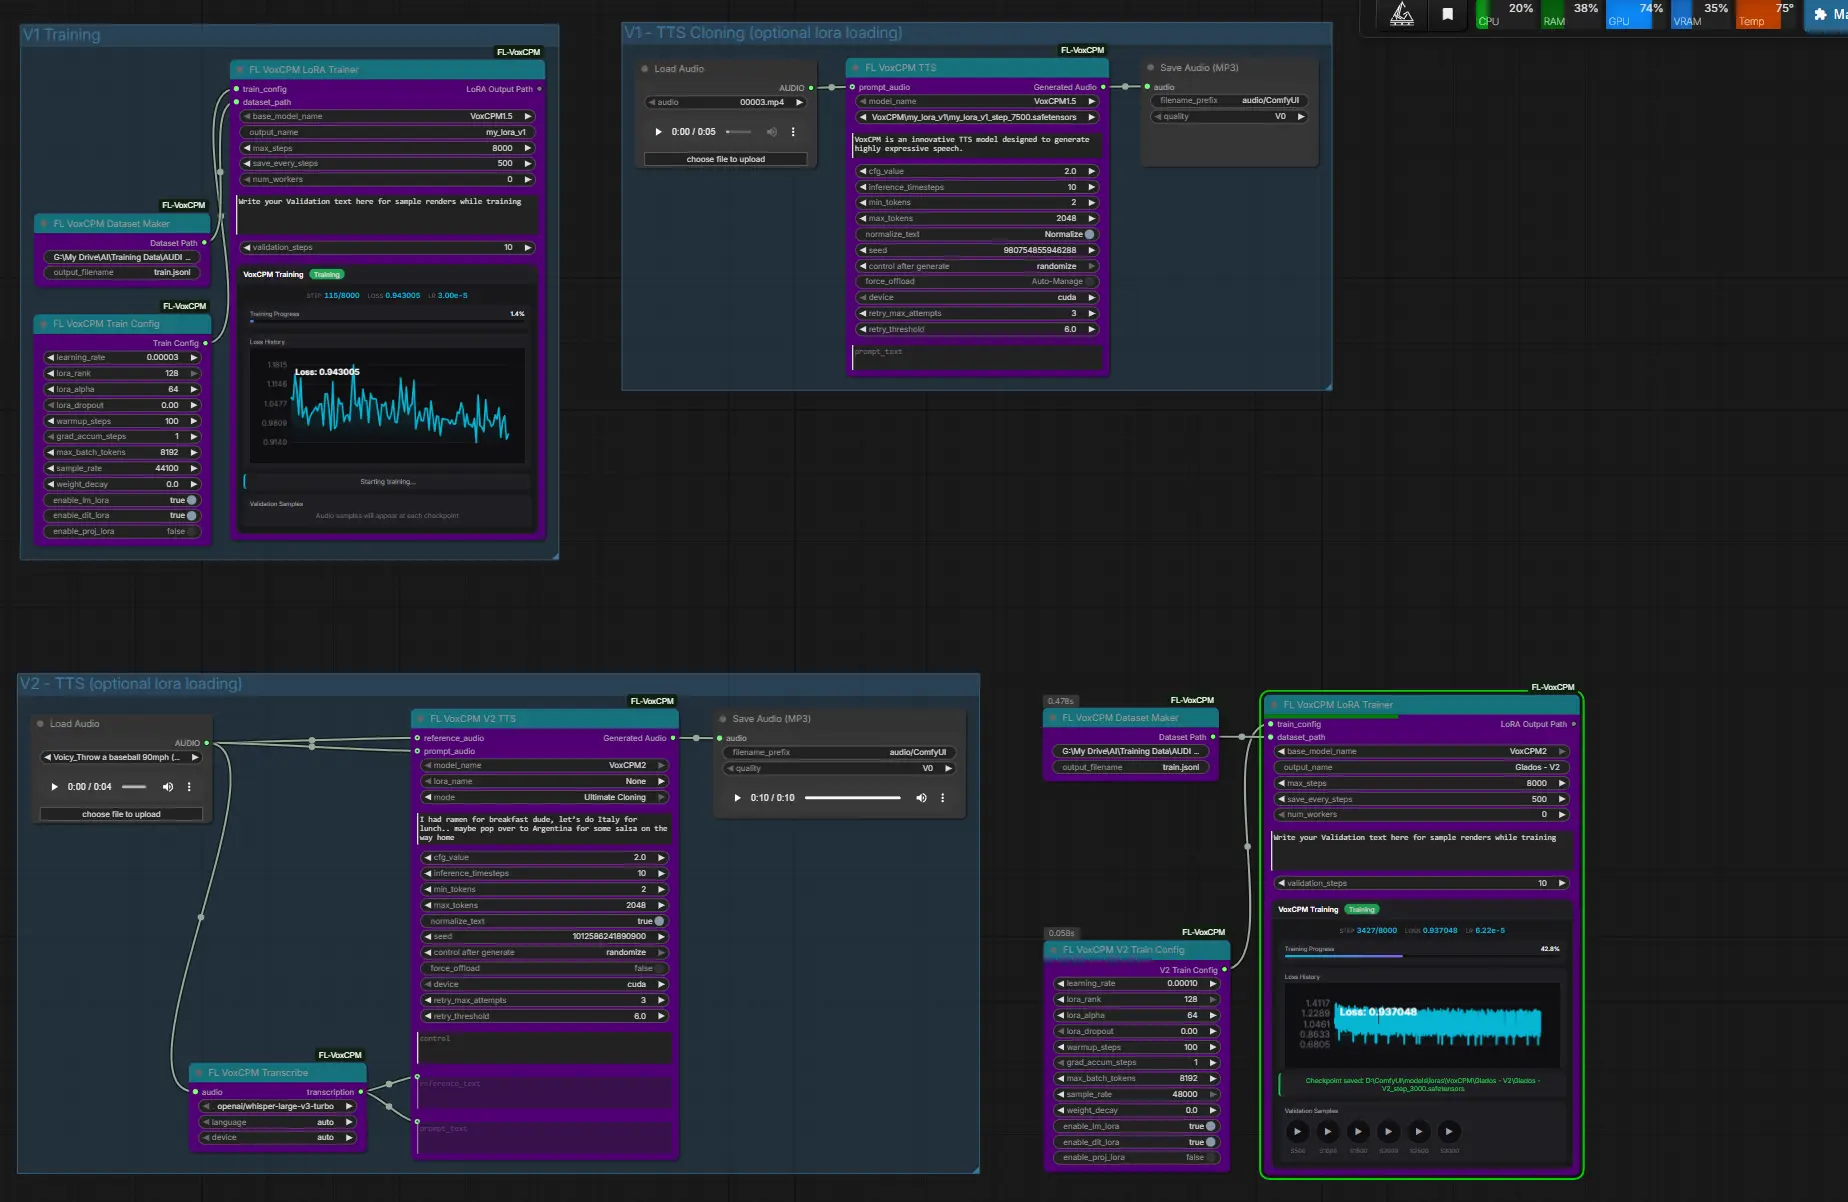
ComfyUI-YuE2-Trainer 是一个实验性的自定义节点包,允许用户在 ComfyUI 内部直接为 m-a-p/YuE2-3B 音乐生成模型训练 LoRA。
- GitHub:https://github.com/Starnodes2024/ComfyUI-YuE2-Trainer
通过这套工具,你可以使用自己的音乐文件(MP3/WAV/FLAC)训练模型,使其学习特定的乐器风格、编曲逻辑和人声音色。训练出的 LoRA 可以直接用于原生 YuE2 生成工作流,无需转换格式。
核心工作原理
YuE2 模型由三部分组成:AR 语言模型(规划)、NAR 流匹配分支(声学渲染)和 VAE。此训练器的工作流程如下:
- 编码缓存:将音频文件编码为 VAE 潜空间数据并缓存到磁盘(只做一次,节省显存)。
- 冻结 AR,训练 NAR:保持“作曲家”AR 分支冻结,仅在 NAR 分支上训练 LoRA。
- 文本条件驱动:使用检查点原生的文本前缀(如
[Tags] your_trigger_word, caption ...)作为条件,通过流匹配目标进行优化。 - 原生输出:生成标准的
*.safetensorsLoRA 文件,可直接被 ComfyUI 的LoraLoaderModelOnly节点加载。
⚠️ 注意:由于 AR 分支冻结且缺乏官方音频→令牌编码器,这主要是风格/音色 LoRA,而非完整的声音克隆或旋律复制。
安装与要求
硬件要求
- GPU:NVIDIA GPU,推荐 24 GB VRAM(已在 RTX 5090 Laptop 24GB 上测试)。
- 显存优化:如果 OOM,可降低
clip_seconds或使用adamw_8bit优化器。
软件依赖
- ComfyUI:Windows 便携版或 Easy-Install 均可。
- Python 包:
python_embeded\python.exe -m pip install soundfile matplotlib # 可选:bitsandbytes (用于 8-bit 优化器) - 模型文件:
- 下载
yue2_3b_bf16.safetensors(约 7.8 GB) 放入ComfyUI/models/checkpoints/。 - 必须使用 BF16 版本,INT8 量化版无法训练。
- 下载
安装步骤
cd ComfyUI/custom_nodes
git clone https://github.com/Starnodes2024/ComfyUI-YuE2-Trainer.git
# 重启 ComfyUI
使用方法
1. 准备数据集
- 创建一个文件夹,放入 5-30 首风格一致的音乐文件。
- 可选字幕:为每个音频文件创建同名的
.txt文件(如song.mp3对应song.txt),描述风格、乐器和人声。
2. 配置训练节点
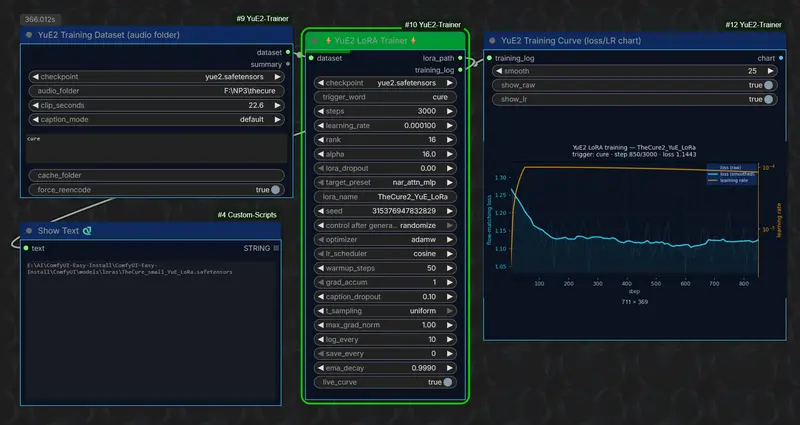
- YuE2 Training Dataset:
- 指向 YuE2 检查点和音频文件夹。
- 设置
clip_seconds(默认 10s,即 250 潜空间帧)。 - 节点会自动编码并缓存潜空间数据。
- YuE2 LoRA Trainer:
- 连接数据集输出。
- 设置
trigger_word(触发词,如mystyle)。 - 参数建议:
steps=3000,lr=1e-4,rank=32,alpha=32。 ema_decay=0.999(默认开启,使结果更稳定)。- 点击 Queue 开始训练。
3. 监控训练
- YuE2 Training Curve(可选):连接训练器的
training_log,实时查看损失曲线和学习率变化。
4. 生成音乐
- 使用原生 YuE2 生成工作流。
- 加载训练好的 LoRA (
LoraLoaderModelOnly)。 - 在提示词开头加入触发词:
mystyle, melancholic piano ballad, soft female vocals。 - 关键设置:在 YuE2 Request 节点中设置
cot = off(留空 ABC 输入),以匹配训练时的纯文本条件机制。
实用技巧与最佳实践
- 数据集质量:一致性比数量更重要。选择风格、配器和人声高度统一的歌曲。
- 防止过拟合:如果生成结果模糊或重复,尝试减少步数(如 2000)或降低学习率。
- 增强触发效果:如果触发词不起作用,适当增加步数或提高 Rank。
- A/B 测试:训练器会同时保存平滑权重 (
name.safetensors) 和原始权重 (name_raw.safetensors),方便对比效果。 - VRAM 管理:训练开始时,其他已加载的 ComfyUI 模型会被卸载以释放显存。
限制与警告
- 实验性质:训练目标是基于推理代码重建的,非官方发布代码。
- 非商业许可:YuE2 权重遵循 CC BY-NC 4.0 协议,仅限非商业用途。
- 独占 GPU:训练期间 GPU 将被独占,无法同时进行其他生成任务。
- 无旋律克隆:由于 AR 分支冻结,模型主要学习音色和风格,具体的旋律和歌词仍由提示词和随机种子控制。
示例工作流
仓库 example_workflows/ 提供了两个现成工作流:
01_yue2_lora_training.json:完整的训练流程。02_yue2_native_generate_with_lora.json:使用 LoRA 进行生成的标准流程。
对于希望定制专属 AI 音乐风格的创作者来说,ComfyUI-YuE2-Trainer 提供了一个强大且本地化的解决方案,让你能在自己的电脑上“教”会 AI 你的音乐品味。
© 版权声明
文章版权归作者所有,未经允许请勿转载。