ComfyUI-Qwen-VAE-Triton 是一款自定义节点,依赖Triton启用状态,通过自研Triton W8A8隐式GEMM内核,加速Qwen-Image、Wan VAE解码器内的CausalConv3d层。
- GitHub:https://github.com/AllenCraigBarnard/ComfyUI-Qwen-VAE-Triton
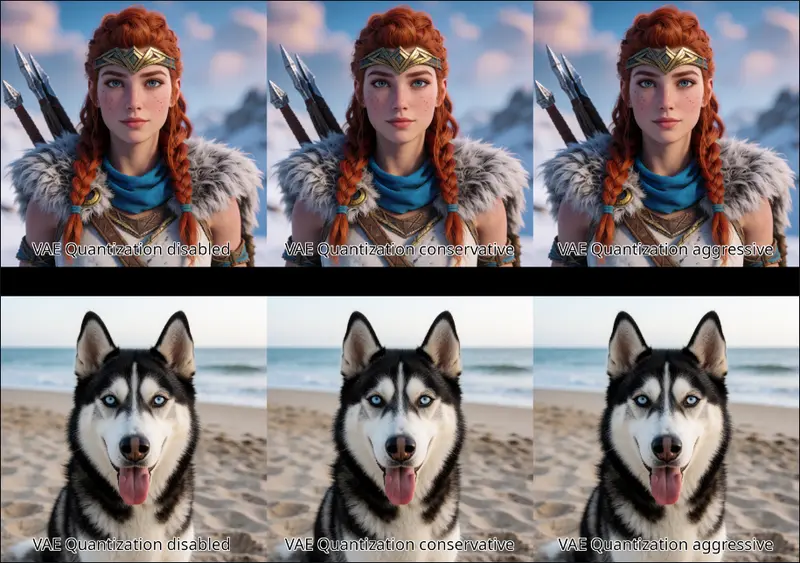
核心价值:专门改善VAE解码阶段耗时极高的痛点,尤其是工作流第一次启动、切换图像分辨率之后的慢速问题。GPU环境差异会显著影响加速效果,需要根据自身硬件调参,不要直接照搬其他显卡的配置。
v0.2.0版本采用经过预发布验证的混合精度Aggressive策略,界面做了精简,仅保留预设选择与节点总开关。
基准测试数据
测试工作流配置:
- UNet:
krea2_turbo_int8_convrot.safetensors - CLIP:
qwen3vl_4b_bf16.safetensors - VAE:
qwen_image_vae.safetensors - 采样步数:8步,固定种子208,Triton开启
场景1:首次运行,1024×1024
不启用加速节点(节点绕过)时,VAE解码阶段耗时257.675秒,完整工作流343秒。
| Preset | VAE阶段耗时 | VAE耗时降幅 | VAE加速倍数 | 完整工作流耗时 | 总耗时节省 | 端到端提升 |
|---|---|---|---|---|---|---|
| 节点绕过 | 257.675 s | — | 1.00× | 343 s | — | — |
| Conservative | 240.153 s | 6.8% | 1.07× | 327 s | 16 s | 4.7% |
| Balanced | 216.396 s | 16.0% | 1.19× | 301 s | 42 s | 12.2% |
| Aggressive | 208.415 s | 19.1% | 1.24× | 291 s | 52 s | 15.2% |
Aggressive模式亮点:首次1024×1024生成,整体工作流从343秒压缩至291秒,省下52秒,VAE阶段减少49.26秒。
场景2:切换分辨率,1024×1024 → 840×1256
节点绕过:VAE阶段222.573秒,完整工作流263秒。
| Preset | VAE阶段耗时 | VAE耗时降幅 | VAE加速倍数 | 完整工作流耗时 | 总耗时节省 | 端到端提升 |
|---|---|---|---|---|---|---|
| 节点绕过 | 222.573 s | — | 1.00× | 263 s | — | — |
| Conservative | 201.960 s | 9.3% | 1.10× | 242 s | 21 s | 8.0% |
| Balanced | 179.776 s | 19.2% | 1.24× | 220 s | 43 s | 16.35% |
| Aggressive | 179.447 s | 19.38% | 1.24× | 220 s | 43 s | 16.35% |
分辨率切换场景:Balanced、Aggressive最终耗时几乎持平,都节省43秒,端到端提升16.35%。Balanced保留更多原生精度解码器层,适合对画质敏感场景。
⚠️ 基准仅为该测试工作流结果,不同GPU、驱动、ComfyUI版本、模型,加速效果不能保证完全一致。
示例工作流
示例工作流文件路径:workflows/example_workflow.json,直接拖入ComfyUI加载。
工作流链路:VAE加载器 → Qwen VAE Triton补丁节点 → VAEDecode。示例默认选用Aggressive预设,使用前需要核对模型文件名与本地环境。
节点安装与GPU环境配置
1. 安装自定义节点
放到ComfyUI custom_nodes目录,目录结构:
ComfyUI/custom_nodes/ComfyUI-Qwen-VAE-Triton/
├── __init__.py
├── nodes.py
├── selection.py
├── triton_w8a8.py
└── README.md
安装完成重启ComfyUI。
Git克隆示例(ROCm7 Docker环境):
cd ~/ComfyUI-Docker/rocm7/storage-nodes/custom_nodes
sudo git clone [https://github.com/AllenCraigBarnard/ComfyUI-Qwen-VAE-Triton.git](https://github.com/AllenCraigBarnard/ComfyUI-Qwen-VAE-Triton.git)
sudo docker restart comfyui-rocm7
ZIP包部署示例:
sudo rm -rf ~/ComfyUI-Docker/rocm7/storage-nodes/custom_nodes/ComfyUI-Qwen-VAE-Triton
sudo mkdir -p ~/ComfyUI-Docker/rocm7/storage-nodes/custom_nodes/ComfyUI-Qwen-VAE-Triton
sudo unzip -q ~/Downloads/ComfyUI-Qwen-VAE-Triton-v0.2.0.zip \
  -d ~/ComfyUI-Docker/rocm7/storage-nodes/custom_nodes/ComfyUI-Qwen-VAE-Triton
sudo docker restart comfyui-rocm7
2. ComfyUI启动启用Triton
启动命令增加参数:--enable-triton-backend
python main.py --listen 0.0.0.0 --port 8188 --enable-triton-backend
Docker环境,把参数写入环境变量 CLI_ARGS=--enable-triton-backend。
验证Triton环境脚本:
import torch
import triton
print("PyTorch:", torch.__version__)
print("ROCm/HIP:", torch.version.hip)
print("Triton:", triton.__version__)
print("GPU:", torch.cuda.get_device_name(0))
ROCm环境不要随意替换PyPI的Triton安装包,必须使用适配PyTorch/ROCm版本的Triton构建。
3. GPU环境变量调优
GPU架构强相关,不要直接复制他人配置。调优步骤:
- 确认ROCm/PyTorch识别的GPU架构
- 查阅对应架构、ROCm版本官方文档
- 参考PyTorch ROCm分配器与TunableOp文档
- 单次只修改一组参数,修改前后做基准对比
- 删除无收益、会造成不稳定的环境变量
查询GPU架构命令:
rocminfo | grep -m1 -E 'Name:.*gfx'
Python查看GPU信息:
import torch
print(torch.cuda.get_device_name(0))
print("HIP:", torch.version.hip)
Strix Halo(gfx1151)参考环境变量(仅该硬件可用,不通用)
HSA_OVERRIDE_GFX_VERSION=11.5.1
HIP_VISIBLE_DEVICES=0
PYTORCH_TUNABLEOP_ENABLED=1
PYTORCH_TUNABLEOP_TUNING=1
PYTORCH_TUNABLEOP_VERBOSE=1
PYTORCH_ALLOC_CONF=expandable_segments:True,garbage_collection_threshold:0.9,max_split_size_mb:512
Docker Compose可以通过.env文件注入环境变量,不要硬编码到镜像。
4. 工作流接入方式
VAELoader
   │
   ▼
Patch Qwen VAE Triton W8A8
   │
   ▼
VAEDecode
节点输出原生ComfyUI VAE,无需替换VAEDecode。界面只有两个控件:预设选择、节点禁用开关。开启Disable Node可直通原始VAE,方便A/B对比测速。
三个预设详解
底层统一W8A8量化方案:权重对称INT8(按输出通道缩放),激活动态对称INT8;INT8×INT8计算,INT32累加,FP32重缩放,输出保持原有激活精度。
固定内部参数:激活裁剪比例1.0、权重裁剪比例1.0、开启channels_last、错误自动回退、逐层分析关闭。
- Conservative
仅量化最高层级解码器通道,测试Qwen VAE中修补28个Conv3d层里的15个。优先保证画质,加速幅度最小。适合对图像质量要求高,速度需求次要的场景。 - Balanced
量化最高两组通道层级,修补22个Conv3d层,保留底层96通道原生精度。速度与画质均衡,分辨率切换场景性能优秀。 - Aggressive
量化全部符合条件卷积层,仅跳过2个量化会引入明显噪点的U14层。共26层W8A8加速,2层保持原生精度。基准测试里首次生成速度最快。
排除固定规则:
decoder.upsamples.14.residual.2、decoder.upsamples.14.residual.6,强制保留原生精度,规避量化噪声。
© 版权声明
文章版权归作者所有,未经允许请勿转载。