ComfyUI-Breeze-TTS-2 是将开源语音大模型 Breeze-TTS-2 深度集成到 ComfyUI 工作流中的插件包。它不仅支持高质量的语音克隆和自然语言声音设计,还引入了强大的多说话人对话生成能力、内联语气事件控制以及针对显存优化的 INT8 量化构建。该插件旨在让创作者在可视化界面中轻松构建复杂、富有表现力且低延迟的语音内容。
- GitHub:https://github.com/Saganaki22/ComfyUI-Breeze-TTS-2
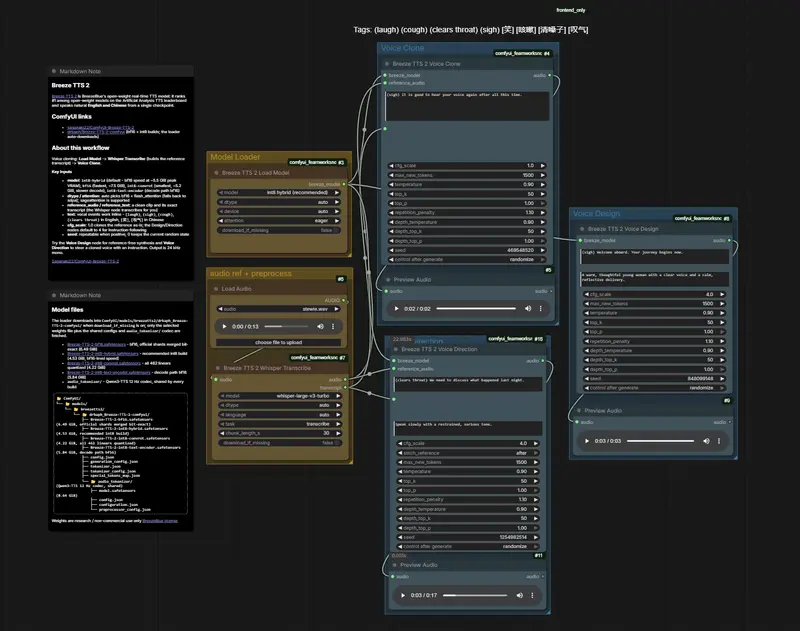
核心功能亮点
- 多样化声音生成模式:
- Voice Clone (声音克隆):通过参考音频及精确转写文本,高保真还原说话人音色(CFG 1.0)。
- Voice Design (声音设计):无需参考音频,仅凭自然语言描述(如“温暖平静的年轻女生”)即可创造全新声音(CFG 4)。
- Voice Direction (声音引导):在克隆基础上,通过指令实时调整情绪、语速和表达方式,支持将原始参考片段拼接到输出前后。
- 强大的多说话人对话系统:
- Multi-Speaker 节点:支持最多 8 个角色同时接入,一次性生成长篇对话脚本。
- 灵活脚本格式:支持纯文本(
名字: 台词)或 JSON 格式输入,兼容 LLM 直接生成的结构化数据。 - 智能校验与进度追踪:生成前自动校验角色名匹配,控制台实时显示每回合进度及总时长预估,避免无效计算。
- 细粒度语气控制:
- 支持在文本中直接嵌入非语言事件,如英文
(laugh)、(sigh)或中文[笑]、[叹气],让语音更具生命力。
- 支持在文本中直接嵌入非语言事件,如英文
- 极致性能与显存优化:
- INT8 ConvRot 量化:提供多种量化构建(Hybrid, All Linears, Text Encoder Only),在保持音质无损的前提下,显著降低显存占用(最低约 5.2 GiB)。
- AIMDO 动态显存管理:完整集成 ComfyUI 的 AIMDO 分页机制,支持与其他大型模型共存。
- CUDA Graphs 加速:可选
cuda_graphs解码模式,相比 Eager 模式提速 3-4 倍,适合生产环境批量生成。
节点详解
| 节点名称 | 主要用途 |
|---|---|
| Breeze TTS 2 Load Model | 加载检查点,支持 dtype (bf16/int8)、注意力后端 (flash/sage/sdpa) 及自动下载。 |
| Breeze TTS 2 Voice Clone | 基于参考音频和转录文本进行高保真克隆。 |
| Breeze TTS 2 Voice Design | 基于自然语言描述创建独特声音。 |
| Breeze TTS 2 Voice Direction | 克隆声音并施加情绪/语速指令,支持参考片段拼接。 |
| Breeze TTS 2 Whisper Transcribe | 辅助节点,为克隆提供精确的参考音频转录文本。 |
| Breeze TTS 2 Speaker | 定义单个说话人角色,支持从目录选择音频或连线输入,自动处理转录。 |
| Breeze TTS 2 Multi-Speaker | 核心对话节点,接收多个 Speaker 输入及脚本,生成连贯的多角色对话音频。 |
模型构建与性能对比 (RTX 5090 基准)
插件支持自动下载多种量化版本的模型至 ComfyUI/models/breezetts2/:
| 构建版本 | 文件大小 | 峰值显存 | 平均 RTF (实时因子) | 特点 |
|---|---|---|---|---|
| bf16 combined | 6.49 GiB | 7.51 GiB | 5.68 | 速度最快,官方分片合并,逐位一致。 |
| int8-hybrid | 4.53 GiB | 5.53 GiB | 5.64 | 推荐。主干+文本编码器 INT8,解码器 bf16,速度与 bf16 持平,显存降 27%。 |
| int8-text-encoder | 5.84 GiB | 6.82 GiB | 5.34 | 仅文本编码器 INT8,解码路径全 bf16,显存小幅降低。 |
| int8-convrot | 4.22 GiB | 5.21 GiB | 9.08 | 全线性层 INT8,显存最小,但因小矩阵 GEMM 开销导致速度显著变慢。 |
注:所有构建共用同一份 Audio Tokenizer (0.64 GiB) 及配置文件。
使用技巧
- 多角色脚本编写:
- 纯文本:每行
名字: 台词,支持 Markdown 加粗**名字:**。无名行自动并入上一说话人。 - JSON:适合 LLM 输出,支持
speaker/name/character等别名键。
- 纯文本:每行
- 语气事件嵌入:
- 确保指令语言与文本语言一致(英文用圆括号,中文用方括号)。
- 示例:
Ada: (sigh) 这次又是谁把我的船撞上码头了?
- 显存优化:
- 若需与其他大模型(如视频生成模型)并行,建议使用
int8-hybrid构建并开启 AIMDO。 - 若追求极致生成速度且显存充足,可使用
bf16配合decode_mode=cuda_graphs。
- 若需与其他大模型(如视频生成模型)并行,建议使用
- 参考音频建议:
- 长度建议在 20 秒以内(硬性上限 60 秒),确保转录准确且编码高效。
安装与要求
- ComfyUI 版本:需搭载 Transformers 4.57+ 或 5.3+。
- 依赖:
torch,torchaudio随 ComfyUI 自带;可选安装flash_attn或sageattention以获得更佳性能。 - 安装方式:通过 ComfyUI Manager 搜索
ComfyUI-Breeze-TTS-2或手动克隆至custom_nodes。
© 版权声明
文章版权归作者所有,未经允许请勿转载。