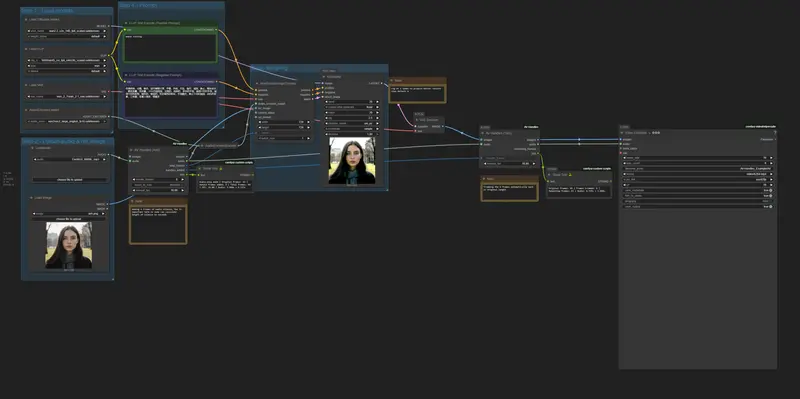
H3 Optimizations 是专为 MiniMax H3 模型设计的 ComfyUI 生产级优化插件包。它专注于解决 H3 在生成视频时的两大痛点:极高的显存占用和漫长的推理时间。通过引入内存分块、QKV 流式传输以及可选的视频稀疏注意力(Sparse Attention),该插件能在保持高质量输出的同时,显著降低硬件门槛并提升生成速度。
- GitHub:https://github.com/Zironic/H3-Optimizations
核心功能亮点
- 极致的显存优化 (H3 Memory Optimization):
- 通过分解大张量计算、提前释放临时数据(如嵌入组装张量)以及 QKV 流式传输,大幅降低峰值显存使用。
- 支持 MLP 和 FinalLayer 的分块处理,兼容多种注意力后端(SageAttention, Comfy Kitchen 等)。
- 建议:大多数用户只需添加此节点并保持默认设置,即可在不损失质量的情况下运行更大分辨率或更长时长的视频。
- 稀疏注意力加速 (H3 Sparse Attention):
- 通过减少视频到视频(Video-to-Video)的注意力计算量来加速生成。
- 默认采用 15% 的视频注意力预算,并结合“早期密集 ramp”策略(起始 50%,逐渐降至目标值),在保证场景建立阶段质量的同时实现显著加速。
- 支持多种后端自动选择:Native Kitchen INT8, Sparse Sage, BF16 Triton, FlexAttention 等。
- 精细控制与调试:
- AIMDO Residency Limiter:手动控制 DynamicVRAM 中保留的模型块数量,用于基准测试或极端低显存环境。
- Advanced Sparse Attention:允许独立调整早、中、晚阶段的注意力预算及后端选择,适合高级用户微调。
- 广泛的硬件支持:
- NVIDIA:支持 SM75 (Turing) 及以上架构,针对 Blackwell (SM120) 和 Hopper (SM90) 有专门优化。
- AMD (实验性):支持 RDNA 3/3.5 (gfx11) 和 RDNA 4 (gfx12),提供原生 HIP 内核;RDNA 2 (gfx103x) 通过适配器回退路径支持。
性能表现 (RTX 4070 12GB 基准)
在 1376×768 (1.0 MP) 分辨率下,相比标准的 Comfy Kitchen 密集注意力:
| 配置 | 5s 视频耗时 | 10s 视频耗时 | 显存节省 (5s / 10s) | 加速比 (5s / 10s) |
|---|---|---|---|---|
| 标准密集 (Baseline) | ~9m 24s | ~29m 40s | – | 1.0x |
| H3 Mem Opt + Sparse (30%) | ~6m 14s | ~15m 21s | 3.2 GB / 6.1 GB | 1.51x / 1.93x |
注:实测数据显示,稀疏注意力在长视频生成中优势更明显,且能显著降低显存峰值,避免 OOM。
节点使用指南
| 节点名称 | 用途 | 推荐设置 |
|---|---|---|
| H3 Memory Optimization | 降低显存占用 | 必选。保持默认 Auto 设置。 |
| H3 Sparse Attention | 加速生成 | 可选。若追求速度可添加,默认 15% 预算平衡性最佳。 |
| H3 Sparse Attention (Advanced) | 精细调整稀疏策略 | 仅高级用户使用,可调整 Early/Late 阶段预算。 |
| H3 AIMDO Residency Limiter | 控制模型驻留显存 | 仅用于调试或极端低显存场景,默认 0 blocks 为最大卸载。 |
安装与要求
- ComfyUI 版本:0.33.0 或更新版本。
- 安装方式:
cd ComfyUI/custom_nodes
git clone https://github.com/Zironic/H3-Optimizations
或通过 ComfyUI Manager 搜索
H3-Optimizations安装。 - 依赖:无需额外 Python 包,插件自带针对 Windows/Linux 的原生二进制文件(CUDA/HIP)。
注意事项
- 稀疏注意力的权衡:稀疏化会改变模型计算,可能导致提示遵循度、运动连贯性或细节的轻微损失。建议在重要项目中先进行小规模测试。
- 后端兼容性:若显式选择某后端(如 Sparse Sage)但系统不支持,节点会报错而非静默回退。普通用户建议使用标准节点的
Auto模式。 - AMD 支持现状:AMD 分支处于实验阶段,gfx11/gfx12 用户需确保 ROCm 环境正常;gfx103x 用户可能面临性能瓶颈或回退到密集模式。
© 版权声明
文章版权归作者所有,未经允许请勿转载。