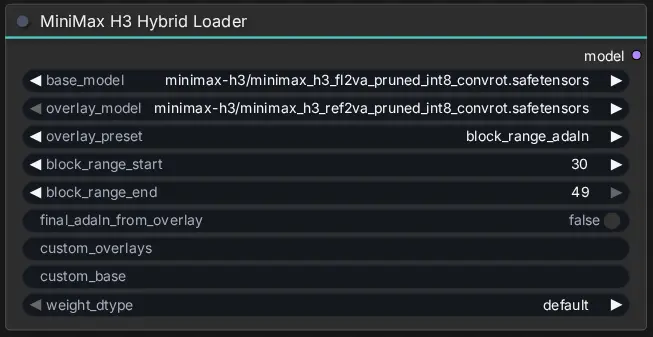
MiniMax H3 Audio T8 是面向 ComfyUI 原生 MiniMax H3 实现的独立节点扩展包(v1.3.2),注册14个节点,分为稳定音频工作流、实验性多速率采样、实验性静态语义编辑三类。核心能力包括:统一音画条件构建、音频锁定/重绘/参考/原生四模式控制、双时钟Turbo四步采样、Ref2VA单图+多图静态编辑、严格媒体标签校验及预检机制。项目无额外pip依赖,复用ComfyUI自带PyTorch/torchaudio及H3实现;兼容新旧两代音频速度协议,自动检测基模能力无需手动切换。画布上限放宽至1920×1088(2.09M像素),超旧0.98M档仅提示显存风险不阻断执行。所有节点遵循H3 latent契约,维护媒体展示顺序、标签编号、关键帧与噪声掩码的一致性。
- GitHub:https://github.com/T8mars/comfyui-minimax-h3-audio-T8
核心节点功能与稳定性分级
稳定节点(T8/MiniMax H3/Audio)
| 节点 | 核心用途 |
|---|---|
| Audio Conditioning (T8) | 统一T2VA/I2VA/FL2VA/L2VA/Ref2VA/Hybrid条件构建,中英双语task_type下拉,后端保持英文枚举兼容旧API |
| Audio Latent Control (T8) | 锁定或重绘已有AV latent中的源音频,保留视频mask |
| Duration Planner (T8) | 场景时间→24fps/17n+5渲染窗口+裁切参数换算 |
| Audio Window (T8) | 音频切取/补零,短场景自动扩展至124帧训练下限 |
| Prompt Tags (T8) | 规范化标签并严格校验编号连续性 |
| AV Decode (T8) | 分别调用视频/音频VAE解码联合latent |
| Audio Mix (T8) | 源音轨与生成音轨重采样、增益、ducking、峰值限制混合 |
| Output Trim (T8) | 同步应用Planner时间窗口到解码帧与音频 |
| Preflight (T8) | 采样前校验模型/尺寸/帧数/音频/参考数量/视频时长契约 |
| Dual-Clock Sampler (T8) | H3 Turbo四步专用:12/3 shift + 原生flow sigma + 双时钟Euler,替代SigmaShift/KSamplerSelect/scheduler三节点 |
实验节点
- Multi-Rate Sampler (EXP):视频宏步/音频微步联合采样(如4视频步+8/10音频步),计算量倍增,需对照验证
- Reference Image Edit (EXP):Ref2VA静态语义编辑,主图<Picture 1>+最多8张附加参考,支持direct_1_frame/micro_5/short_22/trained_124四种目标模式
- Still Preflight/Decode (EXP):单帧OOD检查、候选帧选择(1/5/22/124帧)
关键技术细节与实操约束
双时钟采样协议自适应
- 旧版ComfyUI:移除schedule slope,避免重复缩放
- 新版FLOW_AV/ModelSamplingAV:直接使用原始音频速度,audio_scale固定1.0
- 每步单次联合前向,latent更新时视频/音频分支独立积分,mask=0区域保留inpaint时钟
- 严禁再串联SigmaShift或外部scheduler;LoRA必须用LoraLoaderBypassModelOnly加载
音频四模式选择指南
| 模式 | 源音频角色 | 输出音频来源 | 适用场景 |
|---|---|---|---|
| lock_source | denoise mask=0锁定 | 原音轨 | 画面严格跟随音频,保留原声 |
| remix_source | 按strength重绘 | 模型改造音 | 保留节奏/语音结构,重塑音色 |
| reference_only | 语义/节奏参考 | 模型生成音 | 源音频仅提供风格指引 |
| native | 无输入 | 纯联合生成 | 无需参考的原创音画 |
Ref2VA静态编辑注意事项
- edit_image始终为<Picture 1>,附加图依次<Picture 2-9>;prompt需明确每张图职责
- default reference_strength=0.999接近原始噪声增强;降低可增大重绘幅度但可能损坏身份
- pruned INT8模型在<512px下结构崩坏,推荐canvas_mode=from_edit_image且短边≥512
- generate_and_discard生成短音频但不解码;lock_silence锁定零音频仅作对照
- 非mask/inpainting,未编辑区域像素不保证不变
H3硬性边界
- 固定24fps,帧数对齐17n+5;训练区间约124–362帧,区间外Preflight警告
- 画布≤1920×1088(2.09M像素),宽高32倍数;>1344×768(1.03M)提示显存风险
- batch size=1;引用上限9图/3视频/3音频;参考视频建议2–15秒
- Hybrid模式含PackedLayout运行时契约检查,上游结构变更会明确停止而非错位生成
部署、测试与显存验证
安装
# 放入custom_nodes目录,重启ComfyUI即可
cp -r minimax-h3-audio-T8 ComfyUI/custom_nodes/
无额外依赖;模型/VAE/CLIP/LoRA按需自行安装至标准目录。
自动化测试
$env:PYTHONPATH=(Get-Location).Path
python -m pytest -q .\custom_nodes\minimax-h3-audio-T8
验证节点注册、契约一致性、sigma数学、mask回调等;不等于感知质量保证。
显存诊断工具
tools/validate_h3_vram.py 用于排查DynamicVRAM/VBAR+旁路LoRA+双时钟组合下的OOM:
- 静态API工作流检查
- stock Euler vs 双时钟严格A/B对照
- 按节点/进度记录显存曲线
- 控制变量与峰值增量比较
实测参考(2026-08-07暖缓存)
0.6M像素/362帧/4步:stock Euler峰值16,213 MiB vs 双时钟16,182 MiB,PyTorch峰值均为14,573 MiB。未发现双时钟实质增加峰值,但已接近16GiB上限。单机结果不能替代用户精确工作流复测;未取得有效OOM traceback前,勿归因于双时钟节点或盲目替换INT8/关闭VBAR。
使用建议与风险提醒
- 生产工作流优先用稳定节点;EXP节点需相同seed/prompt/input做4/4对照后再决定是否采用
- 媒体编号严格遵循H3顺序:Picture → Video(其Audio标签在前)→ 独立Audio;统一Conditioning自动映射prompt_primary_audio_ordinal
- 短场景ensure_minimum_context不会漂移时间轴,prompt_timing_note标注真实起止,trim恢复请求时长
- API兼容性:task_type中文仅前端显示,后端仍用英文枚举;旧JSON无需修改
- 示例工作流位于examples/workflows/,API示例替换文件名即用;保存节点依赖VideoHelperSuite
© 版权声明
文章版权归作者所有,未经允许请勿转载。