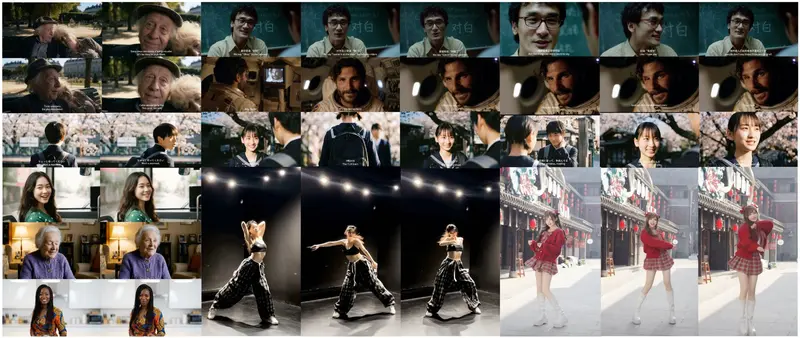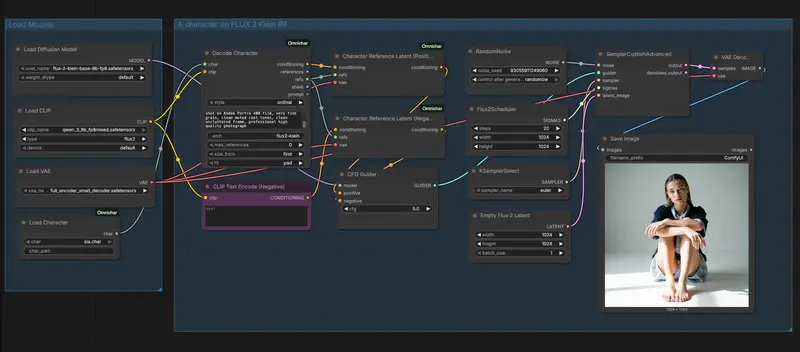
ComfyUI-MiniMaxH3-SingleFrame 是一套面向 MiniMax H3 的实验性 ComfyUI 自定义节点,专为类图像编辑工作流和首尾帧插值设计,而非通用视频生成。
- GitHub:https://github.com/tori29umai0123/ComfyUI-MiniMaxH3-SingleFrame
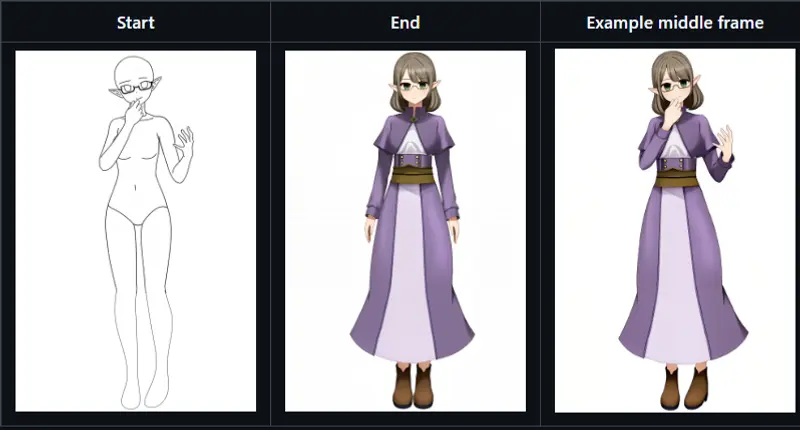
其核心能力包括:将输入图像锚定为第0帧生成短序列后提取单帧(静态编辑),或锚定首尾帧推断中间帧(姿势参考转角色设计等)。提供5个节点:Single Frame Edit、Start End Frame Interpolate、Temporal RoPE Patch、Empty Latent、Select Frame。帧数自动向上取整至满足 frame_count % 17 == 5(最小5帧)。Temporal RoPE Patch 可调节时间位置编码强度(0.0–1.0)以控制运动冻结程度,但属实验性功能,可能引入伪影。示例工作流需用户自行替换本地模型文件。
核心功能与工作流定位
该节点包明确区分于通用视频生成工具,聚焦两类精准场景:
1. 单帧图像编辑
- 机制:输入图像锚定在第0帧 → MiniMax H3生成短序列 → 提取指定帧
- 适用提示词:强调“场景不动、摄影机固定”,仅描述局部变化(如昼夜切换、表情调整)
- 关键参数:
keyframe模式将输入作为第0帧锚点;reference模式将其作为<Picture 1>参考条件 - 优势:相比纯图像编辑模型,可利用H3的时序理解实现语义级修改(如“从白天到夜晚”的光照连贯过渡)
2. 首尾帧插值
- 机制:
start_frame锚定第0帧,end_frame锚定frame_count-1→ H3推断中间帧 → 提取目标帧 - 适用提示词:分阶段描述转变过程(如“先摆姿势→再细化为角色设计”)
- 典型用途:姿势参考→角色设计、风格迁移中间态、动作分解关键帧生成
- 注意:需足够帧数支撑平滑过渡,建议≥22帧
帧数约束与Temporal RoPE Patch详解
帧数自动对齐规则
MiniMax H3要求帧数满足 frame_count % 17 == 5,节点自动向上取整:
| 请求值 | 实际值 | 说明 |
|---|---|---|
| 5 | 5 | 最小有效值 |
| 6–21 | 22 | 常见编辑/插值起点 |
| 22 | 22 | 推荐插值基准 |
| 23–38 | 39 | 更长过渡 |
若只需少量输出,生成5帧后用Select Frame提取即可,避免不必要计算。
Temporal RoPE Patch 使用指南
此补丁通过修改时间位置编码控制运动自由度,连接于UNET Loader之后、KSampler之前:
| strength | 效果 | 适用场景 |
|---|---|---|
| 0.0 | 正常H3行为 | 首尾插值、真实时间变化 |
| 0.25 | 轻微运动抑制 | 插值防塌缩、微调 |
| 0.5 | 平衡冻结与动态 | 一般编辑 |
| 0.75 | 强冻结 | 静态编辑备选 |
| 1.0 | 完全固定到选中帧 | 纯图像编辑(默认) |
风险与缓解
- 潜在伪影:涂抹、重复纹理、构图错误(因改变训练时的时间布局)
- 调试策略:从1.0开始测试静态编辑;若出现伪影,逐步降至0.75/0.5;无效则设0.0禁用
- 插值专用:首尾帧插值建议0.0–0.25,过高会导致向端点塌缩或僵硬
部署与实操注意事项
安装与工作流配置
- 克隆仓库至
ComfyUI/custom_nodes/ - 加载示例工作流(
example_workflows/下两个JSON) - 必须手动替换:UNET、CLIP、VAE路径及输入图像文件名指向本地MiniMax H3文件
sample/目录含测试用输入图像,可用于验证流程
关键限制
- 非通用视频工具:不适用于长视频生成、复杂叙事或多镜头序列
- 实验性质:Temporal RoPE Patch未充分验证,生产环境慎用
- 模型依赖:仅兼容MiniMax H3,其他模型无效
- 无核心修补:不修改H3原始代码,所有操作通过外部节点实现
- 帧数下限:无法生成<5帧序列,需接受最小开销
最佳实践建议
- ✅ 静态编辑优先试
strength=1.0+keyframe模式 - ✅ 插值任务从
strength=0.0+ 22帧起步,按需调整 - ✅ 使用
Select Frame精细控制输出帧,避免盲目增加frame_count - ❌ 勿在插值中使用高strength值,除非明确需要刚性过渡
- ❌ 勿期望替代专业图像编辑器,H3擅长语义级修改而非像素级精修
该节点包代表了AI视频模型向“可控图像编辑”延伸的探索:利用视频生成的时序理解力解决静态编辑中的语义连贯难题。但其实验性意味着使用者需承担调参成本与失败风险。
© 版权声明
文章版权归作者所有,未经允许请勿转载。