在企业级自动语音识别(ASR)领域,开发者常面临两难选择:要么使用计算量巨大的高精度模型,要么为了控制预算而牺牲准确性。
IBM 发布的 Granite Speech 4.1 2B 系列模型,这套包含两个主要变体(及一个 Plus 变体)的开源模型,均基于约 20 亿参数规模,采用 Apache 2.0 许可证发布。它通过精心的架构设计,在保持高准确率的同时,实现了极致的推理速度,为生产环境提供了极具竞争力的解决方案。
- Granite-Speech-4.1-2B:https://huggingface.co/ibm-granite/granite-speech-4.1-2b
- Granite-Speech-4.1-2B-NAR:https://huggingface.co/ibm-granite/granite-speech-4.1-2b-nar
核心模型概览
1. Granite Speech 4.1 2B (自回归 AR)
- 定位:全能型选手,兼顾精度与功能丰富性。
- 功能:支持 6 种语言(英、法、德、西、葡、日)的 ASR,以及双向自动语音翻译 (AST)。支持关键词偏向识别、标点符号和大小写还原。
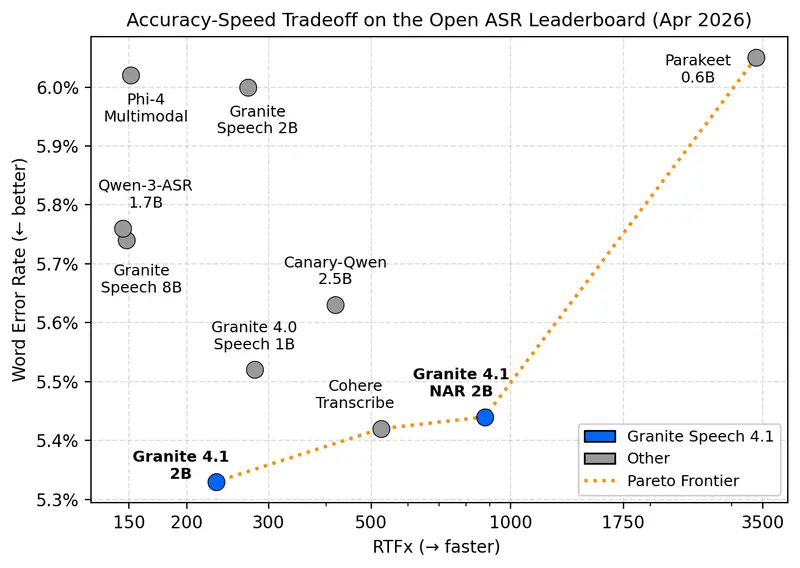
- 性能:在 Open ASR 排行榜上平均 WER (词错误率) 为 5.33。在 LibriSpeech clean 上 WER 低至 1.33。
- 适用场景:需要日语支持、语音翻译或最高转录精度的应用。
2. Granite Speech 4.1 2B-NAR (非自回归 NAR)
- 定位:极速推理专家,专为低延迟部署设计。
- 功能:支持 5 种语言(英、法、德、西、葡),不支持日语和 AST。
- 性能:采用非自回归编辑架构,在单个 H100 GPU 上批量推理时,RTFx (实时因子) 高达 ~1820,速度极快。
- 适用场景:对延迟极度敏感、无需日语/翻译功能的实时转录场景。
3. Granite Speech 4.1 2B-Plus (隐藏彩蛋)
- 新增功能:在标准模型基础上,增加了说话人归属 (Speaker Attribution) 和 词级时间戳。
- 适用场景:会议记录、访谈整理等需要区分说话人和精确时间定位的应用。
架构解析:三组件高效设计
Granite Speech 4.1 采用统一的三组件架构,但在解码机制上有所区分:
- 语音编码器 (Speech Encoder):
- 16 层 Conformer 块,通过 CTC 训练。
- 双分类头(字素级 + BPE 单元),结合帧重要性采样,聚焦音频关键信息。
- 模态适配器 (Modal Adapter):
- 2 层窗口查询变换器 (Windowed Q-Former)。
- 将声学嵌入下采样 10 倍,生成 10Hz 的声学嵌入序列,供 LLM 处理。
- 语言模型 (Language Model):
- AR 版本:基于微调后的
granite-4.0-1b-base,支持 128k 上下文,自回归生成文本。 - NAR 版本:1B 参数的双向 LLM 编辑器,通过单次前向传递编辑 CTC 假设,实现并行解码。
- AR 版本:基于微调后的
自回归 vs 非自回归:如何抉择?
| 特性 | Granite Speech 4.1 2B (AR) | Granite Speech 4.1 2B-NAR (NAR) |
|---|---|---|
| 解码方式 | 自回归 (逐 Token) | 非自回归 (并行编辑 CTC 假设) |
| 推理速度 | 较慢 (顺序依赖) | 极快 (RTFx ~1820 on H100) |
| 支持语言 | 6 种 (含日语) | 5 种 (无日语) |
| 语音翻译 | ✅ 支持 | ❌ 不支持 |
| 关键词偏向 | ✅ 支持 | ❌ 不支持 |
| 依赖后端 | 通用 | 需 flash_attention_2 |
| 训练成本 | 30 天 (8x H100) | 3 天 (16x H100) |
💡 建议:若需日语或翻译功能,选 AR;若追求极致速度且仅需主流欧洲语言,选 NAR。
训练数据与效率
- AR 模型:在 174,000 小时 音频上训练,涵盖公共语料库及合成数据(支持日语/关键词偏向)。
- NAR 模型:在 130,000 小时 公开数据集(CommonVoice, LibriSpeech, etc.)上训练,仅 5 个 epoch,体现了编辑架构的高效性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。