在视频创作中,后期配音和音效制作往往是最耗时且最考验专业技能的环节。现有的 AI 视频生成音频(V2A)工具虽然能自动配声,但常面临两大难题:
- “不听指挥”:当文字描述与画面内容冲突时,AI 往往忽略文字,只根据画面生成声音。
- “顾此失彼”:若想参考某段音频的音色,生成的声音往往会打乱与画面的节奏同步。
来自小米 MiLM Plus 团队的 ControlFoley 正式亮相。这是一个统一且可控的多模态视频生成音频框架,旨在通过视频、文本及参考音频实现对音频生成的精准控制。它不仅解决了模态冲突和音色同步难题,还发布了首个专门评估“文字-画面冲突配声效果”的数据集 VGGSound-TVC。
- 项目主页:https://yjx-research.github.io/ControlFoley_web_page/
- GitHub:https://github.com/xiaomi-research/controlfoley
- 模型:https://huggingface.co/YJX-Xiaomi/ControlFoley
- Demo:https://yjx-research.github.io/ControlFoley_web_page/#try-gen
核心功能:全能配声,精准可控
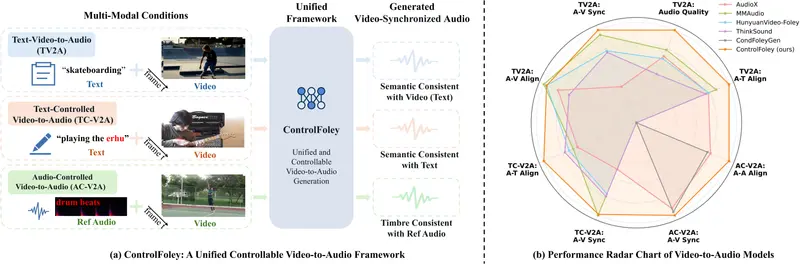
ControlFoley 支持多种输入组合,满足从自动化到精细化的不同需求:
1. 文本引导的视频生成音频 (TV2A)
在文本引导下,自适应视频内容生成配音与同步音效。既看画面,也听指令。
2. 文字强控制配声 (TC-V2A)
解决冲突难题:当文字描述与画面不一致时(例如画面是晴天,文字要求“雨声”),ControlFoley 能优先服从文字指令,生成语义一致且时序同步的声音。
3. 参考音色控制配声 (AC-V2A)
解决音色难题:上传一段参考音频,模型仅提取其音色特征(如乐器类型、人声质感),而忽略其节奏信息,确保生成的声音既像参考音频,又完美贴合视频节奏。
4. 纯文本生成音频 (T2A)
作为统一框架的附加功能,支持直接从文本提示生成高质量音频。
为什么 ControlFoley 更强大?
✅ 冲突不翻车:鲁棒的多模态平衡
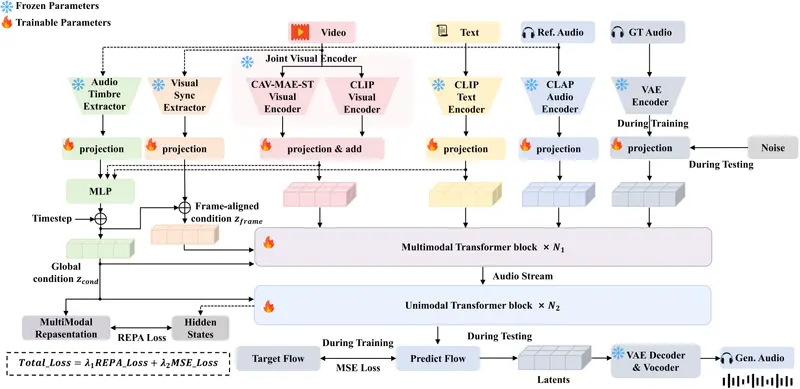
传统模型在模态冲突时容易“死机”或偏科。ControlFoley 通过联合视觉编码(结合 CLIP 与 CAV-MAE-ST 表征),同时捕捉“视觉-文本”和“视觉-听觉”关联,确保在文字与画面矛盾时,仍能稳定服从文字指令,且不影响音画同步。
✅ 音色节奏分离:只学音色,不学节奏
这是 ControlFoley 的核心创新之一。它通过算法将参考音频中的全局音色表征与时序节奏信息解耦。
- 结果:你可以用一段钢琴曲作为参考,让 AI 为打斗视频生成具有“钢琴质感”的打击音效,而不会错误地沿用钢琴曲的旋律节奏。
✅ 全能统一:一个模型搞定所有
无需在多个专用模型间切换。无论是缺文字、缺参考音频,还是全都有,ControlFoley 都能基于统一架构稳定输出高质量声音。
✅ 科学评测:首发 VGGSound-TVC 数据集
团队构建了 VGGSound-TVC,这是业界首个专门用于评估“视觉-文本语义冲突下文本可控性”的基准数据集,让效果对比更加公平、科学。
工作原理:四步实现精准控制
- 双重视觉理解:模型同时理解“画面与文字的关系”以及“画面与声音的关系”,避免单一依赖导致的偏差。
- 音色节奏拆分:从参考音频中剥离节奏干扰,仅提取纯净的音色特征。
- 鲁棒训练:采用全模态随机丢弃机制,在训练时随机屏蔽文字、视频或参考音频,强迫模型不依赖任何单一输入,提升稳定性。
- 统一对齐:将画面、文字、音色信息整合到统一的表征空间,确保生成的声音同时满足所有约束条件。
测试结果:全面领先
在多项权威测试和人机评测中,ControlFoley 表现卓越:
- 三项任务 SOTA:在 TV2A、TC-V2A、AC-V2A 任务上均取得最优成绩。
- 冲突场景稳定:在文字与画面严重冲突时,依然能按文字生成声音,同步性几乎不受影响。
- 音色相似度高:参考音频控制下的音色相似度显著提升,且未破坏音画同步。
- 超越工业级系统:在可控性、同步性、音质上全面超越现有工业级配声系统。
© 版权声明
文章版权归作者所有,未经允许请勿转载。