Sapiens2 是 Meta AI 最新推出的一系列以人为中心的计算机视觉模型。它在 10 亿张高质量人类图像上进行了预训练,旨在解决传统人体视觉模型在细节还原与语义理解之间难以兼顾的痛点。Sapiens2 能够原生处理高达 4K 的分辨率,精准捕捉从发丝到衣物褶皱的细微几何与纹理细节,刷新了姿态估计、分割及三维重建等多项任务的行业基准。
- GitHub:https://github.com/facebookresearch/sapiens2
- 模型:https://huggingface.co/collections/facebook/sapiens2
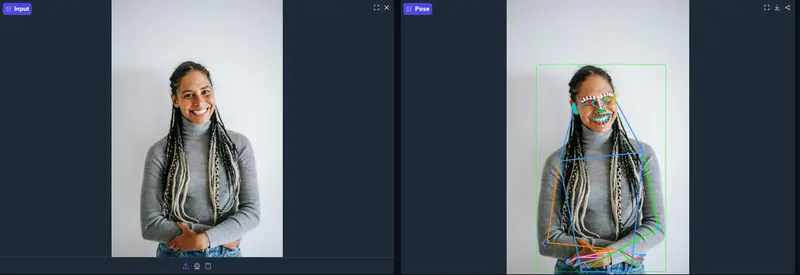
核心功能:全能人体解析
Sapiens2 不仅仅是一个识别模型,更是一个深度的人体几何与外观解析引擎:
- 高精度姿态估计:精准定位全身 308 个关键点,涵盖面部表情、手部关节及躯干细微动作。
- 像素级部位分割:将人体细分为 29 类区域(如头发、五官、四肢、饰品等),实现毫厘必争的语义分割。
- 三维点位估算 (Point Map):还原图像中每个像素点在 3D 空间中的确切位置,构建精准的人体深度图。
- 表面法线预测:捕捉皮肤、衣物及毛发的表面朝向,清晰呈现皱纹、褶皱等几何细节。
- 反照率估算 (Albedo):剥离光照影响,还原人体皮肤与衣物的真实底色,适用于各种光照环境。
主要特点与优势
1. 细节与语义的双重突破
- 双能力合一:既具备像素级的细节感知力(如发丝、纹理),又拥有全局的语义理解力(如肢体结构、遮挡关系)。
- 分层注意力架构:先局部捕捉微观细节,再全局整合宏观结构,避免“只见树木不见森林”。
2. 原生支持超高清分辨率
- 1K – 4K 处理能力:不同于以往仅能处理低分辨率输入的模型,Sapiens2 高阶版本可直接处理 4K 图像,确保在超高清场景下依然保持极高的精度。
3. 海量数据预训练
- 10 亿张图像基石:基于规模空前的人类图像数据集进行预训练,覆盖了 diverse 的人群、姿态、光照及复杂背景,泛化能力极强。
4. 全面领先的精度
- 姿态识别:最大模型准确率达 82.3%,比上一代提升 4%。
- 部位分割:像素精度提升 24.3%,能精准区分嘴唇、牙齿、耳环等微小区域。
- 表面法线:角度误差减少 45.6%,对面部皱纹和衣物褶皱的捕捉达到新高度。
工作原理:重建 + 对比
Sapiens2 通过两种核心学习模式实现其强大能力:
- 遮罩重建学习 (Masked Reconstruction):
- 随机遮蔽图像部分区域,迫使模型根据上下文还原被遮挡的人体细节。这锻炼了模型对局部纹理和结构的精细感知能力。
- 对比蒸馏学习 (Contrastive Distillation):
- 让模型从不同角度、不同光照下观察同一个人,学会忽略环境干扰,抓住人体的本质特征(如身份、结构)。
此外,模型采用轻量化任务头设计,主干网络保持不变,仅通过替换专用的轻量级模块即可适配姿态、分割、法线等不同任务,极大提高了部署效率。
模型系列与参数
Sapiens2 提供了从轻量到超大规模的多种型号,以适应不同的算力需求:
| 模型名称 | 参数量 | 特点 | Hugging Face 仓库ID |
|---|---|---|---|
| Sapiens2-0.1B | 0.114 B | 轻量级,适合移动端或实时应用 | facebook/sapiens2-pretrain-0.1b |
| Sapiens2-0.4B | 0.398 B | 平衡性能与速度 | facebook/sapiens2-pretrain-0.4b |
| Sapiens2-0.8B | 0.818 B | 中等规模,通用性强 | facebook/sapiens2-pretrain-0.8b |
| Sapiens2-1B | 1.462 B | 高性能标准版 | facebook/sapiens2-pretrain-1b |
| Sapiens2-1B (4K) | 1.607 B | 专为 4K 超高清输入优化 | facebook/sapiens2-pretrain-1b-4k |
| Sapiens2-5B | 5.071 B | 旗舰版,精度最高 | facebook/sapiens2-pretrain-5b |
© 版权声明
文章版权归作者所有,未经允许请勿转载。