Meta 正式推出 Muse Ember,这是其当前体量最小、运行效率最高的模型,定位面向智能体高频重复的复杂推理任务,覆盖工具调用、编码子任务、请求路由、信息提取以及长文档解析场景。
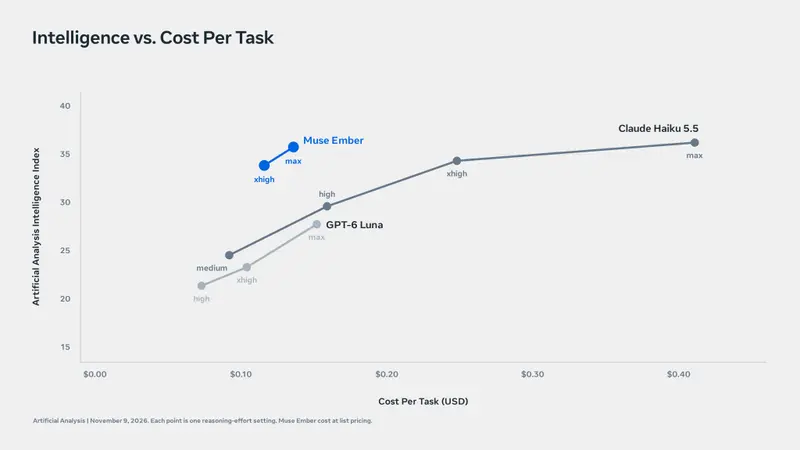
在同等推理部署条件下,Muse Ember 的单位成本产出优于 Claude Haiku 5.5 与 GPT-6 Luna。它以约三分之一的成本达到 Haiku 的最优评测分数,同时在所有配置下得分超过 Luna。在 Artificial Analysis 榜单上,该模型处于效率前沿区间,不存在同榜单内单位任务成本更低、得分更高的竞品。完整评估细节可查阅官方配套报告。
Muse Ember 现已上线 Meta Model API,定价为每百万输入 token 0.10 美元,每百万输出 token 0.50 美元。早期合作测试中,合作方已经将其用于合同审核、代码编写这类智能体高频任务。
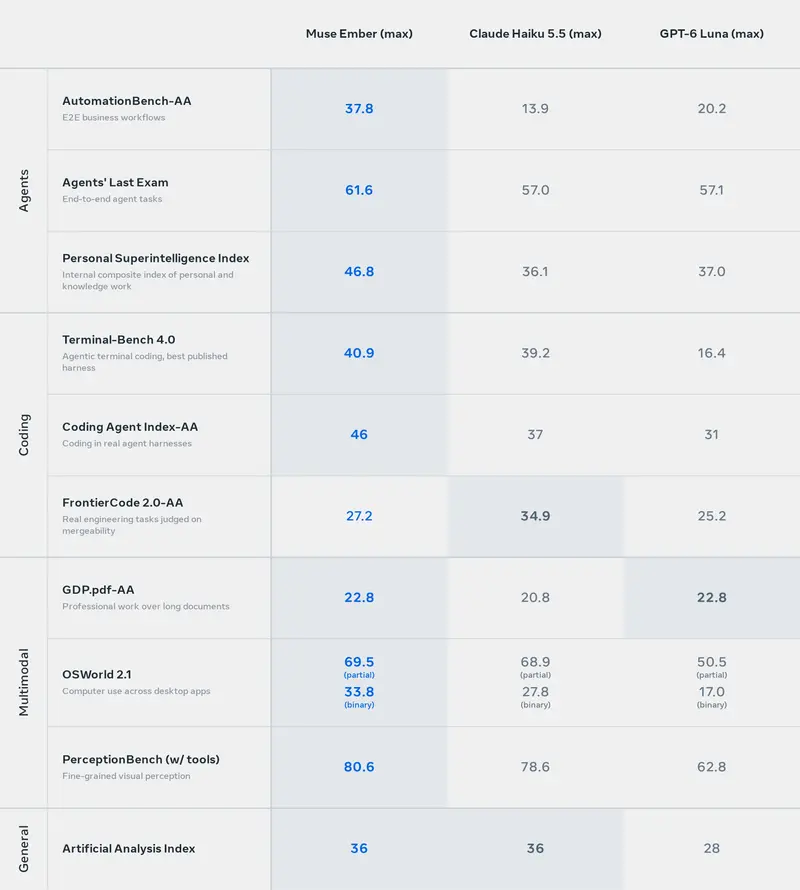
面向智能体工作流设计
智能体的 token 消耗大多分散在大量细碎、结构化的步骤中,Muse Ember 的架构设计针对这一特征优化。它可以端到端承接业务流程,完成数据拉取、按序调用工具、跨应用系统更新等动作。
模型上下文窗口上限为 100 万 token,单次调用最高支持 512K token 输出,能够一次性载入完整代码库或是整套文档合集。
编码场景
Muse Ember 适配智能体会话里反复执行的编码子任务,例如读取源码文件、执行测试、针对性代码修复。
遇到高难度问题时,可以搭配 Muse Wonder 组合使用:由 Muse Wonder 负责任务规划,Muse Ember 承接大批量执行工作。
多模态能力
Muse Ember 原生支持文本、图像、音频、视频输入。智能体可直接读取截图、图表、扫描件,也可以基于语音备忘录、会议录音、视频内容开展工作,无需额外调用独立模型。它能够处理篇幅较长的现实文档、基于截图完成计算机操作,识别精细的视觉细节。
安全评估
上线前,Meta 在 Meta Superintelligence Scaling Framework 框架下完成对 Muse Ember 的安全测评,测评范围包含化学生物风险、网络安全风险、模型失控风险。在所有测评维度中,结果均低于框架设定的高风险阈值。
尽管属于小体量模型,它采用和大模型一致的核心安全训练与测试流程。团队同时评估了它代用户执行操作时的行为表现,校验模型是否遵从用户意图、妥善处理敏感信息、抵御嵌入在网页、文档、工具返回内容里的劫持指令,以及在高风险操作前主动请求人工确认。
上线信息与产品矩阵
Muse Ember 以 muse-ember-1.0 标识,同步在 Muse Code 与 Meta Model API 开放调用,支持 Responses API。
完整定价:
- 每百万输入 token:0.10 美元
- 每百万缓存输入 token:0.004 美元
- 每百万输出 token:0.50 美元
它是首个基于 Muse Wonder Full 蒸馏训练得到的模型,补齐 Meta 的 Muse 模型产品线:
- Muse Wonder:应对高难度复杂问题
- Muse Spark:编码、智能体工作流
- Muse Ember:大规模重复编码与智能体任务,单 Artificial Analysis 任务成本约 0.14 美元,成本水平可嵌入各类产品规模化落地
| ARTIFICIAL ANALYSIS | Muse Ember(最大配置) | Muse Spark 1.3(最大配置) |
|---|---|---|
| 智能指数 | 36 | 37 |
| 每智能指数任务成本 | 0.14 美元 | 2.39 美元 |
| 每百万输入/输出token定价 | 输入0.10美元 / 输出0.50美元 | 输入1.25美元 / 输出4.25美元 |
Meta 的长期方向是打造面向个人的超级智能模型,辅助用户完成目标、创作、信息处理。而普惠落地,除能力本身之外,低成本可规模化是必要条件。官方同时透露,还有效率更高的模型正在训练中。
© 版权声明
文章版权归作者所有,未经允许请勿转载。