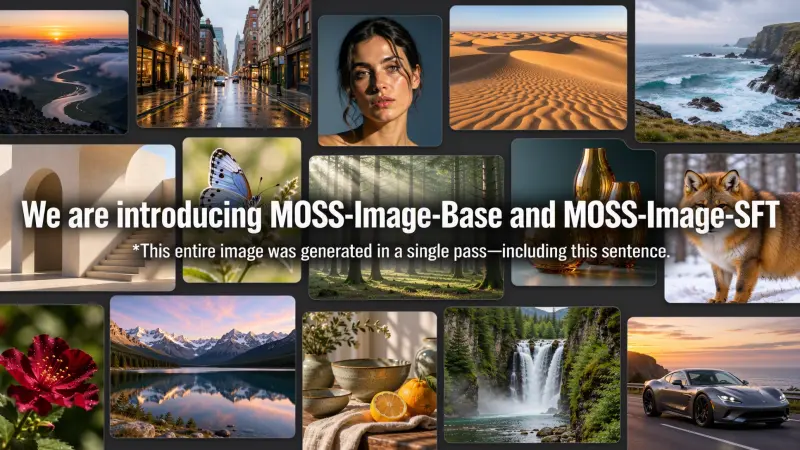
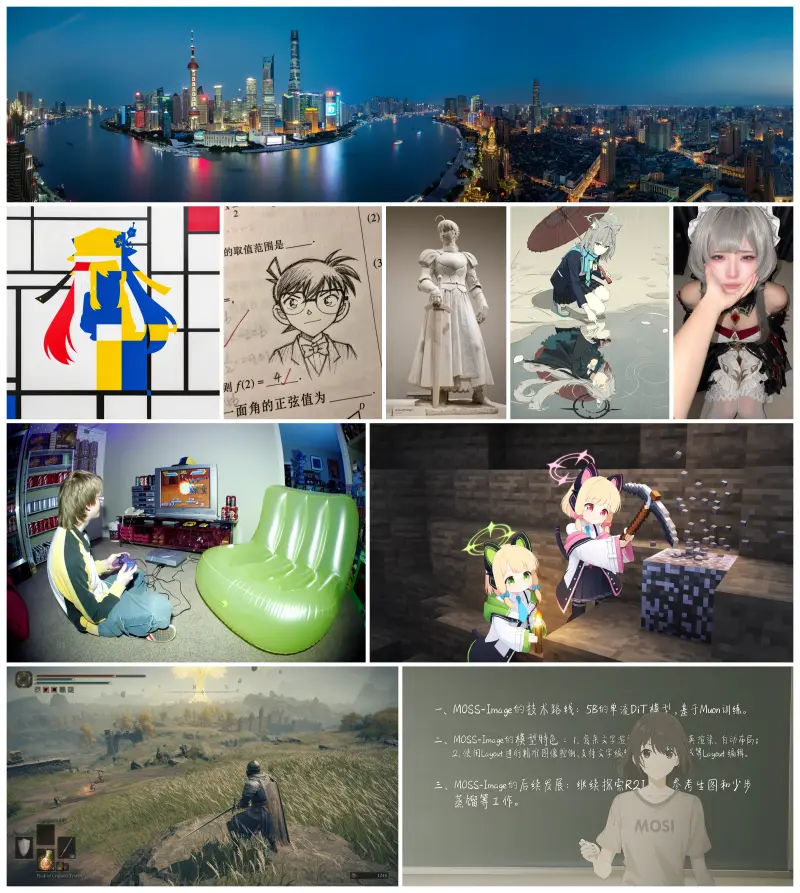
OpenMOSS 推出 MOSS-Image 文生图模型系列,包含基础版 MOSS-Image-Base 和精选数据微调版 MOSS-Image-SFT,权重与代码开源,Apache-2.0许可证。
- GitHub:https://github.com/OpenMOSS/MOSS-Image
- MOSS-Image-Base:https://huggingface.co/OpenMOSS-Team/MOSS-Image-Base
- MOSS-Image-SFT:https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
- 魔搭:https://modelscope.cn/collections/openmoss/Moss-Image
- ComfyUI:https://github.com/OpenMOSS/MOSS-Image/blob/main/comfyui/README_ZH.md
- ComfyUI模型:https://huggingface.co/Comfy-Org/MOSS-Image
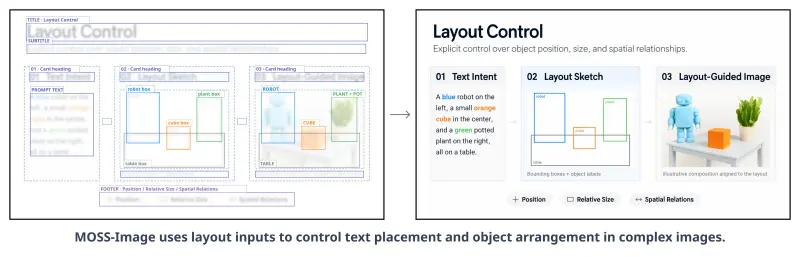
模型采用5B紧凑骨干网络,最大支持4K token超长提示词,亮点是原生JSON布局控制,可以用边界框定义画面物体、内嵌文字的位置与大小,同时具备优秀的图像内文字渲染能力,支持动漫、照片写实两类主流风格,基于Diffusers管道,提供Python与Gradio接口。
核心能力
- 基础文生图:自然语言提示直接生成图像,Base与SFT两个权重共用同一套推理接口。
- 原生结构化布局控制:通过JSON格式描述画面元素,使用边界框定义每个对象、画面文字的坐标与尺寸;可修改元素描述、位置框实现图像受控编辑,适合海报、UI、多元素构图类创作。
- 长提示支持:最高4K tokens输入,能够承载复杂场景描述、多物体设定。
- 高质量图像文字渲染:可以在画布内生成清晰准确的文字,解决很多文生图模型写文字乱码的痛点。
- 风格覆盖:同时支持动漫风格与照片级写实图像生成。
- 易于微调:5B骨干算力门槛更低,支持针对行业、自定义领域做二次微调;训练阶段采用异构GPU集群。
两个模型版本
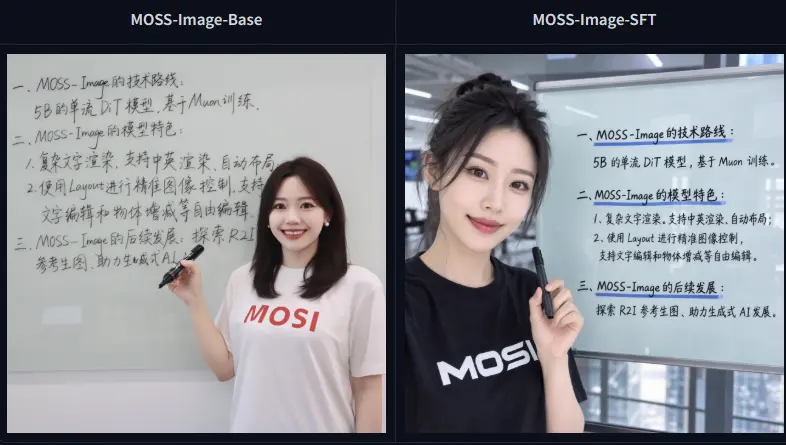
| 模型 | 说明 |
|---|---|
| MOSS-IMAGE-BASE | 基础文生图模型 |
| MOSS-IMAGE-SFT | 在精选数据集上,基于Base微调得到 |
配套工具:MOSS-Image Prompt Enhancer
面向GPT-6系列Agent的专用Skill,作用是把简单创作想法,自动扩写成详细文本提示,或是生成带空间坐标的布局JSON。附带脚本可将手绘像素草稿转换为标准居中坐标JSON,只做提示词预处理,不调用图像生成。
使用流程:
- 将技能文件夹部署到Agent的skills目录;
- 调用
$moss-image-prompt-enhancer,输入创作想法、画布尺寸、布局要求; - 输出的提示或JSON直接送入MOSS-Image生成图像;布局生成时画布尺寸要和草稿保持一致。
© 版权声明
文章版权归作者所有,未经允许请勿转载。