在当前的统一多模态模型(Unified Multimodal Models)中,预训练的视觉编码器(如 VAE 或 CLIP)几乎是标配。这种模块化设计虽然成熟,却带来了一个根本性问题:理解任务与生成任务之间的表示错位。由于理解和生成往往使用不同的视觉表示,模型难以实现从原始像素到最终输出的完全端到端优化。
今天,由 Meta AI、香港大学和滑铁大学 联合研究团队提出的 Tuna-2 挑战了这一传统范式。Tuna-2 是一个原生的统一多模态模型,它完全摒弃了模块化的视觉编码器,直接基于像素嵌入(Pixel Embeddings)执行视觉理解和生成。
- 项目主页:https://tuna-ai.org/tuna-2
- GitHub:https://github.com/facebookresearch/tuna-2
实验表明,Tuna-2 不仅在多模态基准测试中取得了最先进的性能,更证明了统一的像素空间建模在高质量图像生成方面完全可以与潜在的空間方法竞争,甚至在需要细粒度视觉感知的任务上表现更优。
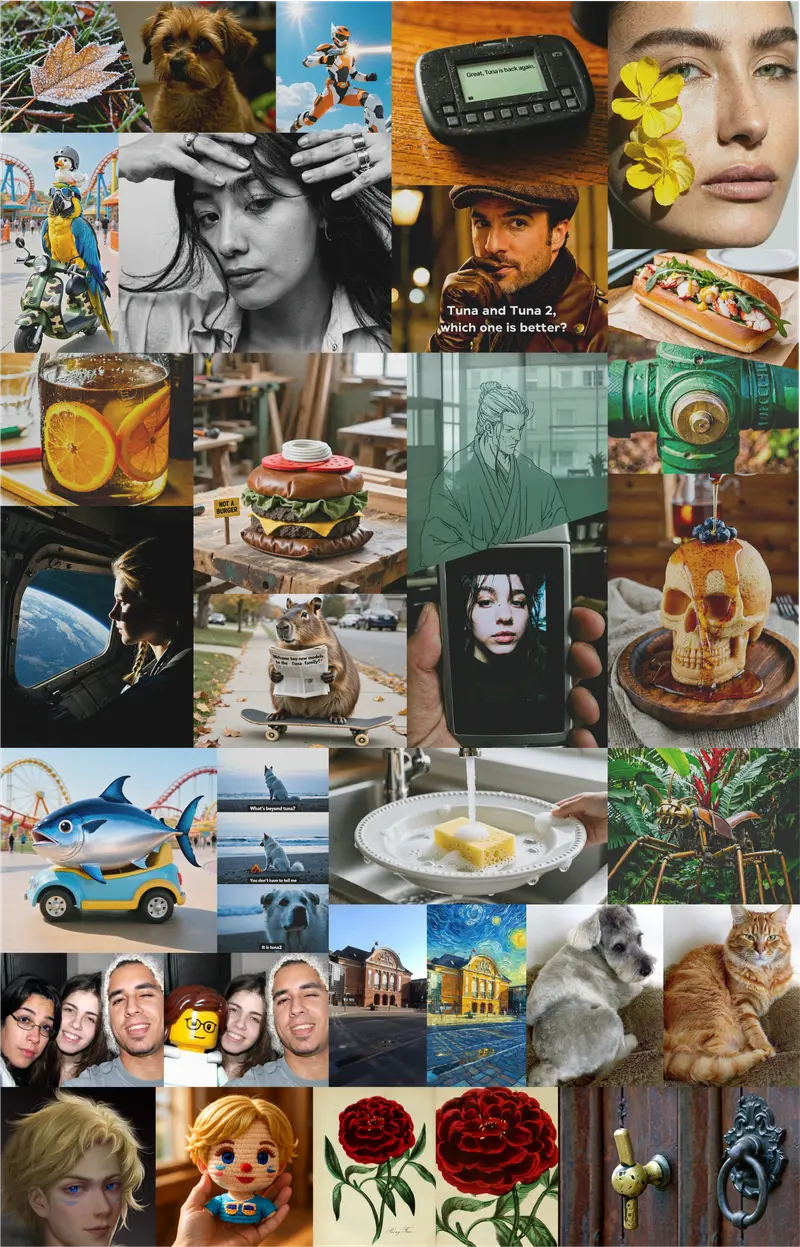
核心突破:为什么“无编码器”更强?
传统模型依赖预训练编码器将图像压缩为潜在向量,这虽然加速了早期收敛,但也引入了归纳偏差,限制了模型对原始像素细节的直接捕捉能力。
Tuna-2 的核心洞察是:大规模的端到端像素级训练可以完全取代预训练的视觉编码器。
- 统一表示:通过简单的补丁嵌入层(Patch Embedding Layer)直接将输入图像编码为视觉 Token,消除了理解与生成之间的表示鸿沟。
- 细粒度感知:在无编码器的设计中,模型直接面对原始像素数据,迫使它在训练中学习更精细的视觉特征。注意力可视化显示,Tuna-2 能更精确地关注相关视觉区域。
- 可扩展性:虽然基于编码器的变体在预训练初期收敛更快,但 Tuna-2 的无编码器设计在规模扩大后展现出更强的多模态理解能力,特别是在像素为中心的密集感知任务上。
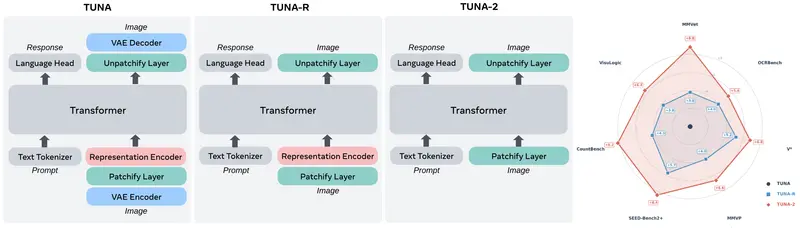
技术架构:极简而强大
Tuna-2 的架构设计旨在简化流程,提升效率:
1. 像素空间流匹配(Pixel-Space Flow Matching)
Tuna-2 舍弃了 VAE 模块,完全在像素空间中运行视觉-语言主干和流匹配头。
- x-prediction 与 v-loss:采用修正流及其线性调度,直接在像素空间中构建噪声样本,实现高效的生成训练。
2. 基于掩码的特征学习(Masked Feature Learning)
为了增强模型的推理能力,Tuna-2 引入了一种创新的掩码机制:
- 随机掩码:随机选择一部分图像补丁,并用可学习的掩码 Token 替换。
- 双重作用:
- 生成任务:创造了一个更难的去噪问题,提升生成质量。
- 理解任务:迫使模型在部分视觉观察下执行多模态推理,增强鲁棒性。
3. 两阶段端到端训练策略
- 全模型预训练:在图像描述和图像生成数据上进行大规模训练,奠定基础视觉-语言能力。
- 监督微调(SFT):针对高质量图像生成和指令遵循进行精细化调整。
基准测试:全面超越基于编码器的设计
在相同的训练方案下进行受控公平比较,结果令人瞩目:
- 多模态理解:经过充分的视觉预训练后,无编码器的 Tuna-2 在大多数多模态理解基准测试上优于基于编码器的对照模型(Tuna-R)。
- 细粒度感知:在需要高精度视觉感知的任务(如 OCR、细节描述、物体定位)上,Tuna-2 的优势尤为明显。
- 图像生成:在生成质量上,Tuna-2 与传统的潜在空间方法完全竞争,证明了像素空间建模的可行性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。