在文字生成图片(Text-to-Image)领域,我们常遇到这样的尴尬:AI 生成的画面大体不错,但细节却“不听话”——物体数量不对、位置错乱、风格偏差,甚至完全忽略否定词(如“没有猫”)。传统的优化方法往往像“局部修图”,只能小改小补,难以从根本上纠正这些结构性错误。
- GitHub:https://github.com/LeapLabTHU/RvR
- 模型:https://huggingface.co/JiayiGuo821/RvR-7B-MoT
由清华大学与腾讯混元团队联合研发的 RvR(Refinement via Regeneration,通过重生成进行优化) 技术正式亮相。它提出了一种全新的图像精修范式:不再依赖繁琐的编辑指令,而是直接基于语义进行“重生成”,从而实现对复杂描述的精准贴合。
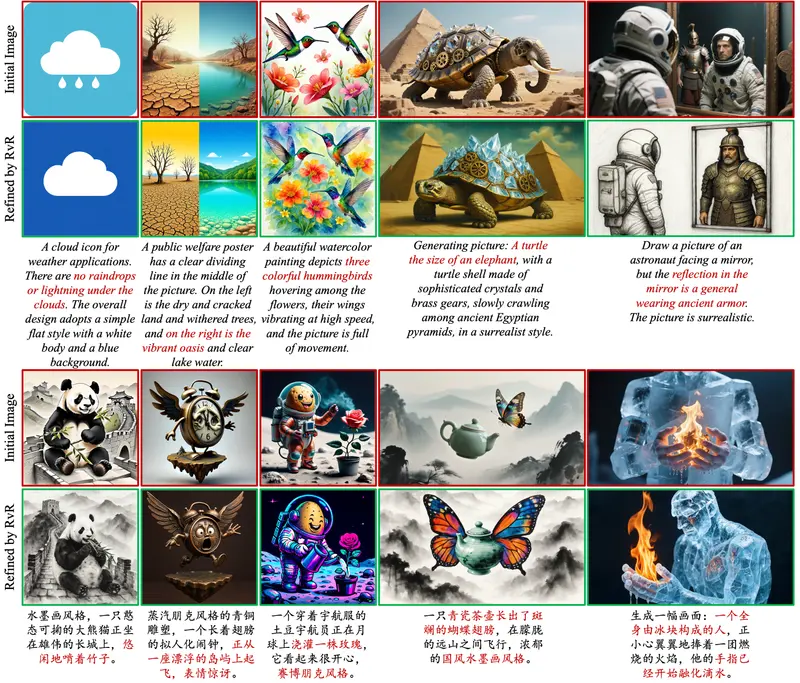
核心理念:从“修图”到“重生”
传统的图像精修技术(Refinement via Editing, RvE)通常要求用户或模型生成精确的修改指令(如“把左边的苹果移到右边”),并强制保持未编辑区域的像素一致性。这种方法存在两大局限:
- 指令复杂:需要极高的提示词工程技巧。
- 错误累积:局部修补容易导致画面违和,且难以修正全局性的语义错误。
RvR 彻底打破了这一局限。 它摒弃了中间编辑指令和像素级一致性的强约束,转而采用基于再生(Regeneration-based)的范式。
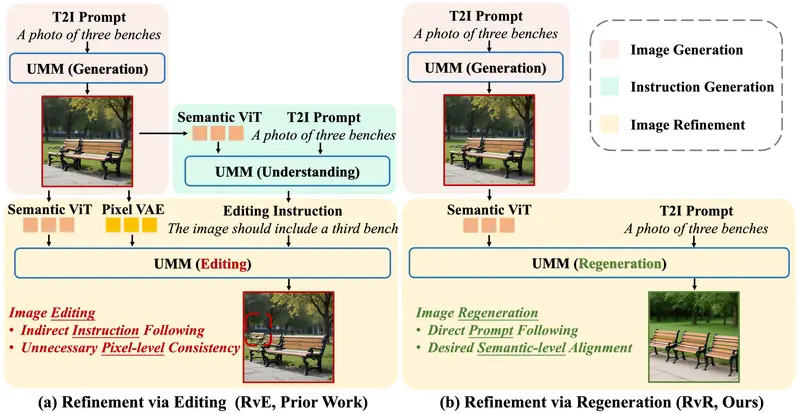
RvR 的核心逻辑:直接在目标提示词和初始图像的语义表示条件下,重新生成整张图像。这不仅扩大了修改空间,更实现了更深层次的语义对齐。
RvR 的四大核心优势
1. 精准纠错,自动识别不匹配
RvR 能够自动对比文字描述与已生成图像,智能识别出数量、位置、属性等不匹配之处,无需人工逐一点评。
2. 全局重生成,打破局部限制
不同于传统方法的“打补丁”,RvR 允许模型在保留原图合理语义的基础上,对错误区域甚至整体画面进行重新生成。这意味着它可以彻底解决复杂的结构性错误,而不仅仅是表面修饰。
3. 多轮迭代,越改越精准
支持多轮反复优化。每一轮迭代都会更接近文字描述的理想状态,同时智能保留前一轮中已经正确的内容,避免“越改越乱”。
4. 中英文兼容,适配复杂创意
完美支持中英文描述,无论是多物体交互、特殊空间关系,还是抽象的风格要求,RvR 都能精准理解并执行。
工作原理:四步实现完美对齐
RvR 的流程简洁而高效,主要分为四个步骤:
- 找错(Discrepancy Detection):
AI 首先分析文字描述与当前图像,找出语义上的不一致点(如“图中应该有两只狗,但只有一只”)。 - 语义提取(Semantic Extraction):
跳过生成具体修改指令的步骤,直接提取文字要求的核心语义以及原图中合理的视觉信息。 - 重生成(Regeneration):
模型基于目标提示词和提取的语义信息,全新生成一张图片。这不是在原图上涂抹,而是在理解原图意图基础上的“再创作”。 - 迭代优化(Iterative Refinement):
如果结果仍未完美,系统可继续运行下一轮 RvR,持续优化直到画面与描述高度契合。
训练秘诀:研究人员向模型投喂了大量“不合格图 – 合格图 – 文字描述”的三元组样本,让 AI 学会如何将“偏离题意”的画面修正为“完全贴合”的作品。
实测表现:远超传统方案
在多项权威基准测试中,RvR 展现了压倒性优势:
- 评分大幅提升:在三项主流图像质量与对齐度评分指标上,RvR 均显著高于基础模型及传统 RvE 方案。
- 复杂场景克星:在处理多物体计数、复杂空间位置、特殊属性绑定及否定描述(Negative Prompting)时,RvR 的准确率提升最为明显。
- 自然无违和:由于是全局语义重生成,画面整体协调性极佳,不会出现局部修图常见的光影断裂或风格不一问题。
- 智能保留与抛弃:能精准区分原图中的“有用信息”与“错误元素”,在修正错误的同时保留美感。
© 版权声明
文章版权归作者所有,未经允许请勿转载。