在 AI 图像编辑领域,我们常遇到这样的尴尬:AI 虽然能听懂简单的“添加”或“删除”指令,但面对复杂描述(如“把相机视角移到车内”、“让人物变老同时保持背景不变”)时,往往出现“想的和做的不一样”——要么改错了地方,要么破坏了画面整体感。
- 项目主页:https://shiyi-zh0408.github.io/projectpages/Meta-CoT
- GitHub:https://github.com/shiyi-zh0408/Meta-CoT
- 模型:https://huggingface.co/shiyi0408/Meta-CoT
由清华大学与腾讯混元团队联合研发的 Meta-CoT 技术正式亮相。它引入了一种全新的元任务分解范式,让统一多模态模型在编辑图片前进行“深度思考”,从而实现对复杂指令的精准理解和广泛泛化。
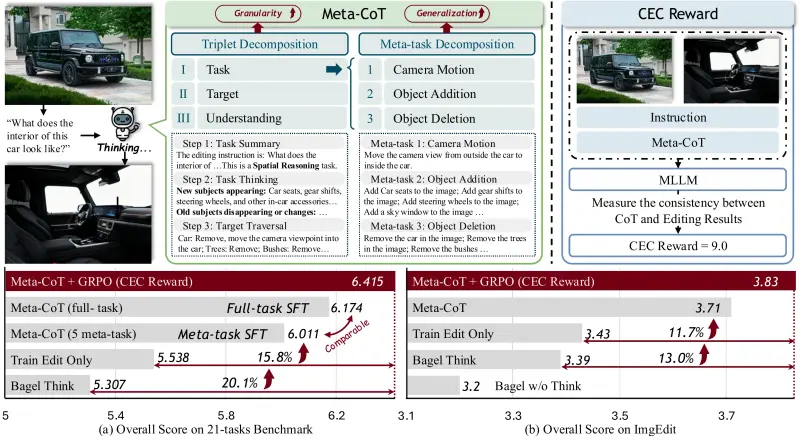
核心理念:先拆解,再执行
传统的 AI 修图模型往往直接尝试生成结果,缺乏中间的推理过程。Meta-CoT 的核心洞察是:任何编辑意图都可以被结构化分解。
通过引入思维链(Chain-of-Thought, CoT),Meta-CoT 让模型在执行像素级修改前,先进行逻辑推理,明确“做什么”、“改哪里”以及“需要什么理解能力”。这种“先思考后动手”的机制,显著提升了编辑的准确性和鲁棒性。
Meta-CoT 的三大创新支柱
1. 三元组分解:精细化理解指令
Meta-CoT 将任何复杂的编辑指令分解为一个结构化的三元组:
- 任务(Task):识别编辑操作类型(如替换、添加、相机运动)。
- 目标(Target):遍历所有需要编辑的对象和区域,精准定位。
- 理解(Understanding):确定完成任务所需的视觉理解能力(如深度估计、语义分割)。
这种分解让模型不再模糊处理,而是对每个编辑元素进行细粒度推理。
2. 元任务泛化:5 种基础操作搞定一切
研究发现,所有复杂的图像编辑任务都可以分解为五个基础元任务:
- 添加(Add):引入新对象或元素。
- 删除(Remove):移除现有对象。
- 替换(Replace):交换对象或属性。
- 相机运动(Camera Motion):改变视角或透视。
- 位置改变(Position Change):在空间上移动对象。
神奇之处:仅需在这五个元任务上进行训练,模型就能泛化到 21 种以上的多样化编辑任务(如风格迁移、逻辑推理修图等),性能媲美全数据训练模型。
3. CEC 奖励:确保“言行一致”
为了解决模型“推理正确但执行错误”的问题,团队引入了思维链-编辑一致性奖励(CEC Reward):
- 利用视觉语言模型(VLM)评估模型的 CoT 推理链与实际编辑输出之间的一致性。
- 通过强化学习(Flow-GRPO 框架),奖励那些忠实遵循推理步骤的编辑行为。
- 结果:模型越修越准,大幅减少“幻觉”和误操作。
工作原理:四步实现智能修图
- 三元组拆解:接收指令,拆解为任务、目标、理解需求。
- 元任务映射:将复杂任务映射为添加、删除、替换等基础操作的组合。
- 分步思考执行:模型生成详细的思维链,逐步规划编辑路径,逐个检查对象。
- 一致性优化:通过 CEC 奖励机制,实时校正推理与执行的偏差,确保最终效果符合预期。
测试结果:全面领先
在包含 21 种编辑任务的测试集及公开数据集上,Meta-CoT 表现卓越:
- 整体提升 15.8%:相比未经过思维链训练的基线模型,编辑效果显著增强。
- 极强泛化能力:仅训练 5 种元任务,即可完美适配未见过的复杂任务。
- 复杂指令克星:在涉及逻辑推理、多步操作的任务中,提升最为明显。
- 指令遵循度高:在对象一致性、画面自然度及指令匹配度上,全面超越现有主流修图模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。