MiniMax 正式宣布开源其最新旗舰模型 M2.7。这不仅是一次参数的升级,更标志着 AI 模型从“被动执行者”向“主动进化者”的范式转变。M2.7 被设计为能够深度参与自身的训练与优化流程,具备构建复杂 Agent 框架、完成高难度生产力任务以及通过反馈循环实现自我进化的能力。
- Huggingface:https://huggingface.co/MiniMaxAI/MiniMax-M2.7
- MiniMax API:https://platform.minimax.io/docs/guides/models-intro
- 官方介绍:https://www.minimax.io/news/minimax-m27-en
核心突破:自我进化的闭环
M2.7 最引人注目的特性是其自主优化能力。它不再仅仅依赖人类工程师的手动调优,而是能够内部构建评估集、收集反馈,并迭代优化自身的架构、技能和记忆机制。
- 自主迭代循环:在内部编程能力优化实验中,M2.7 自主运行了超过 100 轮 “分析失败 → 计划更改 → 修改代码 → 运行评估” 的循环。
- 显著性能提升:通过自动搜索最优采样参数(如 temperature, penalty)、设计更具体的工作流指南以及添加循环检测,M2.7 在内部测试中实现了 30% 的性能提升。
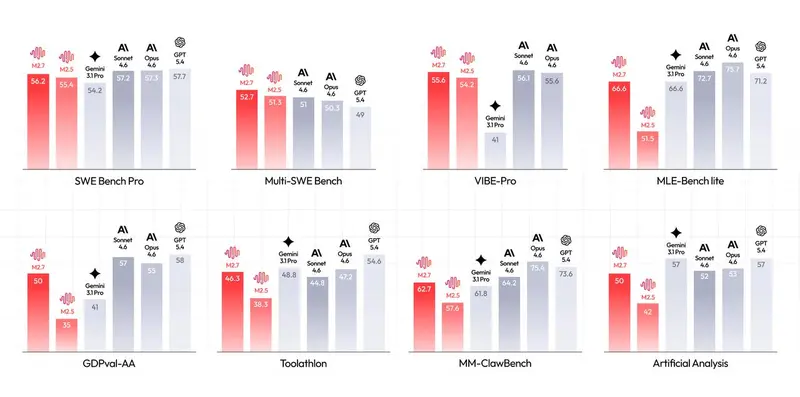
- 低资源竞赛表现:在 OpenAI 开源的 MLE Bench Lite(22个机器学习竞赛)中,M2.7 经过24小时自主迭代,平均奖牌率达到 66.6%,与 Gemini-3.1 持平,仅次于 Opus-4.6 和 GPT-5.4。
软件工程:SOTA 级别的编码与系统理解
M2.7 在真实世界的软件工程场景中表现出接近顶级闭源模型的水平,不仅擅长写代码,更擅长理解系统和解决生产问题。
关键基准测试成绩
| 基准测试 | 得分 | 表现对比 |
|---|---|---|
| SWE-Pro | 56.22% | 接近 Claude Opus 最佳水平,与 GPT-5.3-Codex 持平 |
| VIBE-Pro (完整项目交付) | 55.6% | 几乎与 Opus 4.6 持平,支持 Web/Android/iOS 全栈交付 |
| Terminal Bench 2 (系统理解) | 57.0% | 展现对复杂工程系统操作逻辑的深度理解 |
| SWE Multilingual | 76.5% | 多语言编程能力显著优势 |
生产级调试能力
M2.7 具备 SRE(站点可靠性工程)级别的推理能力:
- 因果推理:能将监控指标与部署时间线关联,提出精确假设。
- 主动验证:自动连接数据库验证根本原因,定位缺失的索引迁移文件。
- 快速止血:在提交 MR 前使用非阻塞索引创建,多次将生产事件恢复时间缩短至 3分钟以内。
原生 Agent Teams
M2.7 原生支持多智能体协作,具备角色边界感、对抗性推理能力和协议遵守意识,无需复杂的提示工程即可稳定运行包含产品经理、开发、测试在内的最小化原型团队。
专业办公:金融分析与文档处理专家
M2.7 在专业办公领域同样表现出色,特别是在需要深度领域知识和复杂工具调用的场景。
- GDPval-AA 排名:ELO 得分 1495,在开源模型中排名第一,超越 GPT-5.3,仅次于 Opus 4.6 和 Sonnet 4.6。
- 高保真文档编辑:支持 Word、Excel、PPT 的多轮交互式编辑,保持极高的指令遵循率(在处理40+复杂技能时达 97%)。
- 金融分析师案例:
- 任务:基于台积电(TSMC)年报和财报电话会议记录,构建收入预测模型并生成研报。
- 能力:自主阅读多份报告,交叉参考数据,独立设计假设,构建模型,并最终输出符合专业标准的 PPT 和 Word 研报初稿。
娱乐与交互:OpenRoom 可视化系统
为了探索 AI 在娱乐和情感陪伴领域的潜力,MiniMax 同步开源了 OpenRoom —— 一个基于 Agent Harness 的交互式 Web GUI 系统。
- 超越文本:将 AI 交互从纯文本流解放出来,放入可视化的 Web 空间。
- 实时反馈:对话驱动场景变化,角色主动与环境互动,提供实时的视觉反馈。
- 高情商与一致性:M2.7 增强了人物一致性设定,使其能像朋友一样与用户进行长期、稳定的情感交互。
- 开源 Demo:初始 Demo 代码大部分由 AI 编写,社区可在此基础上扩展新的交互玩法。
© 版权声明
文章版权归作者所有,未经允许请勿转载。