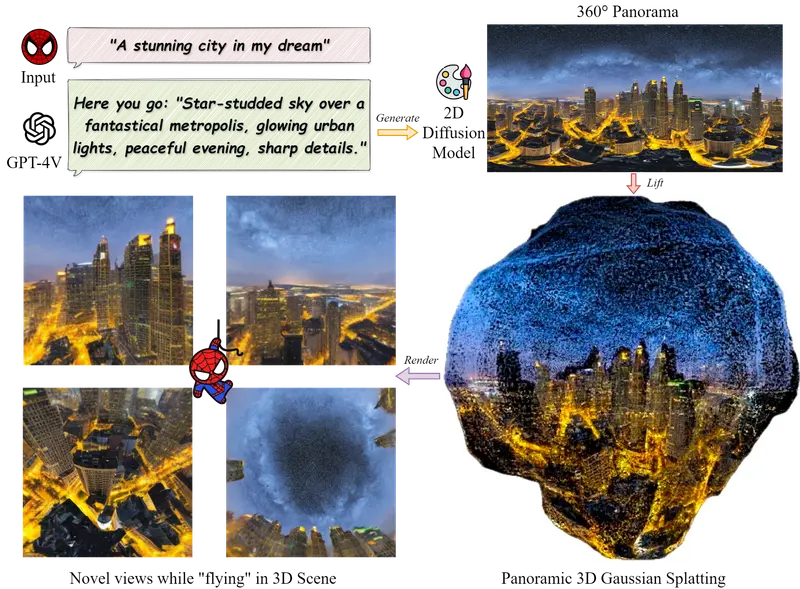
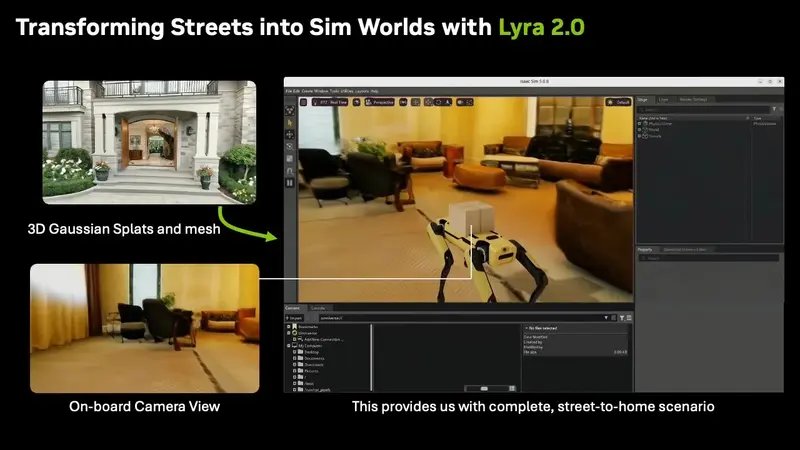
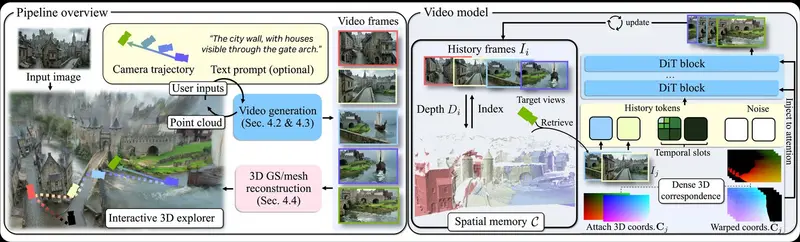
英伟达空间智能实验室(SIL)近期展示了 Lyra 2.0,这是一个 AI 驱动的框架,能够将单张静态照片转化为可探索的 3D 环境。该研究最初于 2026 年 4 月发表,目前英伟达正于 SIGGRAPH Asia 2026 召开前夕重点展示该技术。与生成预定视频序列的传统图像到视频模型不同,Lyra 2.0 允许用户自主控制相机轨迹,并在相机移动的过程中,逐步生成环境的新视图,同时保持虚拟世界的一致性。
- GitHub:https://github.com/nv-tlabs/lyra/tree/main/Lyra-2
- 模型:https://huggingface.co/nvidia/Lyra-2.0
该框架结合了 AI 视频生成与 3D 重建技术,为游戏开发、虚拟现实和机器人仿真等领域的环境资产创建提供了新的工程路径。
核心工程突破:解决空间遗忘与时间漂移
生成式 AI 在长序列生成中通常面临两个长期存在的技术缺陷,Lyra 2.0 通过针对性的架构设计对这两点进行了优化:
- 空间遗忘(Spatial Forgetting)
在传统模型中,当相机移动并重新访问先前生成的位置时,AI 往往会丢失对早期空间结构的追踪,导致重访区域出现几何或纹理上的不一致。Lyra 2.0 引入了一个空间记忆系统,该系统利用 3D 几何信息作为索引,主动检索并调用相关的历史帧数据,从而确保场景结构在空间维度上的连贯性。
- 时间漂移(Temporal Drift)
在长时间或长距离的生成过程中,视觉和几何误差容易逐渐累积并放大。为解决此问题,研究人员采用了一种自我纠正的训练策略:模型会在自身生成的不完美输出上进行二次训练。这种机制有效教会了模型识别并纠正累积的视觉误差,而不是在后续生成中不断放大这些偏差。
性能优化与输出格式
为了提升实际应用的可行性,英伟达在推理效率和输出兼容性上进行了显著优化。
- 蒸馏模型加速:英伟达开发了一个专用的蒸馏模型,将视频生成过程中的降噪步骤从传统的 35 步大幅减少至 4 步。这一改进使整体生成时间减少了约 13 倍。
- 硬件性能基准:根据研究论文数据,在单块 NVIDIA GB200 GPU 上,生成一个 80 帧的片段约需 15 秒;相比之下,使用未蒸馏的完整模型则需要 194 秒。需要明确的是,尽管速度显著提升,但这仍属于离线或近线生成范畴,不应与严格意义上的“实时世界生成”混淆,后者目前依然面临极高的计算密度挑战。
- 显式 3D 几何重建:生成的视频序列随后可被重建为 3D 高斯泼溅(3D Gaussian Splatting)或多边形网格(Polygon Meshes)。这种显式的 3D 几何表示不仅支持实时渲染,还允许生成的环境直接导出并集成到 NVIDIA Isaac Sim 等专业的仿真应用程序中。
技术局限与行业横向对比
尽管 Lyra 2.0 在静态场景的扩展上表现优异,但其技术边界依然明确:
- 动态场景限制:该技术目前主要适用于静态或准静态环境。对于包含复杂物理交互或高频动态变化的场景生成,模型仍会出现视觉不一致的现象,这是当前架构尚未完全攻克的挑战。
- 与同类技术的差异:与 Google 此前公布的 Project Genie(另一个能够生成可探索虚拟世界的实验性系统)相比,Lyra 2.0 采取了不同的技术路线。Project Genie 更侧重于隐式神经表示的实时交互,而 Lyra 2.0 则致力于将生成内容重建为显式的 3D 几何资产。这种显式表示使其更容易被现有的图形渲染管线和仿真环境直接接纳与使用。
开源状态与获取方式
英伟达已将该技术的部分成果向社区开放,开发者可通过以下渠道获取:
- 代码实现:完整的 Lyra 2.0 实现代码已在 GitHub 上开源。
- 模型权重:预训练模型权重已托管于 Hugging Face 平台。
注意:Hugging Face 上的模型权重受英伟达研究使用许可(NVIDIA Research Use License)的限制,通常仅允许用于非商业的学术研究或评估目的,商业部署需另行确认许可条款。
© 版权声明
文章版权归作者所有,未经允许请勿转载。