Hy‑Nomas 是腾讯混元团队推出的80亿参数交互式世界模型,基于HunyuanVideo1.5视频大模型改造,核心区别于传统一次性生成的文生视频:它可以维持一个连续的虚拟世界,在生成过程中持续接收新指令,文字指令、WASD式相机漫游可以在同一会话自由交替切换,同时配套开源评测基准 Hy‑Nomas‑Bench。
- 项目主页:https://hy-nomas.hy.tencent.com/?lang=zh
- GitHub:https://github.com/Tencent-Hunyuan/Hy-Nomas
- 模型:https://huggingface.co/tencent/Hy-Nomas
- Demo:https://hy-nomas.hy.tencent.com/
传统文生视频是一次性渲染成片,无法中途修改剧情、转动镜头;很多交互式竞品的文字控制、相机漫游是两套独立系统,切换需要重启场景,还容易出现动作重复、时序错乱、物体记忆丢失、场景崩坏等问题。Hy‑Nomas 针对性设计了动作感知因果注意力机制来缓解这些痛点。
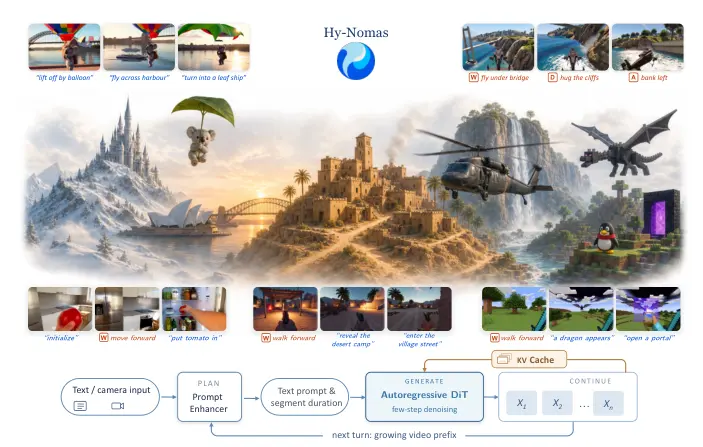
核心模块
整套系统由四块组成:提示增强器PE、8B交互式视频主干、蒸馏推理流水线、LoRA适配模块。
- 提示增强器 PE
接收口语化自然语言或者相机移动指令,结合全部历史视频,输出结构化条件:只更新发生变化的部分,不重复冗余背景;相机模式下重点输出镜头轨迹。降低用户撰写专业提示词的门槛。 - 交互式主干(核心)
- 分段因果注意力:自回归分段生成,只能看见当前以及过往片段,不偷看未来;
- 动作感知掩码:区分「长期环境背景」和「一次性限时动作」,背景全程生效,动作指令只在对应时段生效,避免动作循环重演、顺序颠倒;
- 相机轨迹跨注意力:位移、旋转编码成独立特征,和画面特征融合,原生支持两种控制模式混用。
- 训练方案
采用分段自强制训练:拿模型自己生成的带瑕疵片段当作历史上下文训练,缩小训练和真实推理的鸿沟;搭配扩散蒸馏,减少降噪步数,兼顾速度与画质,再通过INT8量化、滑动窗口等优化,单张高端消费显卡可推理。 - LoRA微调
少量样本即可训练LoRA,快速迁移到特定画风、机器人操作等场景,代价是如果相机相关样本不足,漫游能力会衰减。
配套评测基准 Hy‑Nomas‑Bench
包含280组测试用例,分为四大类:多轮文字交互、相机导航、文字+相机混合控制、空间记忆。不再只看画面美观度,专门量化指令遵从、物理合理性、相机响应、空间记忆,填补行业交互世界模型的统一评测缺口。
实测对比(对照 Genie3、LingBot‑World v2、HappyOyster)
- 文字交互:指令跟随、物理动作合理性表现更好,抓取、多步骤连贯动作完成度更高;
- 混合操控:同一会话无缝切换文字和相机,是它的突出优势,优于同批竞品;
- 纯相机漫游:整体优于LingBot‑World v2、HappyOyster,但空间记忆弱于Genie3,镜头转回后物体更容易形变;
- PE提示增强器能显著提升输出合规性,改善指令遵从效果。
局限
属于科研原型,不是游戏引擎;长时序下空间记忆仍会漂移,复杂物理碰撞仿真效果有限;普通家用显卡运行压力较高,长时间交互会逐步累积画面瑕疵。
© 版权声明
文章版权归作者所有,未经允许请勿转载。