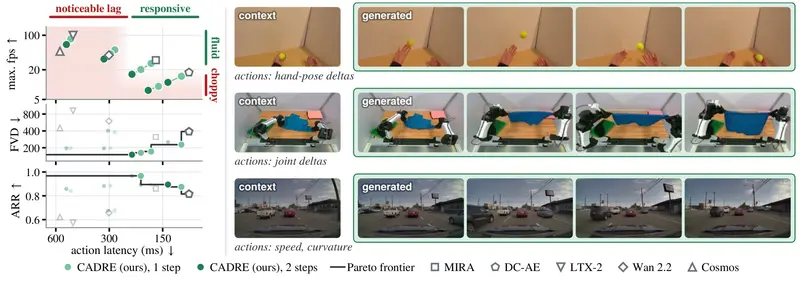
Kyutai 推出CADRE(因果扩散表示自编码器),这是一个专为交互式世界模型设计的开放因果扩散表示自编码器家族。该研究旨在解决当前世界模型普遍面临的动作延迟问题,通过在单块英伟达H100 GPU 上实现 20 fps 的运行帧率以及低于 230 毫秒的响应延迟,为实时交互应用提供了新的技术基准。
- GitHub:https://github.com/kyutai-labs/cadre-autoencoders-and-world-models
- 模型:https://huggingface.co/collections/kyutai/cadre-autoencoders-and-world-models
核心架构与工作机制
CADRE 的设计核心在于优化潜在空间中的压缩效率,以降低每帧的计算成本与动作延迟。其架构包含两个主要部分:
- 编码器:复用 MIRA 配方,首先使用冻结的 DINOv3 (ViT-B/16) 模型从每帧提取补丁级特征,随后通过一个训练有素的 3D 卷积网络将其压缩为 64 通道的潜在表示。CADRE 家族的 7 个变体仅在瓶颈层的设计上存在差异。
- 解码器:采用包含 24 个块的因果扩散 Transformer,支持逐块流式传输。通过渐进式自蒸馏技术,模型被教导仅需 1 到 2 步即可完成解码。这一过程在单一训练阶段内完成,无需引入对抗损失。
该自编码器在约 7.6 万小时的 23 个公共视频源上进行了训练,数据混合涵盖了网络视频、机器人操作、自动驾驶和游戏画面。
性能表现与关键发现
在 Kyutai 的评估中,研究团队在每个自编码器上训练了相同的 12 亿参数因果扩散 Transformer,并在机器人操作、人类操作、驾驶和室内导航四个环境中进行测试。结果显示,CADRE 在延迟与质量的权衡前沿占据了主导地位:
- 延迟与帧率:在单块 H100 上,CADRE-2×32×32 变体仅需 185 毫秒即可响应,并维持 23.4 fps 的生成速度,显著优于 Wan 2.2 (317 毫秒)、LTX-2 (492 毫秒) 和 Cosmos (605 毫秒)。
- 画质与动作跟随:在驾驶场景中,CADRE-2×16×16 的 FVD(Fréchet Video Distance)得分低至 162.6,远低于 Wan 2.2 的 599.7。
研究团队从中得出了四项关键发现:
- 扩散解码的优势:在强压缩率下,传统的感知回归容易产生模糊,而扩散采样仅需 1 步即可生成清晰的视频。
- 时间压缩的位置:在自编码器内部进行时间压缩,比在世界模型内部进行分块处理能保留更多细节。
- 相机运动决定压缩策略:静止相机场景能较好地容忍时间维度的压缩;而移动相机场景则更偏好更少的帧数和更粗糙的空间 token。
- 粗糙 token 对运动的影响:在机器人操作等对运动敏感的场景中,过度的空间压缩(如 32×)会使 FVD 恶化 2.4 倍,尽管对静态图像质量(FID)影响不大。
局限性与注意事项
尽管表现优异,CADRE 并非在所有指标上均占优。例如,在机器人操作的动作跟随(ARR)指标上,Wan 2.2 得分 0.85,优于 CADRE-2×32×32 的 0.45。此外,Wan 2.2 在留出视频的重建 PSNR(35.02 dB)上也表现更好。
Kyutai 团队指出,较长的潜在表示(如 τ = 8)会在块之间产生可见的接缝伪影。同时,当前评估主要基于 288×512 分辨率的特定环境模型,这些发现是否能无缝迁移至通用世界模型,仍有待进一步验证。
开发者使用与开源协议
对于开发者和研究人员,CADRE 提供了良好的可访问性:
- 开源协议:代码库采用宽松的 MIT 许可证。然而,托管在 Hugging Face 上的模型权重采用 CC BY-NC 4.0 许可证(结合 DINOv3 许可证),这意味着其仅限于非商业用途。
- 发布内容:本次发布涵盖了 7 个自编码器变体、4 个经过更长时间训练的多分辨率版本,以及 4 个基于 CADRE-2×16×16 构建的世界模型。
- 交互演示:官方提供了一个实时演示,允许开发者使用键盘直接驱动这些模型,直观体验其低延迟特性。
总体而言,Kyutai CADRE 通过创新的因果扩散解码与精细的压缩策略,为构建低延迟、高响应的交互式视频世界模型提供了一套极具参考价值的开源基线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。