webAI发布了 TwIL-8B,这是一款专为数学推理、代码生成和指令遵循优化的 8.8B 稠密推理模型。该模型基于 IBM 的 Granite 4.2 8B 进行深度后训练,通过创新的长度感知强化学习策略,在保持极高推理准确率的同时,显著降低了 Token 消耗,为本地化部署提供了高性价比的开源(非商业)选择。
- 模型:https://huggingface.co/webAI-Official/TwIL-8B
核心特性与训练机制
- 双变体架构设计:TwIL-8B 提供两种推理模式。Balanced(平衡版) 为默认版本,生成更简短的推理轨迹,适合常规任务;Verbose(详细版) 则针对高难度竞赛级问题进行了优化,提供更详尽的思维链(
<think>块)。 - 三阶段深度后训练:
- 全参数 SFT:在数学、STEM 和指令遵循的推理轨迹上进行监督微调。
- GRPO/DAPO 强化学习:在数学、代码等复杂提示上进行强化学习,生成详细版变体。
- 长度感知 RL:引入偏向更短轨迹的奖励机制,并对照各领域长度参考进行优化,从而衍生出高效的平衡版变体。
- 严格的数据去污染:训练池使用 13-gram 匹配技术,针对 AIME、HMMT、MATH-500、GPQA 等主流评估集进行了严格的去污染处理,确保基准分数的真实性。
性能表现与基准对比
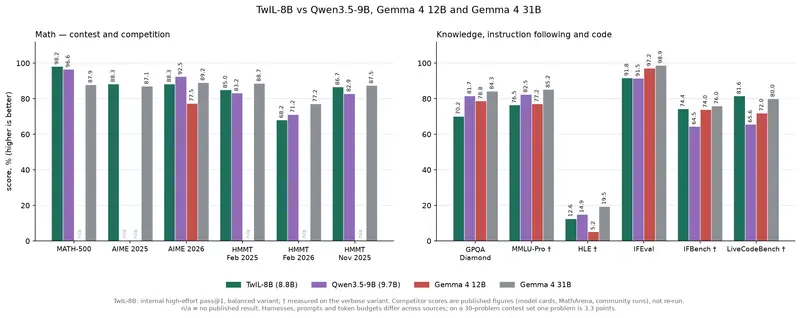
在多项核心基准测试中,TwIL-8B 展现了越级的推理能力,但也暴露出知识储备上的短板:
- 数学与代码(显著优势):在 MATH-500 上取得 98.2 的高分,超越同量级的 Qwen3.5-9B(96.6);在 LiveCodeBench 上得分 81.6,大幅领先 Qwen3.5-9B(65.6)。
- 极致的 Token 效率:在 AIME 2026 测试中,TwIL-8B 平均每问题仅消耗约 19.5k 输出 Token,比 Qwen3.5-9B(31.2k)减少了 38%,在 HMMT 上也减少了 19%,大幅降低了推理成本。
- 知识类基准(相对弱势):在 GPQA Diamond 上得分为 70.2,落后于 Qwen3.5-9B(81.7)和 Gemma 4 31B(84.3),表明其在纯知识检索与综合常识方面仍有提升空间。
部署方案与许可限制
- 轻量级本地部署:模型官方提供了多种量化版本。其中 Q4_K_M (GGUF) 版本仅需 4.98 GiB,非常适合在 CPU 或显存有限的消费级 GPU 上流畅运行。完整 bf16 权重为 16.38 GiB。建议分配较大的生成预算(如
max_new_tokens=32768)以充分发挥其推理能力。 - 许可约束:模型权重已在 Hugging Face 开放,但采用 webAI 非商业 1.0 许可,明确限制其用于商业用途。目前暂无托管推理提供商提供该模型的 API 服务。
© 版权声明
文章版权归作者所有,未经允许请勿转载。