Deep Principle(杭州 AI 材料企业)正式发布了 Hydrogen-1.0,这是一款参数量高达 753B(MoE 架构,约 40B 激活参数)的开放权重科学大模型。该模型基于智谱的 GLM-5.3 进行深度后训练,专注于化学、材料科学和生命科学领域的科学发现,并以宽松的 MIT 许可协议开源,旨在为科研社区提供一个可重现、可检查的 AI 助手替代方案。
- 官方介绍:https://blog.deepprinciple.com/introducing-hydrogen-1.0
- 模型:https://huggingface.co/deep-principle/Hydrogen-1.0
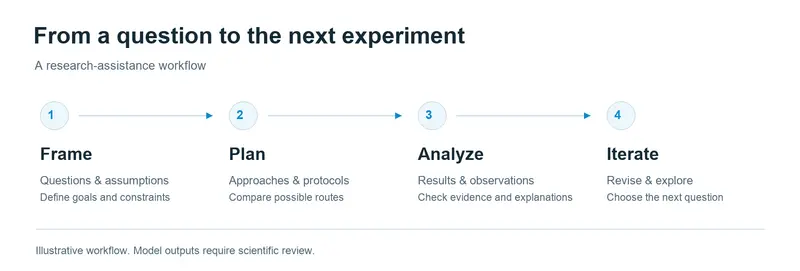
核心架构与训练机制
Hydrogen-1.0 的训练管道结合了监督微调(SFT)与强化学习(RL),其数据构成显著区别于仅依赖公开论文的传统模型:
- 多维数据源:除了常规的化学、材料和生命科学领域知识外,模型还深度学习了来自 Deep Principle 科学家的任务特定反馈、通过 Mira 系统捕获的全周期电子实验室笔记本记录,以及包含成功与失败尝试的智能体发现轨迹。
- 底层工程优化:基础设施基于 Megatron 和 SGLang 构建,跨 NVIDIA CUDA 和 AMD ROCm 平台优化。训练过程中在上下文并行分片间保持了动态稀疏注意力因果,并使用 Muon 优化器状态在不同硬件间灵活调度。RL 阶段采用可恢复的 rollout,并保留每个 token 的原始行为对数概率以进行重要性校正。
性能表现与基准测试
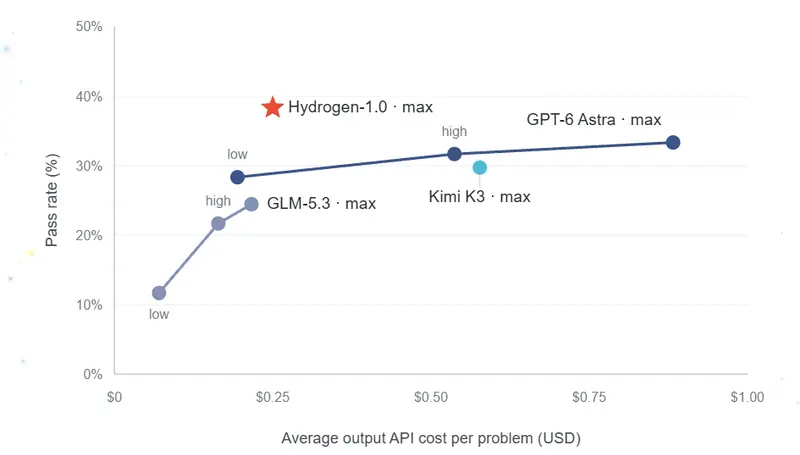
在多项科学基准测试中,Hydrogen-1.0 展现了强大的竞争力(数据均为 Deep Principle 自报):
- 综合科学能力:在 FrontierScience-Research 基准上取得 38.3% 的得分,超越了 GPT-6-Astra 的 33.3%。
- 高难度推理:在 GPQA-Diamond 上达到 93.0%,大致匹配 Kimi-K3 的水平。
- 细分任务对比:在科学计算(领先 5.13 个百分点)和正向反应预测(领先 4.76 个百分点)上优于最大思考模式的 GPT-6-Astra;但在 NMR(核磁共振)结构解析任务上,仍落后 GPT-6-Astra 3.33 分。
- 复杂任务规划:在过渡金属配合物设计的 5 轮优化中,Hydrogen-1.0 达到了平均 4.318 eV 的最佳 HOMO-LUMO 间隙,显著优于 GPT-6-Astra (3.689 eV) 和 Kimi-K3 (3.353 eV)。
真实实验室工作流应用
技术演示展示了 Hydrogen-1.0 在端到端科研任务中的实际执行力:
- 分子动力学模拟:编写 Python 脚本构建聚乙烯熔体并运行 GROMACS,自主检测并修复拓扑错误,随后分析校正后的 40 ns 轨迹。
- 反应网络探索:通过 30 个合理的反应步骤,自主生长出一个包含 27 个结构的 Ireland-Claisen 反应网络。
- 谱图解析:从 1H NMR 谱图中,准确排名 2-溴萘的 7 个候选单甲酰化产物。
- 实验协议生成:为 12 瓶 Suzuki 偶联研究编写标准化的 JSON 协议,并在虚拟实验室编译步骤中提前捕获了“无新吸头吸取”的潜在操作错误。
部署方案与硬件支持
Hydrogen-1.0 的模型权重已托管于 Hugging Face 和 ModelScope。为确保高效推理,官方提供了明确的部署建议:
- 推荐配置:使用 SGLang 在 8 块 GPU 上进行 BF16 精度服务,张量并行度(Tensor Parallelism)设置为 8。
- 前沿硬件量化:针对下一代算力平台,提供了面向 NVIDIA Blackwell 架构(B200/B300)的 NVFP4 量化构建,以及面向 AMD Instinct MI350X/MI355X 的 MXFP4 量化构建。
- API 兼容性:推理服务器暴露标准的 OpenAI 兼容 API,并支持通过
reasoning_effort参数调节模型的思考深度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。