TypeSafe AI 近日发布首款模型 Jev,由前 OpenAI 指令遵循(RLHF)研究员 Diogo Almeida 创立。与主流大语言模型不同,Jev 不生成文本、不支持对话,而是专为软件间快速决策设计:在 70–500 毫秒内返回结构化判断结果(选择、评分或布尔概率),输入定价 $0.042/百万 token,输出完全免费。其核心定位是“AI 原生的 if 语句”——将硬编码阈值替换为带置信度的动态判断,使自动化系统能在成本可控的前提下实现更智能的路由、验证与控制。
Jev 的命名致敬 19 世纪经济学家 William Stanley Jevons 的“杰文斯悖论”:效率提升不会减少资源消耗,反而因成本下降激发更多使用场景。TypeSafe 押注 AI 决策成本每降一个数量级,将解锁远超节省量的新应用,尤其针对那些“不值得调用昂贵 LLM”的海量微决策。
技术本质:放弃生成,专注判断
传统 LLM 以自回归方式逐 token 生成文本,输出长度直接决定延迟与成本。Jev 彻底摒弃这一范式:
- 输入:接收结构化“状态”(如工单、账户历史、游戏快照)+ 预定义问题集
- 输出类型:
- Choice:从 ≤255 个候选中选一(如路由目标、下一步动作)
- Score:在连续量表上打分(如风险等级、用户情绪强度)
- Noul:返回是/否的概率(如是否欺诈、是否需人工介入)
- 执行方式:所有问题在一次并行前向传播中完成,无序列生成,无解释文本
- 性能指标:响应时间 70–500ms(vs LLM 3s–分钟级);独立测试显示 777 次判断耗时 <0.7s,成本约 $0.00025
这种设计使 Jev 成为验证层的理想载体:在昂贵模型输出到达用户或触发动作前,以极低成本进行合规性、安全性或一致性检查。例如,客服场景中可先由 Jev 判断工单紧急度与部门归属,再决定是否调用 GPT-6 Astra 生成回复。
实测表现与已知局限
优势场景:
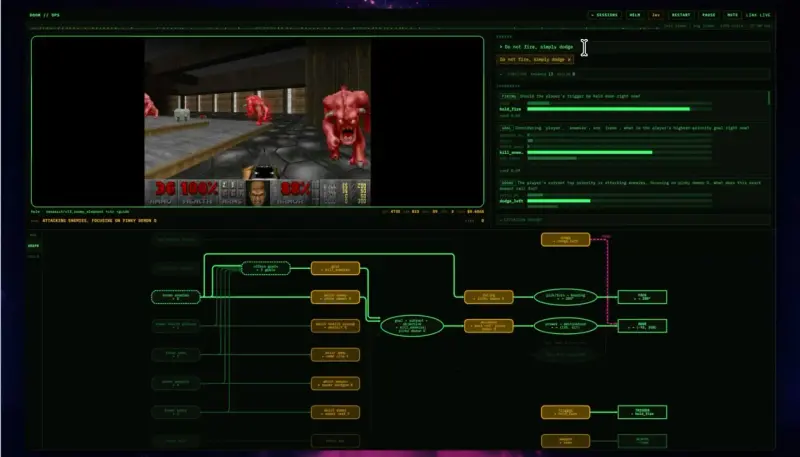
- 速度敏感任务:Doom 游戏中每秒 10 次决策(~$7/小时);国际象棋闪电战中因对手超时而胜 Fable 5.1
- 高并发微决策:邮件分类、内容审核、Agent 动作安全校验
- 成本敏感验证:对 LLM 输出做前置过滤,避免无效调用
明确限制:
- 非通用推理器:只能从预设选项中选择,无法发明新答案;若选项缺失关键类别,会自信地选错
- 仅支持文本/结构化数据:当前早期访问版不支持图像
- 基准透明度不足:官方测试基于与 GPT-6 Astra/Fable 5.1 的答案一致性(67.8%),而非地面真值;发票处理准确率(61.8%)显著低于 GPT-5.6 Sol(79.1%)
- 架构未公开:无论文、无参数量披露,社区难以复现或审计
独立测试显示,在写作缺陷检测任务中,Jev 发现 6/7 个问题(Fable 5.1 为 7/7),但速度快 25 倍、成本低 580 倍。这印证了其核心价值:以轻微质量折损换取数量级的效率提升,适用于对完美精度要求不高但对延迟/成本极度敏感的场景。
Jev 入门:从注册到首次决策的完整操作指南
Jev 核心价值在于以 0.1 秒级响应和输出免费的特性,替代传统 LLM 在微决策场景中的高成本调用
第一步:获取访问权限与 API Key
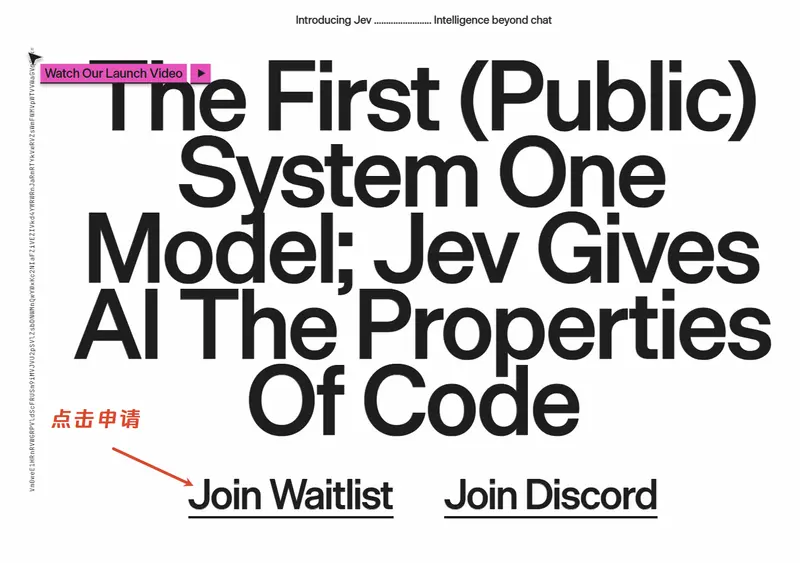
- 申请 Waitlist
访问 TypeSafe 官网,点击 “Join Waitlist” 输入邮箱。审批通常数小时内完成,无需额外审核材料。 - 注册账号
查收邀请邮件,点击专属链接完成注册。注意:链接仅限单次使用,过期需重新申请。 - 创建 API Key
登录后进入控制台首页,点击右侧 “Create key”,输入名称(如dev-test)后复制密钥。密钥仅显示一次,务必立即保存至安全位置。丢失无法找回,只能重新生成。
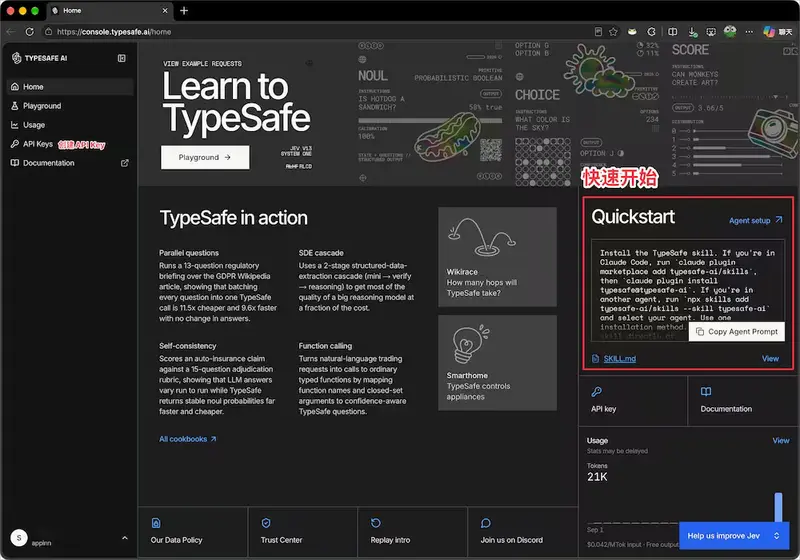
💡 新注册用户赠送 $5 额度,按 $0.042/百万输入 token 计费,约可支持 1.2 亿次判断,足够充分测试。
第二步:安装 TypeSafe Skill 到 Agent
Jev 通过标准化 Skill 接口集成到主流编码 Agent,无需手动编写 API 调用代码。根据所用工具选择对应安装命令:
- Claude Code
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
- 其他 Agent(Codex / OpenClaw / Qwen Code / Kimi CLI / WorkBuddy 等)
npx skills add typesafe-ai/skills --skill typesafe-ai
执行后按提示选择目标 Agent 类型即可完成绑定。
安装完成后,Skill 会自动注入 Jev 的调用协议与参数规范。可直接查阅 SKILL.md 源码 验证配置。
第三步:理解 Jev 的决策前提与输出格式
在使用前必须明确两个核心约束,否则调用必然失败:
- 必须提供候选集:Jev 不能凭空生成答案,所有判断必须在预定义选项范围内进行。例如问“哪个标题更好?”时,必须列出 A/B/C/D 具体选项。
- 输出为结构化数据:返回 JSON 格式的判断结果,包含选项索引、置信度概率及问题类型标识,无自然语言解释。
三种输出类型示例:
// Choice: 从候选中选一
{"type": "choice", "index": 0, "confidence": 0.92}

// Score: 连续量表打分
{"type": "score", "value": 0.78, "confidence": 0.85}

// Noul: 是/否概率
{"type": "noul", "probability": 0.96, "confidence": 0.91}
第四步:首次实战——用自然语言触发决策
安装 Skill 后,直接在 Agent 对话中描述需求即可。以下为可复用的模板:
场景:文章标题选择
我准备发布一篇介绍 Jev 的文章,请判断下面哪个标题最适合普通科技读者:
A. Jev 入门:ChatGPT 研究员发布“不会聊天”的 AI,速度快 200 倍、成本低 400 倍
B. Jev:System One Model 与 RLCD 技术解析
C. 不会聊天的 AI,为什么反而更快?
D. 一个全新的 AI 决策模型 Jev判断标准:普通读者能快速看懂、有点击吸引力、能体现 Jev 核心特点、不要过度标题党。
使用 Choice 选择一个。
Agent 将自动调用 Jev 并返回类似 {"type":"choice","index":0,"confidence":0.89} 的结果。若置信度低于预期阈值(如 0.8),可要求重新评估或人工复核。
关键技巧:
- 判断标准需具体可衡量,避免模糊表述如“好一点”
- 候选项数量建议 ≤10,过多会降低置信度稳定性
- 多维判断可合并为单次请求:“同时评估每个标题的可读性、吸引力、准确性”
第五步:生产环境集成要点
- API 调用方式:Skill 封装了底层 HTTP 请求,但若需自定义集成,参考官方 API 文档构造 POST 请求至
/v1/decide端点,Body 包含state(上下文)与questions(问题数组)。 - 错误处理:网络超时或格式错误会返回明确错误码;置信度异常低(<0.5)通常表示候选集设计缺陷,而非模型故障。
- 成本控制:输入 token 包含状态描述与问题定义,精简上下文可显著降低成本。避免将完整文档作为 state,应提取关键字段。
- 安全实践:API Key 切勿硬编码在前端或公开仓库;生产环境使用环境变量或密钥管理服务注入。
常见问题排查
| 问题现象 | 可能原因 | 解决方案 |
|---|---|---|
| 返回空结果或报错 | 未提供候选集或格式错误 | 检查 questions 数组结构 |
| 置信度持续偏低 | 候选项区分度不足 | 优化选项描述,增加差异点 |
| Agent 未识别 Jev 指令 | Skill 未正确安装 | 重新执行安装命令并重启 Agent |
| 超出免费额度 | 输入 token 过长 | 压缩 state 内容,移除冗余字段 |
Jev 的价值不在理论讨论,而在每一次精准、廉价的判断调用中兑现。掌握上述步骤后,建议从小型验证任务开始(如日志分类、配置校验),逐步扩展至核心业务流。记住:它不是更聪明的聊天机器人,而是更高效的决策零件——用好它的关键,永远是你如何定义问题边界。
© 版权声明
文章版权归作者所有,未经允许请勿转载。