Remotion
Remotion 是一个基于 React 的开源框架,让你能够用代码编写、组合并渲染视频。它将前端开发的工程化优势——如组件化、复用性和状态管理——直接引入视频创作流程。
前 OpenAI 研究员、RLHF(人类反馈强化学习)核心贡献者 Diogo Almeida 正式推出了 TypeSafe AI 及其首款 System One 模型——Jev。Jev 放弃了传统 LLM 的“字符串生成”能力,转而专注于输出类型化的概率决策。它不写文章,不聊天,而是作为一个高速、低成本、无幻觉的“智能函数”,直接嵌入软件...
 TypeSafe AI
不少人都有这样一个疑问:大模型的对话能力早就已经超越普通人,可真正稳定嵌入业务系统、落地自动化流程,为什么依旧困难重重?
TypeSafe AI 的创始人 Diogo Almeida,正是当年参与打造 ChatGPT、深耕指令跟随研究的前 OpenAI 研究员。历时两年隐身研发,他带来了一条完全不同的技术路线——System One 模型,首款产品 Jev。它主动放弃自然语言文本生成,不再服务人类对话,专门输出软件可以直接读取的类型化概率决策。
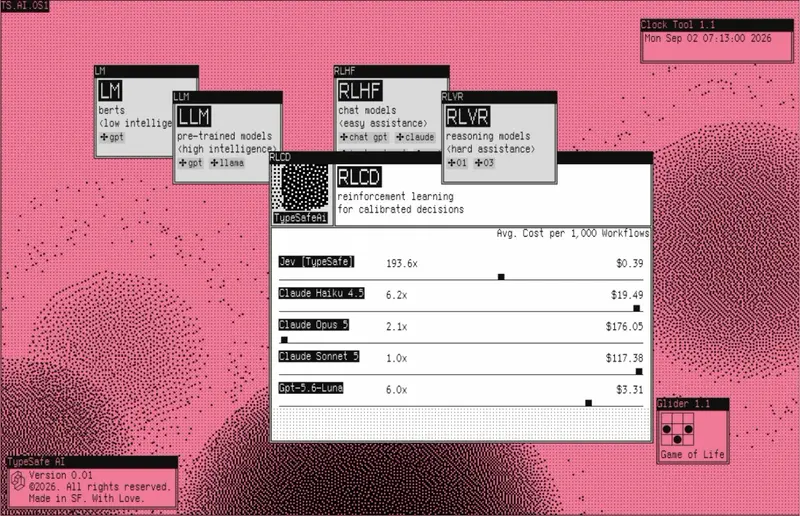
传统LLM是自回归逐token生成字符串。哪怕设定好输出格式,程序拿到文本之后,还要额外解析、校验,很容易遇到格式错乱、幻觉编造内容的问题。同时串行生成带来高延迟,调用成本居高不下,埋在多层业务链路里,很容易拖垮整套系统。
Jev 的整套技术栈全部重新设计,采用全新架构、并行采样器,搭配自研的RLCD校准决策强化学习。输入可以是非结构化文本或者程序状态,输出是提前定义好的结构化结果,自带校准后的概率与置信分数。模型从根源杜绝类型错误,不需要后端代码额外做解析工作。
| 现有LLM | System One + Jev | |
|---|---|---|
| 训练目标 | RLHF人类偏好,生成人类爱看的文本 | RLCD校准决策,输出可信概率判断 |
| 输出形式 | 自由字符串,需要解析校验,存在幻觉风险 | 预定义类型化结构化数据,附带置信度 |
| 采样方式 | 串行逐Token生成 | 并行一次性算出全部决策结果 |
| 响应速度 | 端到端3~329秒 | 70ms~500ms,提速40~200倍 |
| 定价 | 输出Token价格昂贵 | 输入0.042美元/百万Token,输出免费 |
| 置信特性 | 容易过度自信,不确定性很难评估 | 置信度与准确率匹配,结果稳定可预期 |
| 适用场景 | 人机对话、辅助创作、代码助手 | 业务路由、分类打分、实时判断、大数据批量处理 |
官方也坦诚,这里所说的“无幻觉”,不是模型判断永远正确。而是它不会像文本大模型那样编造引用、捏造事实;输出严格限定在预设结构内,不会出现非法格式,解决工程落地里最头疼的类型解析崩溃问题。
团队准备了两组很直观的演示,用来对比Jev和GPT-5.6 Terra的差距。
业务工作流测试是更贴近真实生产环境的场景,在这类任务上Jev站上帕累托最优前沿,最高可以做到193.6倍更快、444.6倍更便宜。当然团队也说明,这个是测试场景下的上限收益,真实业务里的提升幅度会有所浮动,评测本身也存在一定偏差。
还有两个趣味Demo,直观展示模型能力:
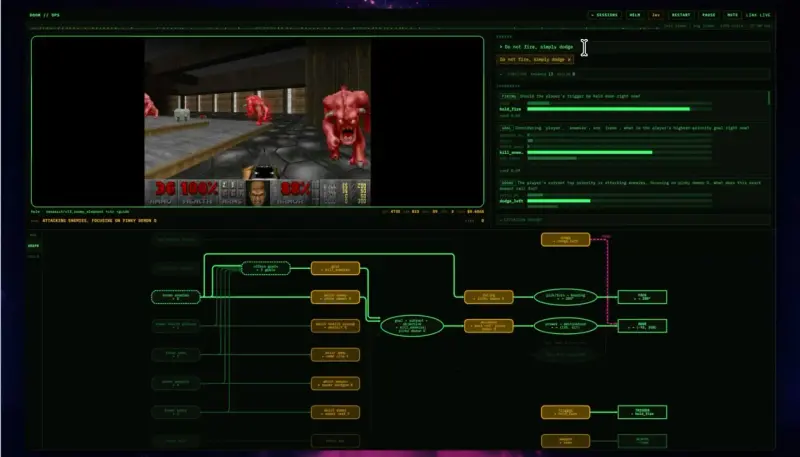
Jev不是用来替代ChatGPT这类对话模型,而是补齐AI自动化底层缺失的判断单元:
目前Jev已经开放早期访问,开发者可以申请体验。TypeSafe AI团队表示,这只是System One系列的起点,后续还会持续迭代,邀请开发者反馈真实场景里的短板。
一句话总结:LLM是给人看的,Jev是给程序读的。它把AI从聊天助手,变成埋在业务底层、低成本、高稳定的智能判断组件。