随着医疗大模型落地问诊辅助、用药咨询、健康管理等真实业务场景,AI输出内容的可靠性、幻觉与安全风险成为关键难题。传统安全方案大多采用外挂式护栏:主模型完成输出之后,再单独调用审核模型重读全部问答文本,判别内容风险。这种方式成本高、推理延迟大,面对长而复杂的上下文理解效果不佳。
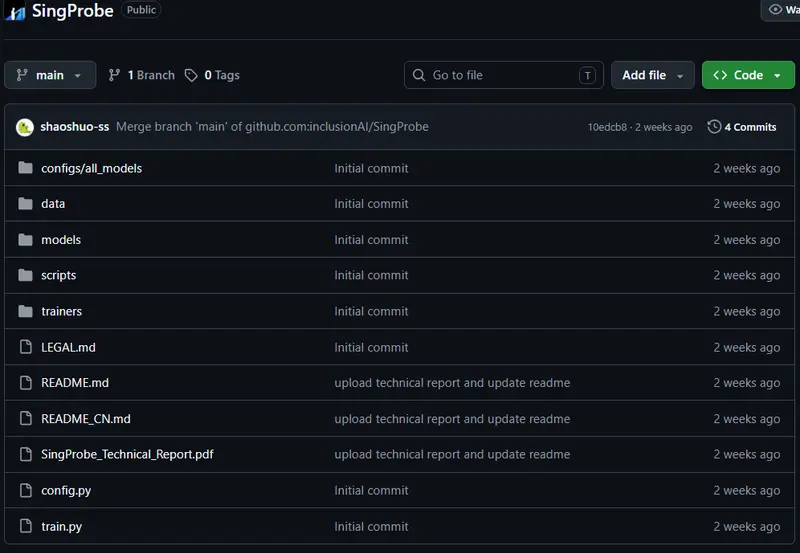
- GitHub:https://github.com/inclusionAI/SingProbe
- 模型:https://huggingface.co/collections/inclusionAI/singprobe
为此蚂蚁开源了SingProbe内生式运行时护栏,核心思路不再额外重读文本,而是直接读取主模型推理过程产生的hidden states(隐状态),配套训练一个仅3–5M参数的轻量探针,如同嵌入模型内部的读数器,在模型逐token生成文本时,同步输出多维度风险分数。
核心能力
探针会对每一个输出token,输出三类核心评估信息:用户输入意图风险、当前生成回答是否存在安全问题、当前片段的幻觉风险。
整套方案支持流式实时预警,风险刚出现就可以触发告警、截断输出、重试回答或者切换推理策略。
在Ling-3.0-flash生产环境解码链路中,SingProbe带来的额外推理开销小于0.5%。在医疗场景下,当模型输出错误内容时,该机制可以现场修正25%的错误;并且不会全程干预生成,只在检测到风险的有限窗口内启动纠偏。
技术架构
SingProbe是基于冻结基座模型多层隐状态的轻量级token级探针训练框架。
- 基座模型(如Ling-3.0-flash)权重完全冻结,通过带token-probe补丁的SGLang启动推理;
- 推理过程实时抽取指定层经过RMSNorm处理后的隐状态,写入tmpfs;
- 探针模型在抽取得到的隐状态数据上训练,输出逐token的10维logits;
- 基座模型不参与梯度更新,仅负责推理与隐状态导出,只有轻量探针参与训练。
Base Model (冻结, SGLang token-probe 服务)
prompt tokens ──► forward with identity token probe
                      │ dump 各层 rmsnorm(hidden_states + residual)
                      ▼
          拼接 → [batch, seq, hidden_dim × num_layers]
                      │
           ┌──────────┴──────────┐
           ▼                     ▼
       GuardMLP           GuardAttnProbe
      (2层 MLP)         (因果MQA token探针)
           │                     │
           └──────────┬──────────┘
                      ▼
         per-token logits [batch, seq, 10]
10维输出维度定义
| 维度 | 任务 | 说明 |
|---|---|---|
| 0–6 | Query风险多标签 | 7类风险标签,支持多标签同时命中 |
| 7 | Query Safe | 和0–6风险标签互斥,代表用户提问安全 |
| 8 | Response Safety | 该维度大于0代表模型回答存在安全风险 |
| 9 | Response幻觉 | token粒度幻觉识别 |
数据集采用选择性标注,每个数据集仅标注对应任务维度,其余维度使用无监督标签(-100)。
两种探针架构可选
- GuardMLP(mlp):两层MLP结构,实现简单,算力开销更低。
- GuardAttnProbe(attn):因果MQA探针,包含q/k/v投影、因果MQA、输出投影、残差连接与RMSNorm,最后接入逐token线性分类头,对时序上下文感知能力更强。
两种架构使用相同的隐状态输入,训练脚本train.py根据配置参数自动选择对应架构。
适用场景与价值
- 医疗大模型问诊、用药咨询等高风险场景,实时识别不安全回答、事实幻觉;
- 长上下文对话场景,规避外挂审核模型带来的二次推理延迟与高额算力成本;
- 流式输出场景,实现风险早发现、早干预,而不是等完整回答生成后再校验。
方案特点总结
✅ 内生式检测,复用主模型推理中间隐状态,不需要二次完整重读文本
✅ 轻量探针仅3–5M参数,基座模型全程冻结
✅ token级流式风险评估,风险可实时拦截、局部纠偏
✅ 生产环境额外推理开销<0.5%,性能损耗极低
✅ 两种探针架构可选,适配不同算力与精度需求
© 版权声明
文章版权归作者所有,未经允许请勿转载。