ComfyUI-Viggle-Animate-H3 是将 Viggle-Animate 的强大能力引入 ComfyUI 生态的开源节点套件。它基于 MiniMax-H3 ref2va Transformer 的 331 亿参数全量微调版本,通过 DMD2 蒸馏技术,实现了仅需 4 步采样(3 次前向传播) 即可完成的视频角色替换。
- GitHub:https://github.com/Saganaki22/ComfyUI-Viggle-Animate-H3
- 模型:https://huggingface.co/drbaph/Viggle-Animate-ComfyUI
该工作流摒弃了传统的文本编码器和提示词,转而使用预计算的冻结嵌入,极大地降低了推理开销,使得在消费级硬件上运行高质量的角色替换成为可能。
核心特性
- 极速推理:得益于 DMD2 蒸馏,采样步数压缩至 4-8 步,显著缩短渲染时间。
- 零提示词依赖:使用 Qwen3-VL 预计算的 362 token 冻结嵌入 (
fixed_embed_fwd_anyframe.safetensors) 替代文本编码器,确保每次渲染条件一致且高效。 - 精准控制:动作、运镜、节奏、背景和光线完全继承自驱动视频;身份特征则严格来自参考图。
- 消费级友好:提供多种量化版本的模型权重,适配从 32GB 到 96GB+ 显存的不同硬件配置。
安装与权重准备
1. 安装节点
cd ComfyUI/custom_nodes
git clone https://github.com/Saganaki22/ComfyUI-Viggle-Animate-H3
2. 下载权重 (推荐 Hugging Face: drbaph/Viggle-Animate-ComfyUI)
| 组件 | 路径 | 推荐文件 | 说明 |
|---|---|---|---|
| 扩散模型 | ComfyUI/models/diffusion_models/ | minimax_h3_ref2va_viggle_pruned_int8_convrot.safetensors (21 GB) | 推荐:适配 32GB 显卡,含低秩 adaln_proj 剪枝。 |
| DMD LoRA | ComfyUI/models/loras/ | viggle_animate_dmd_lora_r64.safetensors (0.94 GB) | 必需:SVD 截断版,保留 99.26% 谱能量,将采样压缩至 4 步。 |
| 冻结文本条件 | ComfyUI/models/text_cond/ | fixed_embed_fwd_anyframe.safetensors | 362 token 冻结嵌入,完全替代文本编码器。 |
| VAE | ComfyUI/models/vae/ | minimax_h3_video_vae_fp16.safetensors | 来自基础模型,非微调仓库。 |
工作流配置指南
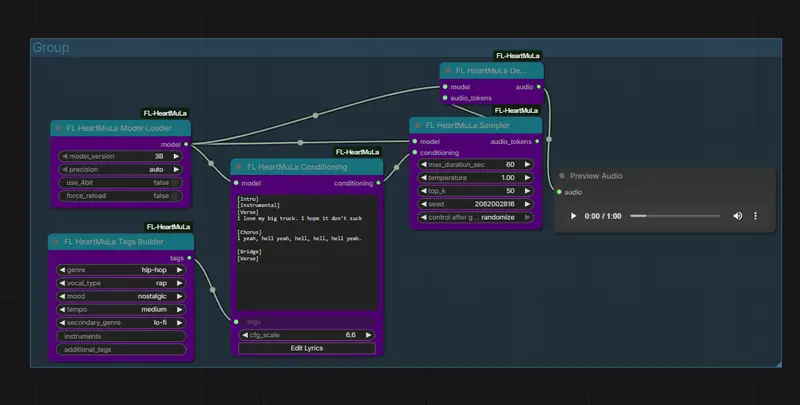
关键节点连接逻辑
- Load Diffusion Model: 加载
pruned_int8_convrot模型。 - Load LoRA (Model Only): 加载
viggle_animate_dmd_lora_r64,Strength 设为 1.0。 - ModelSamplingMiniMaxH3: 设置
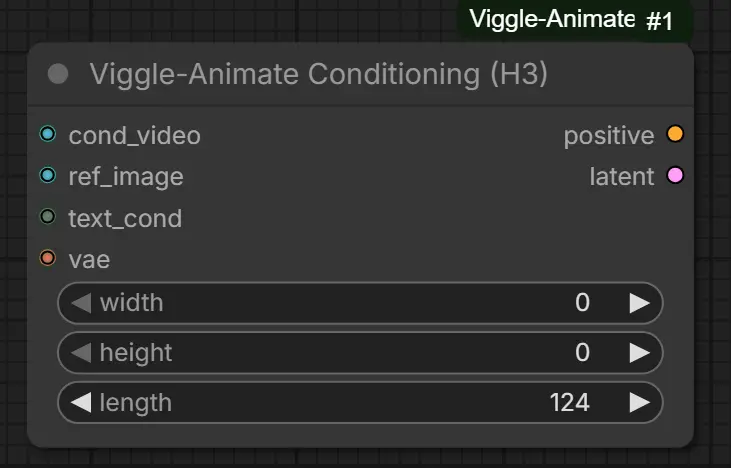
shift_video = 3.0,shift_audio = 3.0。注意:基础默认值 12 不适用于此蒸馏模型。 - Viggle-Animate Conditioning (H3):
- 输入:驱动视频 (Load Video)、参考图 (Load Image)、VAE、冻结文本条件。
- 逻辑:视频优先的参考顺序,两个参考均按驱动视频短边嵌套。
- KSampler:
- Steps: 4 – 8 (4 步为最佳工作点,更多步数可能导致过度锐化)。
- CFG: 1.0。
- Scheduler: Euler / Beta。
- VAE Decode & Save Video: 输出最终视频。
关键参数设置
- 驱动视频长度:将
Load Video的frame_load_cap设为具体帧数(如 124),确保输出长度一致。 - 分辨率:Width/Height 设为 0 以继承驱动视频的几何尺寸(输出轴必须是 32 的倍数)。测试画布范围建议在 0.4–0.98 百万像素之间。
- 显存优化:可与 Comfy Kitchen 和 block sparse attention 补丁叠加使用以进一步降低显存占用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。