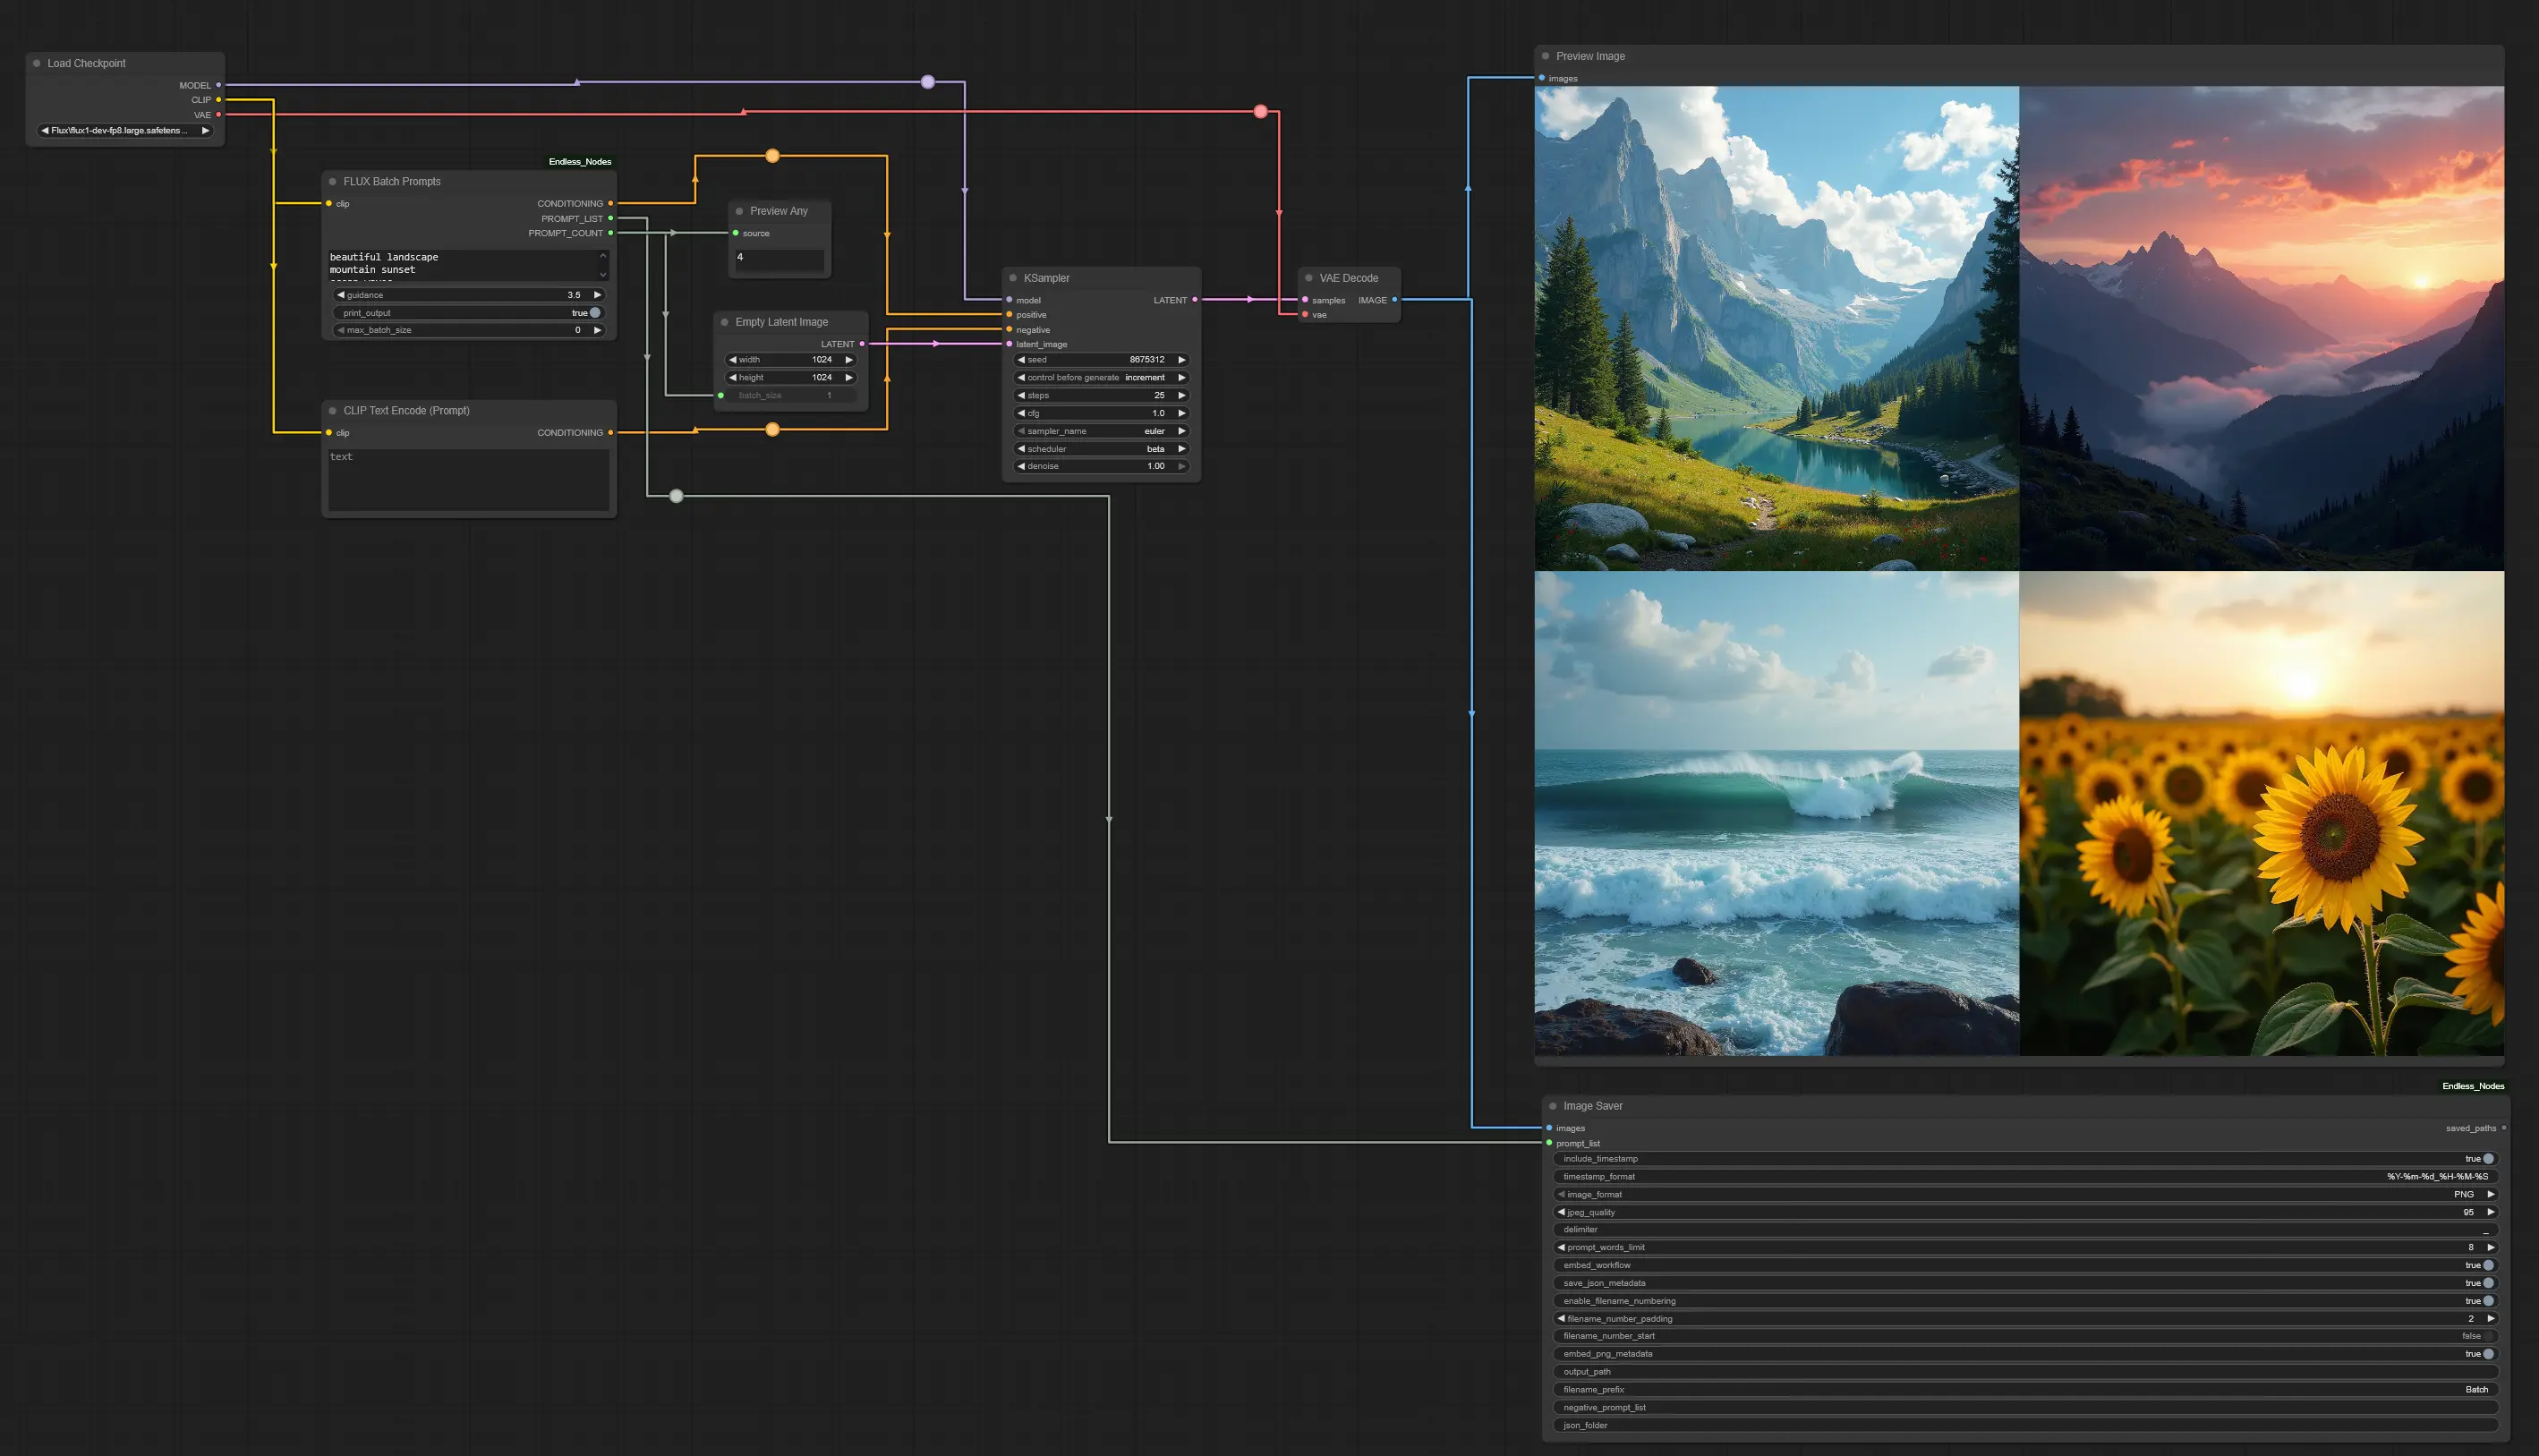
ComfyUI-Ref2VA-VSA 是一个针对 MiniMax H3 Ref2VA(参考到视频)模型的推理加速补丁。它成功将视觉稀疏注意力(VSA)技术应用于复杂的 Ref2VA 工作流,在单张消费级 NVIDIA GeForce RTX 4090 (24GB) 上,将生成 5 秒(124 帧)高质量角色视频的耗时从原本的 10 分钟以上大幅压缩至 72 秒(预热后),同时显存占用降低至约 13.5 GB。
- GitHub:https://github.com/Kablex/ComfyUI-Ref2VA-VSA
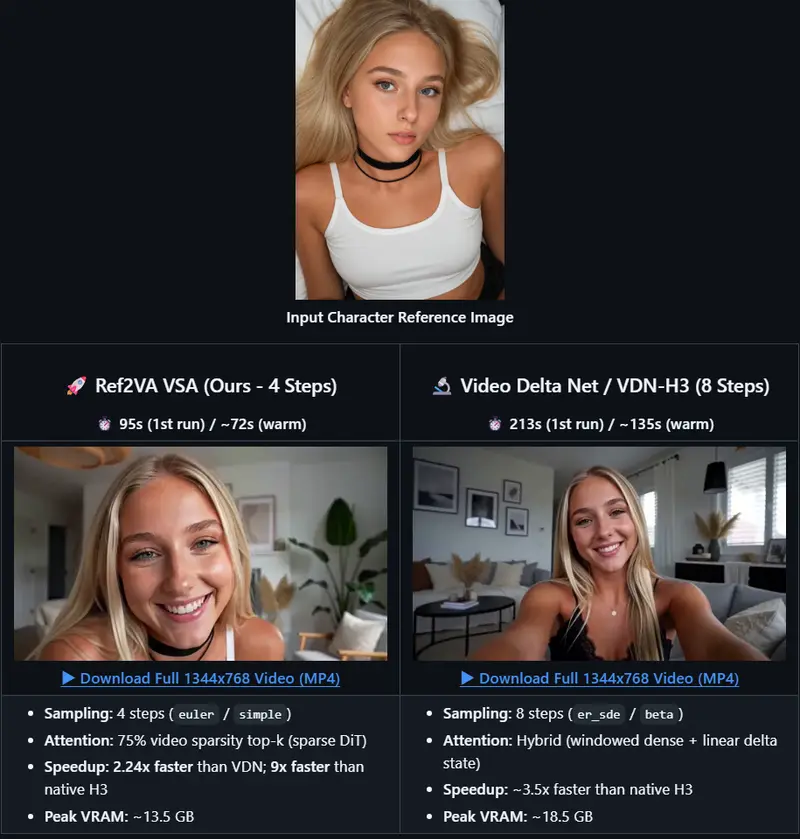
性能突破:速度与显存的双重优化
在相同的硬件(RTX 4090)、提示词、种子和分辨率(1344×768, 124 帧)下,不同管道的表现对比如下:
| 管道 | 注意力机制 | 步数 | 首次运行延迟 | 预热耗时 | 峰值显存 |
|---|---|---|---|---|---|
| Ref2VA VSA (本方案) 🚀 | 75% 视频稀疏 + 密集前缀 | 4 步 | 95.2s | ~72s | ~13.5 GB |
| MiniMax H3 原生密集 | 密集全局 Softmax | 50 步 | ~650s | ~650s | ~22.5 GB |
| H3 Turbo LoRA (密集) | 密集全局 Softmax | 4 步 | ~210s | ~190s | ~21.0 GB |
| Video Delta Net (VDN-H3) | 窗口 + 线性 Delta | 8 步 | 213.0s | ~135s | ~18.5 GB |
核心优势:相比原生密集模型,速度提升近 9 倍,显存节省 40%;相比其他加速方案,在保持 4 步采样的同时实现了最低的显存占用和最快的推理速度。
技术难点与解决方案
为什么 Ref2VA 难以应用 VSA?
FastVideo 开创的视觉稀疏注意力(VSA)通过聚类 3D 时空块并剪枝 75–90% 的块来加速。但 Ref2VA 包含动态多模态条件段(参考图像、音频、文本),朴素的 3D 分块会打乱这些模态的令牌,破坏身份保真度。
解决方案:Ref2VAVSAGatePatch
该补丁通过两层精心设计的注意力布局解决了这一冲突:
- 多模态密集豁免前缀:将文本、参考图像和音频令牌隔离在独立的块中,并完全豁免于 top-k 剪枝。这确保了参考令牌始终保持 100% 密集,从而严格保证角色身份的一致性。
- 仅视频稀疏注意力:VSA 的 top-k 剪枝严格仅应用于生成的视频键块,在不影响身份的前提下最大化加速。
- 门控移植:将 50 个学习的
to_gate_compress投影矩阵直接移植到 Ref2VA 基础模型中。
安装与配置
1. 环境要求
- ComfyUI(支持原生 MiniMax-H3 的最新版本)
comfy-kitchen(需安装 CUDAsol_attn支持)- PyTorch 2.4+ / CUDA 12.1+
- NVIDIA GPU (24GB+ 显存,如 RTX 3090/4090, A5000, L40S)
2. 模型下载与放置
请将以下文件放入对应的 ComfyUI/models/ 子目录:
| 模型类型 | 文件名 | 目标目录 | 来源 |
|---|---|---|---|
| 扩散模型 | minimax_h3_ref2va_pruned_int8_convrot.safetensors | diffusion_models/ | Comfy-Org |
| VSA Gate | fasth3_vsa_gate.safetensors | loras/ | Hugging Face / 自行提取 |
| Turbo LoRA | minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors | loras/ | LightX2V |
| 文本编码器 | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | text_encoders/ | Comfy-Org |
| 视频 VAE | minimax_h3_video_vae_fp16.safetensors | vae/ | Comfy-Org |
| 音频 VAE | minimax_h3_audio_vae_fp32.safetensors | vae/ | Comfy-Org |
3. 安装节点
cd ComfyUI/custom_nodes
git clone https://github.com/Kablex/ComfyUI-Ref2VA-VSA
重启 ComfyUI 后,可在 FastH3/VSA 分类下找到 Ref2VA VSA Gate Transplant (EXPERIMENTAL) 节点。
工作流接线指南
推荐使用仓库提供的 workflows/ref2va_vsa_4step_rtx4090.json 工作流。核心接线逻辑如下:
- 加载模型:使用
UNETLoader加载 INT8 版本的 Ref2VA 模型。 - 加载 LoRA:通过
LoraLoaderModelOnly加载 Turbo 4-Step LoRA (Strength=1.0)。 - 应用 VSA Patch:连接
Ref2VAVSAGatePatch节点,加载fasth3_vsa_gate.safetensors,设置稀疏度为 0.75。 - 参数调整:使用
MiniMaxH3SigmaShift设置shift_video=12,shift_audio=3。 - 采样设置:步数设为 4,采样器选择 Euler。
进阶:自行提取 Gate 文件
如果你拥有 FastH3 VSA 基础检查点,可以使用附带脚本自行提取 Gate 权重:
python tools/extract_vsa_gate.py \
    --input /path/to/minimax_h3_fastvideo_vsa_datafree_1300step_4step_int8_convrot.safetensors \
--output /path/to/ComfyUI/models/loras/fasth3_vsa_gate.safetensors© 版权声明
文章版权归作者所有,未经允许请勿转载。