ComfyUI-VDN-H3 是一个专为 MiniMax-H3 模型设计的 ComfyUI 插件,它将加州大学伯克利分校等机构发布的 Video Delta Net (VDN) 混合注意力架构以原生节点的形式引入消费级硬件。该插件通过运行时模型补丁技术,在不修改 ComfyUI 核心文件的前提下,将长距离时序注意力的计算复杂度从平方级降低为线性级,从而显著提升视频生成的效率,同时保持近乎无损的视觉质量。
- GitHub:https://github.com/Saganaki22/ComfyUI-VDN-H3
核心亮点
- 线性复杂度加速:
- 将远距离时序上下文交给 Video Delta Attention 线性分支处理,替代昂贵的 Softmax 注意力。
- 视频越长,收益越大。在 RTX 5090 上实测,145 帧视频生成速度提升显著(约 2.6 倍架构性加速)。
- 近乎无损的质量:
- 保留邻近帧的精确 Softmax 注意力(窗口半径 r=1, chunk=5),确保局部细节与短期稳定性。
- 通过双向边界锚点(Anchor Frames)维持全局一致性,视觉上与原版 H3 几乎无法区分。
- 消费级硬件友好:
- 纯 PyTorch 实现:无需 Triton、FlashAttention-4 或 CUDA 编译,零新增依赖,Windows/Linux 均可运行。
- 灵活显存管理:支持
stream模式(按块流动,小显存安全)和cache_gpu模式(常驻显存,更快)。
- 即插即用:
- 作为独立节点接入工作流,无需改动原有的条件、LoRA、采样器及 VAE 解码流程。
- 支持官方发布的 8 步蒸馏模型(Turbo)和 50 步标准模型。
安装与配置
1. 安装插件
cd ComfyUI/custom_nodes
git clone https://github.com/Saganaki22/ComfyUI-VDN-H3
# 重启 ComfyUI
2. 下载 VDN 检查点
从 Hugging Face 下载 VDN 分支权重与适配器,并保持目录结构不变:
# 示例:下载 8 步蒸馏模型阶段
hf download OpenVDN/vdn-minimax-h3 stage-dmd-step-250 --local-dir <ComfyUI>/models/vdn
注意:VDN 发布版不包含基座权重,需自行准备 MiniMax-H3 基座模型。
3. 所需模型清单
| 组件 | 文件名示例 | 存放路径 |
|---|---|---|
| 基座扩散模型 | minimax_h3_fl2va_int8_convrot.safetensors | models/diffusion_models |
| 文本编码器 | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | models/text_encoders |
| 视频/音频 VAE | minimax_h3_video_vae_fp16.safetensors 等 | models/vae |
| VDN 分支+适配器 | stage-dmd-step-250/ (8步) 或 stage-b-step-2000/ (50步) | models/vdn |
节点使用指南
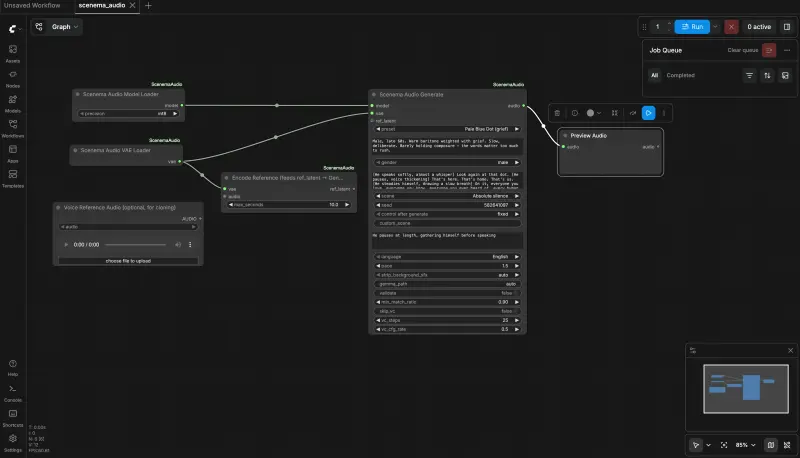
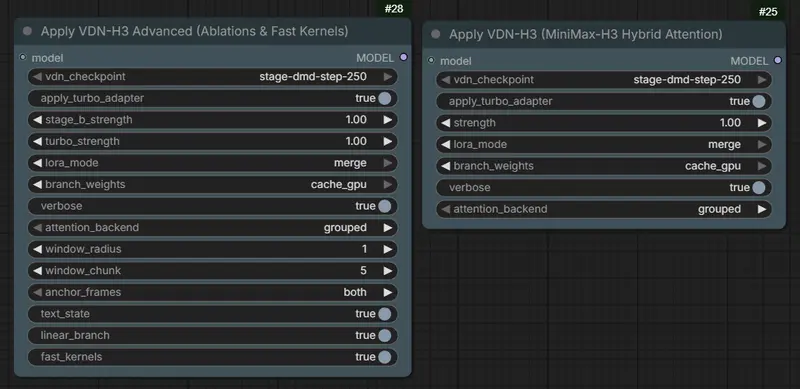
在工作流中,将 Apply VDN-H3 节点串联在 MiniMax-H3 模型加载器与采样器之间。
关键参数说明
vdn_checkpoint:选择models/vdn下的对应阶段目录。apply_turbo_adapter:- 开 (True):启用官方 8 步蒸馏模型适配器(采样器设为 8 步)。
- 关 (False):启用 50 步标准模型适配器(采样器设为 ~50 步)。
branch_weights:stream(默认):分支权重按块流动到 GPU,显存增量小,适合大多数用户。cache_gpu:权重常驻显存,速度略快,但需预留约 4.3 GB 显存。
lora_mode:bypass:运行时注入,精度更锐利。merge:合并进权重,显存占用最低,但在 INT8/FP8 基座上可能略软。
attention_backend:grouped(默认):每个窗口组进行一次稠密 SDPA,稳定且兼容性好。flex:使用编译的 FlexAttention 内核,在特定长度下可能有优势。
重要注意事项
- 不要叠加 SOL 补丁:请勿将 “MiniMax H3 Scheduled Sol Attention” 与本节点同时使用,因为它们修改的是同一路径,会导致 VDN 线性分支被跳过。
- 步数匹配:若使用 8 步 Turbo 适配器,务必将采样步数设为 8;若使用 50 步适配器,则设为 50 左右。混用会导致质量下降。
- 短片段回退:当潜在帧数 ≤ 15 时,窗口已覆盖全部序列,VDN 会自动回退到稠密注意力,这是正常行为。
- 单卡限制:本移植仅支持单卡运行,未实现官方的多卡 Ulysses 并行。
性能预期
在 RTX 5090 上,使用 INT8 ConvRot 基座、Stream 模式、8 步采样生成 1280×736 / 145 帧 视频:
- 耗时:约 17 秒/it(总采样时间约 2 分 15 秒)。
- 对比:相比纯 H3 模型,架构性加速约 2.6 倍。虽然不及官方 8xB200 集群的 74.5 倍头条数字,但在单卡消费级硬件上已属巨大突破。
© 版权声明
文章版权归作者所有,未经允许请勿转载。