在本地跑开源权重大模型,真正的门槛往往不在模型能力本身。确认显存容量、挑选合适量化版本、调整上下文长度、配置GPU分层,下载完权重才发现硬件空间不足,是很多人的常态。
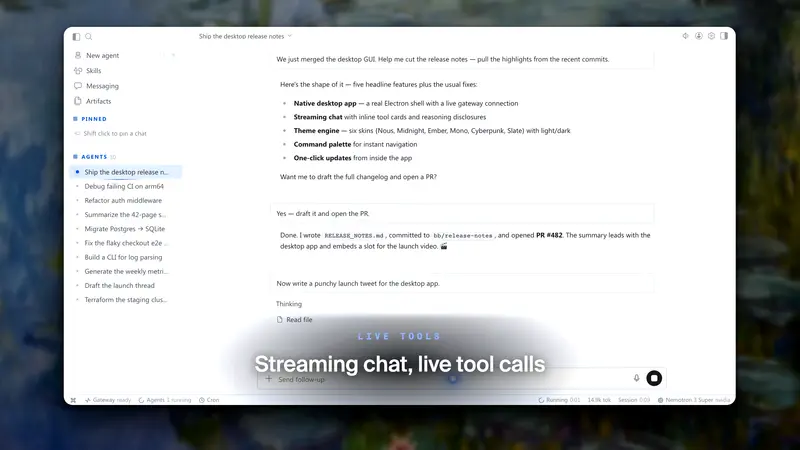
Nous Research 在 Hermes Desktop 当中加入一键本地模型配置功能,把整套繁琐流程封装成傻瓜式操作。工具自动读取本机硬件信息,挑选适配模型、下载权重、完成推理运行时配置。
授权与平台:Hermes Desktop 是开源项目 Hermes Agent 的 MIT 许可免费桌面客户端;支持 macOS 12+、Windows 10/11、全系列 Linux 发行版,运行本地模型不需要注册账号。
新功能实际能力
一键部署向导会在软件首次启动自动弹出,后续也可以通过「设置 → 提供商 → 本地模型」入口重新调出。
底层 Hermes 会自行管理 llama.cpp 推理引擎:自动拉取对应硬件平台的 llama.cpp 官方编译包,完成校验并自动维护版本更新。后端完整支持 CUDA、Metal、Vulkan、HIP、纯CPU推理。
运行参数保存在 config.yaml 的 local_runtime 配置块,桌面UI会自动写入参数;无头命令行环境用户也可以手动修改配置文件。
硬件适配评估与量化策略
下载模型之前,软件会先针对本机硬件做完整评估。模型列表会用颜色标识运行状态:
- 🟢绿色:完整跑在GPU显存内,性能最佳
- 🟡黄色:部分权重溢出到系统内存,速度下降
- 🔴红色:当前硬件无法承载该模型
列表同时展示模型起始/最大上下文窗口,以及对应版本的下载体积。
量化版本自动选择逻辑:优先挑选可以完整驻留GPU显存的最高质量权重;显存有限设备自动选用同模型更紧凑的量化版本。最低底线为4‑bit量化,Nous 认为低于4bit会带来不可接受的效果衰减。
如果硬件连4bit版本都无法无溢出运行,该模型将直接判定为不可运行。不兼容模型依旧会保留在列表并标注原因,方便用户直观了解显存提升带来的收益。
内存调度机制
Hermes 把内存调度全部封装,不向用户开放手动调节旋钮。
模型初始使用完全适配GPU显存的上下文窗口,对话过程按需扩展至该模型原生上限;所有推荐模型保底拥有 64K上下文窗口。
显存溢出时的卸载策略很有特点:优先把专家权重转移到系统内存,永远不会卸载注意力缓存,牺牲部分吞吐性能来保障上下文完整性。
对话压缩摘要只会在抵达最大上下文上限之后才触发。模型闲置15分钟自动卸载释放硬件资源,收到新消息时重新加载。
核心要点总结
- 一键向导自动识别硬件,自动选型、下载、配置本地推理环境。
- 内置托管 llama.cpp,隐藏上下文、GPU分层、量化等复杂参数,无需手动调参。
- 下载前硬件预检,绿/黄/红三色直观展示模型运行可行性。
- 推荐模型最低保障64K上下文,拥有优先级可控的内存溢出卸载逻辑。
© 版权声明
文章版权归作者所有,未经允许请勿转载。