GitHub 正式发布了 Project HydraFusion(研究预览版),这标志着 AI 编码助手从“单一模型选择”迈向了“动态工作流编排”。HydraFusion 不再将用户的提示简单地路由给某个固定模型,而是为每个请求实时构建一个执行计划。它可以根据任务复杂度,智能地组合多个来自不同提供商的模型进行起草、评审或升级,从而在质量与成本之间找到最优解。
- 官方介绍:https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration
核心机制:为每个请求构建执行计划
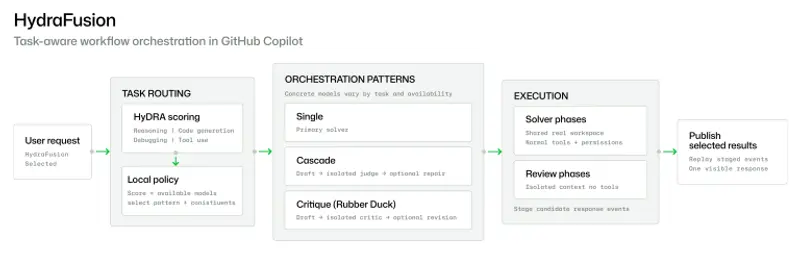
HydraFusion 继承了 GitHub 早期的 Auto Model Selection 能力,但将其提升为一个优化问题。系统会读取推理、代码生成、调试和工具使用的能力信号,然后选择预期能通过质量门槛的最低复杂度工作流。只有在必要时,才会花费额外的模型调用来提升结果。
目前,HydraFusion 支持三种执行模式:
- Single(单模型):由一个选定模型直接解决问题,保持最快响应速度。
- Cascade(级联):高效模型先起草解决方案,随后通过质量门控。若未达标,则自动升级到更强的模型重试。
- Critique(批判):一个模型起草,另一个来自不同模型家族的独立只读评审者进行审查,起草模型根据反馈修订一次。这种跨家族的“橡皮鸭”式评审能有效发现盲点。
工程防护栏:安全与可控
为确保仓库级工作的安全性,GitHub 为 HydraFusion 构建了五项核心原则:
- 完整核算:记录起草、评审、修订、升级、重试和回退等每个环节的成本与延迟。
- 有界执行:每个环节都有显式超时和取消机制,防止无限循环。
- 隔离评审:评审者在无工具上下文中运行,绝不能修改仓库代码。
- 故障安全应用:当工作流被取消或验证失败时,绝不应用任何补丁。
- 验证路由:在执行前验证模型绑定、回退行为和可用性。
基准测试:成本大幅降低,质量稳中有升
在三个代理编码基准测试中(以 Claude Opus 5 为基线),HydraFusion 展现了显著的成本效益:
| 基准测试 | 估算成本变化 (vs Opus 5) | 验证任务质量变化 | 备注 |
|---|---|---|---|
| TerminalBench 2.1 | ↓ 67% | +4.9 分 | 复杂终端任务,质量与成本双优 |
| DeepSWE | ↓ 36% | -1.5 分 | 软件工程任务,成本显著降低 |
| CheckpointBench | ↓ 65% | -0.1 分 | GitHub 内部多轮真实会话集合 |
注:CheckpointBench 锚定到不可变的公共提交,确保运行结果可重放。虽然在 DeepSWE 和 CheckpointBench 上质量略逊于 Opus 5,但成本降幅巨大,且差距极小。
如何启用与计费
- 适用范围:目前仅作为研究预览版在 GitHub Copilot CLI 中提供,面向所有 Copilot 计划用户。无开放权重,不支持自托管。
- 启用步骤:
/update /experimental on /model # 选择 "HydraFusion (Research Preview)" - 计费方式:按工作流中每个模型实际消耗的令牌数计费,费率与各模型的标准费率一致。没有额外的编排费用。
为什么 HydraFusion 很重要?
HydraFusion 代表了 AI 编码工具的新范式:模型不再是静态的配置项,而是动态的计算资源。通过将工作流选择视为优化问题,它让开发者无需在“昂贵的高质量模型”和“廉价的低质量模型”之间做艰难抉择。系统会自动为简单任务节省开支,为复杂任务投入算力,并在必要时引入外部视角进行纠错。
对于日常使用 Copilot CLI 的开发者而言,这意味着在不增加预算的前提下,获得更稳定、更智能的编码辅助体验。随着未来更多模式和模型的加入,HydraFusion 有望成为 AI 编程助手的默认运行方式。
© 版权声明
文章版权归作者所有,未经允许请勿转载。