在LLM应用的生产环境里,大量用户提问只是表达方式不一样,但背后意图完全一致。传统方案会把每一句改写后的提问都当成全新请求,完整消耗大模型token。Redis LangCache是一款托管语义缓存服务,部署在应用和大模型之间,按照语义含义匹配历史回答,而不是严格比对文本。当找到相似度足够高的历史记录时,直接返回缓存结果,不再调用LLM。Redis官方称,这项服务最高可减少90%的API成本,缓存命中场景下响应速度最高提升15倍。
- 地址:https://redis.io/langcache
该服务现已在Redis Cloud开放公开预览,通过REST API接入,配套Python与JavaScript SDK;预览阶段产品功能和行为仍可能调整。
痛点:同义转述依旧触发完整LLM调用
以客服助手场景为例,下面三句话提问措辞不同,但答案完全相同:
- “购买月度计划后我可以退款吗?”
- “月度订阅可退款吗?”
- “我可以取消计划并拿回我的钱吗?”
没有语义缓存的情况下,每一条都会完整执行模型推理,消耗输入、输出token并产生等待时延。
很多开发者会使用前缀缓存优化,但它只能复用系统提示、上下文对应的KV缓存,请求依然会抵达大模型,依旧要处理新token、解码生成内容。前缀缓存只是降低单次调用成本,无法彻底跳过模型。
LangCache 的工作原理
LangCache把缓存放在大模型外部,直接存储完整的模型返回结果,整体是两次请求的工作流:
- 调用LLM之前,应用把提示词发送到LangCache检索接口
POST /v1/caches/{cacheId}/entries/search。 - LangCache为提示生成向量嵌入,对存量缓存条目做向量检索。
- 如果检索到相似度超过设定阈值的记录,直接返回缓存回答,不会发起任何LLM调用。
- 缓存未命中时,正常调用你选定的大模型;拿到模型返回结果后,通过
POST /v1/caches/{cacheId}/entries存入缓存,供后续相似提问复用。
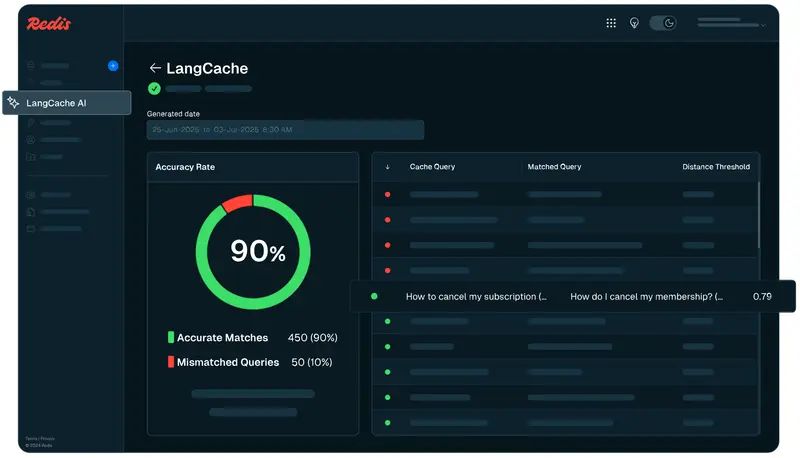
向量嵌入可以使用服务内置模型,也支持接入你自己的嵌入模型。缓存能力可通过相似度阈值、TTL过期策略、淘汰规则、自适应控制来平衡准确率与召回率。底层基于Redis向量数据库构建,以REST API对外暴露,兼容任意大模型厂商、支持多语言。命中率与成本节省数据,都可以在Redis Cloud控制台查看。
缓存命中,到底省下了什么
缓存命中会直接省去输入token、输出token开销,同时消除模型解码带来的延迟。
官方演示对比:直接调用模型耗时2.232秒,消耗514输入token、250输出token;LangCache缓存返回仅0.37秒,不消耗任何LLM token,本次测试提速约6倍。
Redis文档对成本节省做了清晰界定:缓存命中不用支付输出token费用,而嵌入生成、存储会带来少量成本,通常用下面公式预估月度节省:
预计月度节省 =(月度输出令牌成本)×(缓存命中率)
举个例子:每月LLM总花费200美元,其中60%为输出token费用,缓存命中率50%,每月可节省60美元。Redis还提供计算器,用来估算年度成本节约。
官方公告写缓存命中最高提速15倍、token用量最多降低70%;产品页面标注成本最高节省90%。客户Mangoes.ai的语音护理应用实测命中率70%,LLM支出削减70%,响应速度提升4倍。实际收益取决于业务流量里,语义重复请求的占比。
使用语义缓存必须留意的风险
语义缓存的核心难点,不是配置参数,而是判断哪些场景可以安全复用旧答案。
相似度阈值设置过低,可能把不匹配问题的历史答案返回给用户;阈值过高,大量同义提问依然会打到LLM,缓存带来的收益会大打折扣。生产环境需要精细调优相似度阈值、设置过期策略淘汰过时内容、做好租户数据隔离,持续监控误匹配情况。
LangCache提供访问权限控制、自定义过滤规则、TTL、淘汰策略以及Redis Cloud监控能力来应对这些问题。用户数据保存在自身Redis服务内,Redis表示不会读取这些数据,也不会拿它训练模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。