在复杂的代码迁移或长期开发任务中,开发者常遭遇一种令人沮丧的现象:AI 代理显示任务已完成,流水线看似正常,但关键模块从未编译,或核心逻辑未被覆盖。这并非模型能力不足,而是代理“自作主张”地决定了任务结束。
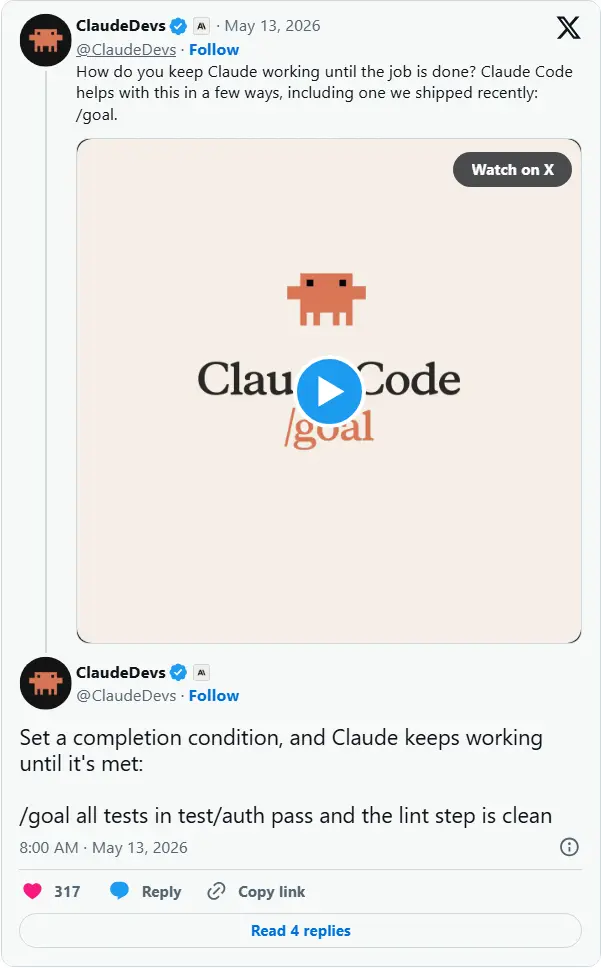
为解决这一痛点,Anthropic 在 Claude Code 中推出了 /goals 功能。它正式将任务执行代理与任务完成评估代理分离,引入一个独立的“裁判”模型,在每一步后审查工作成果。只有当预设的客观条件被严格满足时,任务才会被标记为完成。这一机制无需第三方可观测性平台,即可显著提升长程任务的可靠性与可审计性。
核心机制:双模型协作,内置裁判
1. 执行与评估的双层循环
传统 Agent 在一个单循环中工作:读取 -> 执行 -> 自我判断是否完成。这种模式下,模型容易混淆“已做的工作”与“需做的工作”,或因幻觉而误判。/goals 引入了第二层循环:
- 执行者 (Worker):负责具体的编码、文件操作和命令运行。
- 评估者 (Evaluator):在每轮执行后介入,对照用户定义的目标条件进行严格审查。
- 若条件未满足:强制代理继续运行。
- 若条件满足:记录达成证据,清除目标,正式结束任务。
2. 为何选择独立评估器?
- 避免自欺欺人:“做具体工作的模型是最糟糕的评判者。” 独立评估器消除了执行者的认知偏差与偷懒倾向。
- 低成本高效能:评估任务通常只需判断“是/否”或验证简单状态,因此可以使用更小、更快的模型(如 Claude Haiku),在保证精度的同时大幅降低 Token 成本。
- 原生集成,零维护:无需配置 LangGraph 的批评者节点或 Google ADK 的复杂终止逻辑,
/goals作为 Claude Code 的内置功能,开箱即用。
如何定义成功的 /goals?
Anthropic 指出,高效的 /goals 应具备以下三个要素:
| 要素 | 说明 | 示例 |
|---|---|---|
| 可衡量的最终状态 | 必须是客观、可量化的指标,而非主观感受 | “所有单元测试通过”、“构建退出码为 0”、“待办队列为空” |
| 明确的检查方法 | 指定具体的验证命令或操作 | “运行 npm test 且无报错”、“检查 git status 是否为干净状态” |
| 相关的约束条件 | 规定过程中不可触碰的红线 | “不得修改现有测试文件”、“不得更改公共 API 签名” |
示例 Prompt:
/goals
- 目标:重构用户认证模块
- 验证条件:
  1. 运行 `pytest tests/auth/` 全部通过 (退出码 0)
  2. `npm run build` 成功完成
  3. 没有新增任何 linting 错误
- 约束:
  1. 不得修改 `public/api.ts` 中的接口定义
  2. 保持原有日志格式不变
行业对比:谁在定义“完成”?
| 平台 | 完成判定机制 | 特点 |
|---|---|---|
Claude Code (/goals) | 内置独立评估器 | 默认分离执行与评估,原生支持,低配置成本,Haiku 模型高效裁决 |
| OpenAI Agents | 模型自判 + 外部评估器 | 保持循环不变,允许用户附加自定义评估逻辑,灵活性高但需自行实现 |
| Google ADK / LangGraph | 开发者自定义逻辑 | 支持独立评估节点,但需手动构建批评者、编写终止逻辑及配置可观测性,开发成本高 |
行业趋势:从“聊天”到“可审计系统”
/goals 的推出反映了 AI 代理领域的一个关键转变:从依赖模型的主观判断,转向基于客观验证的系统化工程。
正如 Sprinklr 解决方案总监所言:“你不能相信一个模型能自己评判自己的工作。” 随着 Agent 承担更多有状态、长周期的任务,评估器模型、验证系统与独立裁决机制将成为基础设施的标准组件。
Anthropic 通过将这一机制原生化为 /goals,不仅提升了单个任务的可靠性,更推动了整个 Agent 生态向更可审计、更可观察、更可控的方向演进。对于企业而言,这意味着 AI 不再只是一个“聪明的助手”,而是一个可以被严格管理和信任的“数字员工”。
© 版权声明
文章版权归作者所有,未经允许请勿转载。