百度PaddleOCR 3.5 重磅更新:原生支持 Hugging Face Transformers 后端,无缝集成 RAG 与文档 AI 工作流,PP-OCRv5 性能再升级
在构建 RAG(检索增强生成)、文档 AI 及智能代理应用时,高质量的文档结构化数据是基石。然而,传统 OCR 工具往往独立于主流深度学习生态,导致集成复杂、维护成本高。PaddleOCR 3.5 是百度飞桨推出的最新版本,首次引入 Hugging Face Transformers 作为官方支持的推理后端。
- 文档: https://www.paddleocr.ai
- GitHub: https://github.com/PaddlePaddle/PaddleOCR
- 模型: https://huggingface.co/PaddlePaddle
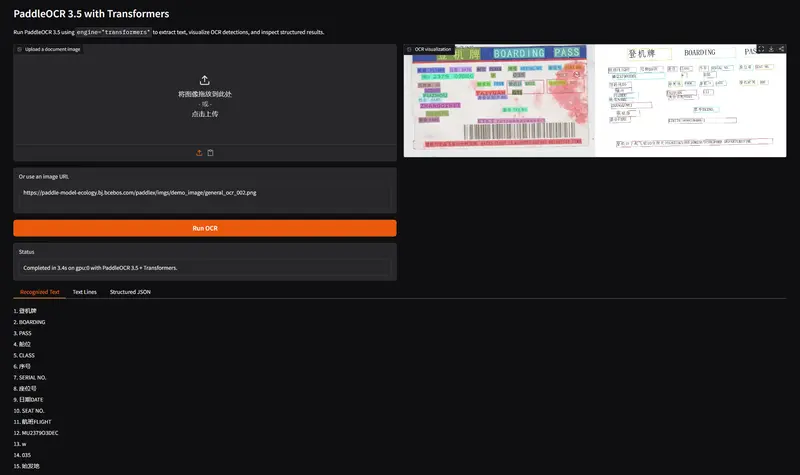
- Demo: https://huggingface.co/spaces/PaddlePaddle/paddleocr-3.5-transformers-demo
通过简单的 engine="transformers" 配置,开发者即可将业界领先的 PP-OCRv5 OCR 模型与 PaddleOCR-VL 1.5 文档解析模型无缝融入 PyTorch/HF 技术栈。这不仅降低了集成门槛,更让文档预处理成为 LLM 工作流中自然、高效的一环。
核心亮点:HF 生态集成、灵活后端、强力模型
1. 原生集成 Hugging Face Transformers
- 无缝对接:支持通过
engine="transformers"参数直接调用 HF Transformers 库进行推理,无需额外转换或中间件。 - 统一体验:对于已熟悉 HF 生态的开发者,可享受一致的模型加载、实验管理及部署流程。
- Hub 分发支持:支持的 PaddleOCR 模型可通过 Hugging Face Hub 发现、下载与版本管理,简化依赖处理。
2. 灵活的双后端架构
- 按需选择:
- Transformers 后端:适合追求开发体验统一、易于与现有 PyTorch 服务集成的场景。
- Paddle Static 后端:适合追求极致吞吐量与生产级性能的场景,仍是默认推荐的高性能选项。
- 透明配置:通过
engine_config字典透传后端特定参数(如dtype,device,attn_implementation),实现细粒度控制。 - 管道管理:无论选择何种后端,PaddleOCR 仍统一管理复杂的 OCR/文档解析管道(检测、识别、版面分析等),开发者无需手动编排组件。
3. 顶尖模型加持:PP-OCRv5 & PaddleOCR-VL
- PP-OCRv5 系列:新一代通用 OCR 模型,在精度与速度上达到新平衡,支持多语言、复杂背景及低分辨率文本。
- PaddleOCR-VL 1.5:强大的文档解析模型,能够精准提取表格、公式、图表及复杂版面结构,输出高质量结构化数据(Markdown/JSON)。
- 解决“输入瓶颈”:为 LLM 提供清晰、准确的文档上下文,显著降低幻觉率,提升 RAG 系统的回答质量。
4. 极简 API,开箱即用
- 命令行一键运行:
paddleocr ocr -i image.png --device gpu:0 --engine transformers - Python API 灵活配置:
from paddleocr import PaddleOCR

pipeline = PaddleOCR(
    device="gpu:0",
    engine="transformers",
    engine_config={"dtype": "bfloat16", "attn_implementation": "sdpa"},
)
results = pipeline.predict("document.pdf")
快速开始
1. 环境准备
确保安装 Python 3.8+,并安装以下库:
pip install paddleocr paddlex transformers torch torchvision torchaudio
# 根据硬件选择适合的 PyTorch 版本
2. Python API 使用示例
from paddleocr import PaddleOCR

# 初始化 Pipeline,指定 Transformers 后端
pipeline = PaddleOCR(
    device="gpu:0",  # 或 "cpu"
    engine="transformers",
    use_doc_orientation_classify=False,  # 可选:禁用方向分类以加速
    use_doc_unwarping=False,             # 可选:禁用文档矫正
    engine_config={
        "dtype": "float16",              # 使用半精度加速
        "attn_implementation": "sdpa",   # 使用缩放点积注意力加速
    },
)

# 执行预测
image_path = "https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/general_ocr_002.png"
results = pipeline.predict(image_path)

# 处理结果
for result in results:
    print(result['rec_texts'])  # 识别文本
    print(result['rec_scores']) # 置信度
3. 命令行使用
# 单张图片 OCR
paddleocr ocr \
  -i demo_image.png \
  --device gpu:0 \
  --engine transformers

# 文档解析(需指定 doc 任务)
paddleocr doc \
  -i demo_pdf.pdf \
  --device gpu:0 \
  --engine transformers
何时选择 Transformers 后端?
| 考量维度 | 推荐 Transformers 后端 | 推荐 Paddle Static 后端 |
|---|---|---|
| 技术栈一致性 | 项目已深度依赖 PyTorch/HF | 项目基于 PaddlePaddle 生态 |
| 开发体验 | 希望统一模型管理、调试工具 | 追求极致推理性能与稳定性 |
| 部署环境 | K8s + PyTorch Serving / TGI | PaddleServing / C++ 部署 |
| 模型实验 | 需频繁切换模型版本、微调 | 固定模型版本,大规模批量推理 |
| 社区资源 | 依赖 HF Hub 模型分发 | 依赖 Paddle Model Zoo |
© 版权声明
文章版权归作者所有,未经允许请勿转载。