英伟达正式宣布 CUDA Rust,将 Rust 提升为编写 GPU 内核的一流语言。此前,Rust 仅能作为主机端代码启动 CUDA 内核,而内核主体仍需使用 C++ 或 PTX 编写。如今,通过两个由 NVlabs 开源的新项目——cuda-oxide(SIMT 模型)和 cutile-rs(Tile 模型),开发者可以直接用 Rust 编写完整的 GPU 内核,并利用 Rust 的所有权系统在编译时杜绝数据竞争与别名错误。
- 官方介绍:https://developer.nvidia.com/blog/introducing-cuda-rust-two-tracks-for-writing-gpu-kernels/
- cuda-oxide:https://github.com/NVlabs/cuda-oxide
- cutile-rs:https://github.com/NVlabs/cutile-rs
双路径架构:SIMT vs Tile
CUDA Rust 提供了两种编程模型,对应不同的抽象层级与性能需求:
| 特性 | cuda-oxide (SIMT) | cutile-rs (Tile) |
|---|---|---|
| 抽象层级 | 线程级(描述单个线程行为) | 块级(描述数据块行为,编译器自动映射线程) |
| 编译方式 | AOT:Rust MIR → Pliron IR → LLVM → PTX | JIT:AST 嵌入主机二进制,运行时通过 Tile IR 编译 |
| Rust 工具链 | 固定 Nightly (nightly-2026-04-03) | Stable Rust 1.89+ |
| CUDA 版本 | CUDA 12.x+ | CUDA 13.3+ |
| 安全性 | 通过 DisjointSlice 等类型保证;共享内存需 unsafe | 所有权跟随张量跨启动边界;不暴露共享内存/线程索引 |
| 成熟度 | Early Alpha | Alpha(已在 Grout、mistral.rs 中使用) |
英伟达建议:优先使用 Tile 模型以获得更高层抽象和更强安全保证;仅在需要显式控制线程和内存布局时使用 SIMT。
编译时安全:Rust 所有权如何防止 GPU Bug
GPU 编程中最常见的错误之一是缓冲区别名(同一内存被同时读写)。CUDA Rust 将这一检查从运行时移至编译时:
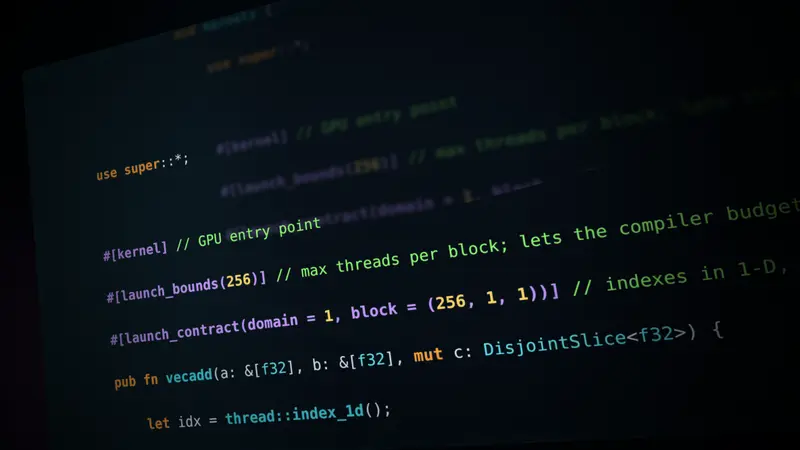
- SIMT 路径:输出缓冲区使用
DisjointSlice<f32>类型,确保每个线程对其元素拥有独占访问权。若尝试将输出缓冲区同时作为输入传递,编译器报错:error[E0502]: cannot borrow c_dev as mutable because it is also borrowed as immutable - Tile 路径:张量所有权在启动间转移。若重复使用已移动的张量,编译器报错:
error[E0382]: use of moved value: z - 启动契约:
#[launch_contract]属性声明块形状,生成的启动器会在运行前验证配置是否匹配,防止非法启动。
快速上手
cuda-oxide (SIMT)
# 检查环境
cargo oxide doctor

# 创建模板项目(主机+设备代码同文件)
cargo oxide new my_kernel
要求:Linux, SM 8.0+, CUDA 12.x+, clang with libclang
cutile-rs (Tile)
cargo new my_tile_kernel
cargo add cutile
要求:Linux, SM 8.0+, CUDA 13.3+, Stable Rust 1.89+
Tile 模型采用惰性执行:所有操作在 .sync_on(&stream) 之前仅记录为描述链,实际执行延迟到同步点。
生态现状与注意事项
- 已落地项目:
cutile-rs已被 Hugging Face 的 Grout 推理引擎和 mistral.rs 采用,证明其在实际 AI 工作负载中的可行性。 - 生产就绪? ❌ 否。两个项目均处于 Alpha 阶段,API 可能变更,不建议用于生产环境。
- 互操作性:英伟达计划支持语言间互操作,选择 Rust 不会锁定开发者远离 C++/Python 生态。
- 平台限制:目前仅支持 Linux,Windows/macOS 暂未支持。
为什么这很重要?
AI 基础设施正全面转向 Rust:NVIDIA Nova 驱动、Dynamo 运行时、NVTX 绑定均已采用 Rust。GPU 内核是最后一块拼图。CUDA Rust 的发布意味着:
- 统一语言栈:从驱动、运行时到内核,全链路可用 Rust 编写,消除 FFI 边界带来的安全风险与维护成本。
- 安全左移:将原本难以调试的 GPU 内存错误提前至编译期捕获,大幅降低开发心智负担。
- 高性能与安全兼得:无需在“C++ 的性能”和“Rust 的安全”之间做取舍。
对于追求极致性能又重视工程安全的 AI 系统开发者而言,CUDA Rust 标志着 GPU 编程进入了一个更安全、更现代的新时代。尽管尚处早期,但其设计哲学与初步实践已展现出巨大潜力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。