ComfyUI-H3VAE_TRT 是一个专为 MiniMax H3 模型设计的 ComfyUI 插件,通过 TensorRT 技术显著优化 VAE(变分自编码器)的编码与解码速度。实测显示,该方案可将 VAE 处理速度提升最高达 1.7 倍,从而大幅缩短视频生成的整体等待时间,特别是在高分辨率或长序列生成任务中效果显著。
- GitHub:https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT
- 模型:https://pan.quark.cn/s/52578ec81b0e
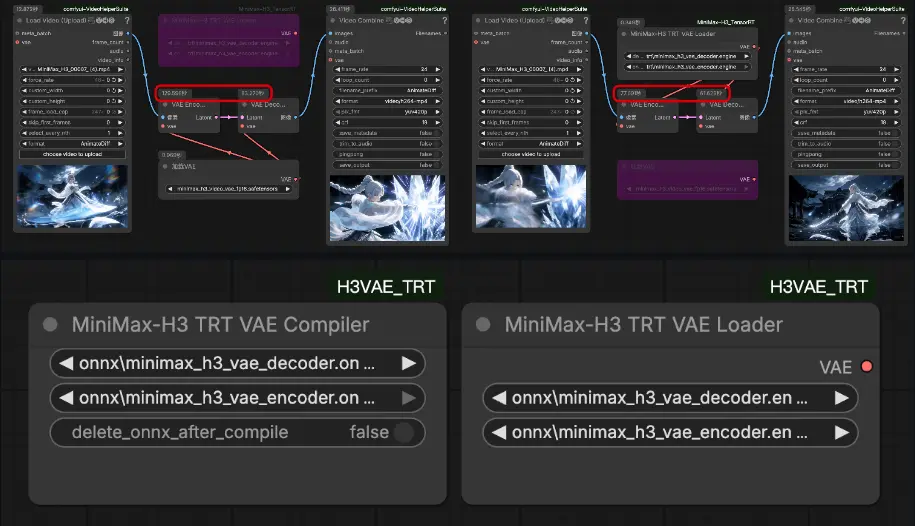
核心亮点
- 极致加速:利用 NVIDIA TensorRT 引擎对 ONNX 模型进行深度优化,实现比原生 PyTorch 更快的推理速度。
- 显存友好:提供
w4a16_awq量化版本的解码器,适合显存低于 12GB 的用户,在保持性能的同时降低硬件门槛。 - 灵活编译:支持用户根据自家显卡架构编译专属的 TensorRT 引擎,确保最佳兼容性。
安装与配置指南
1. 安装插件
cd ComfyUI/custom_nodes
git clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT.git
python -m pip install -r ComfyUI-H3VAE_TRT/requirements.txt
注意:安装完成后请重启 ComfyUI。
2. 下载模型文件
你需要手动下载 VAE 的 ONNX 格式模型文件:
- 来源:点击下载链接
- 文件内容:包括编码器 (Encoder) 和解码器 (Decoder) 的
.onnx文件,以及可能存在的.data权重文件。 - 存放路径:将下载的文件放入
ComfyUI/models/vae目录。 - 低显存选项:若显存 < 12GB,请下载并放置
w4a16_awq版本的解码器。
3. 工作流使用步骤
- 编译引擎 (首次必做):
- 在工作流中添加
MiniMax-H3 TRT VAE Compiler节点。 - 加载对应的 ONNX 模型,点击运行以编译生成针对你当前 GPU 优化的 TensorRT 引擎 (
.engine文件)。 - 编译过程可能需要几分钟,请耐心等待。
- 在工作流中添加
- 加载引擎:
- 编译完成后,使用
MiniMax-H3 TRT VAE Loader节点加载生成的引擎文件。 - 将该节点连接到你的 H3 采样器或图像/视频输出节点,即可享受加速带来的快感。
- 编译完成后,使用
常见问题与建议
- 为什么需要编译? TensorRT 引擎是针对特定 GPU 架构和精度优化的二进制文件,不同显卡(如 RTX 3090 vs RTX 4090)需要不同的引擎才能发挥最大效能。
- 显存不足怎么办? 务必尝试
w4a16_awq量化模型,它通过权重量化大幅降低了显存占用,同时保持了可接受的画质。 - 兼容性:确保你的英伟达驱动和 CUDA 版本较新,以支持最新的 TensorRT 特性。
© 版权声明
文章版权归作者所有,未经允许请勿转载。