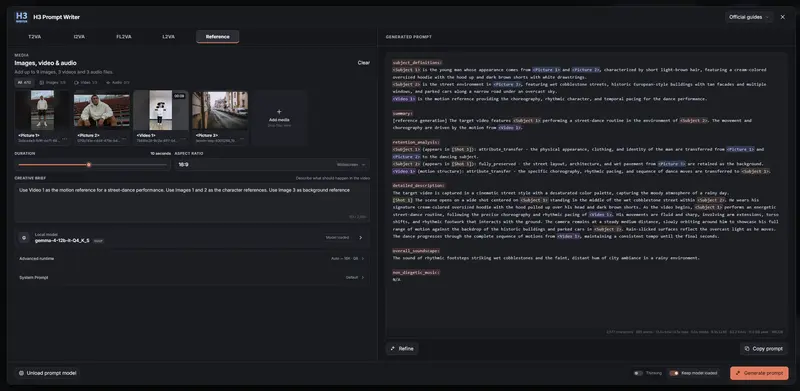
ComfyUI-MiniMaxH3-Prompt-Writer 是一款专为 MiniMax H3 设计的 ComfyUI UI 扩展(非工作流节点),通过本地 Gemma 4 GGUF 模型将创意简报与图像/视频/音频参考转化为符合官方指南的可编辑 H3 提示词。
- GitHub:https://github.com/duckyshell/ComfyUI-MiniMaxH3-Prompt-Writer
支持 T2VA/I2VA/FL2VA/L2VA/Reference 五种模式,Reference 模式最多处理 9 图 + 3 视频 + 3 音频参考;视频以有序联系表(6/8帧采样)理解,音频仅作为声明占位符(GGUF 不解析内容)。所有媒体数据保留在本地,无云端传输。提供自动/手动上下文控制(8K/16K/24K)、可编辑输出、GPU 内存管理及外部 llama.cpp 服务器连接选项。
核心功能与模型选型指南
五模式覆盖全场景
| 模式 | 输入要求 | 输出特点 |
|---|---|---|
| T2VA | 纯文本简报 | 基础文生音视频提示词 |
| I2VA | 文本 + 首帧图像 | 图像引导的视频生成提示词 |
| FL2VA | 文本 + 首尾帧图像 | 关键帧过渡提示词 |
| L2VA | 文本 + 尾帧图像 | 结尾锚定提示词 |
| Reference | 文本 + 多图/视频/音频 | 复杂参考融合提示词(≤9图+3视频+3音频) |
Gemma 4 GGUF 显存适配矩阵
| GPU 显存 | 推荐模型 | 起始上下文 | 实测表现 |
|---|---|---|---|
| 8 GB | Gemma 4 E4B Q3_K_M | 8K | 兼容最低配;视觉细节简化 |
| 12 GB | Gemma 4 12B Q4_K_S | 8K | 紧凑平衡;16K 余量紧张 |
| 16 GB | Gemma 4 12B Q5_K_M | 16K | 通用推荐层级 |
| 24 GB | Gemma 4 26B-A4B Q4_K_M | 16K | QA最佳整体平衡 |
| 32 GB | Gemma 4 31B Q4_K_XL | 16K | 视觉细节强;速度慢,提示词质量未必更优 |
⚠️ 重要提醒:
- 表格为实测起点,非硬性保证;其他 ComfyUI 节点/桌面应用会抢占显存
- 每个 GGUF 必须搭配匹配的
mmproj投影仪文件,置于独立子文件夹 - 31B 模型生成速度显著下降,且 H3 提示词质量未随参数量线性提升
部署流程与工作流集成
安装四步法
- 克隆仓库至
ComfyUI/custom_nodes/ComfyUI-MiniMaxH3-Prompt-Writer - 使用 ComfyUI 同一 Python 环境 安装依赖(Windows Portable 用户参照安装指南 CUDA 说明)
- 下载 Gemma 4 GGUF + mmproj → 放入
ComfyUI/models/LLM/(多模型分文件夹存放) - 重启 ComfyUI → 菜单 Extensions > H3 Prompt Writer 打开浮动启动器
标准工作流
[创意简报 + 本地参考媒体]
        ↓
[H3 Prompt Writer UI] ← 官方MiniMax指南 + 本地Gemma4推理
        ↓
[可编辑H3提示词] → 复制 → [你的H3生成工作流]
- ✅ 提示词生成后需手动复制到 H3 工作流的文本输入框
- ✅ 输出可实时编辑、优化纯文本、取消生成
- ❌ 不自动排队工作流,不修改节点图,不运行 H3 模型
使用注意事项
当前版本明确限制
- 🔇 音频理解缺失:GGUF 模型不解析音频内容;
<Audio N>仅作占位符,角色必须在简报中文字描述 - 🎞️ 视频理解降级:仅基于预览联系表(6/8帧采样),非完整视频流;快速运动/细微动作可能丢失
- 🌐 语言限制:UI/文档仅英文;但创意简报可用任意语言,用户提供的对话/可见文本会被保留
- 🔌 外部服务器窄兼容:仅验证 Gemma 4 多模态 GGUF + mmproj;其他模型 v0.2.0 未测试
- ⚙️ 纯文本输出:不生成节点、不连接工作流、不调用 H3 API
实操避坑指南
- 显存预检:启动前关闭非必要 ComfyUI 节点/浏览器标签,避免 OOM
- 上下文手动控制:长简报/多参考时主动切 16K/24K,自动选择可能低估需求
- 音频补偿策略:在简报中详述音频角色(如“背景爵士乐”“男性旁白”),弥补 GGUF 听觉盲区
- 视频关键帧补充:若联系表遗漏重要动作,额外上传该帧为图像参考
- 外部服务器配置:仅当本地显存不足时使用;确保 llama-server 加载正确 mmproj
© 版权声明
文章版权归作者所有,未经允许请勿转载。