在 ComfyUI 工作流中,图像自动打标(Tagging)是 LoRA 训练、数据集整理及提示词反向工程的关键环节。然而,传统的 ComfyUI-WD14-Tagger 往往因推理速度慢而成为批量处理的瓶颈。ComfyUI-WD-Timm-Tagger 是一个基于 timm 库优化的自定义节点,专为 WD v3 系列模型设计,提供极致的打标速度与灵活性。
- GitHub:https://github.com/bedovyy/ComfyUI-WD-Timm-Tagger
实测数据显示,在 RTX 5090 上处理 291 张图像,该节点仅需 9.34 秒,相比传统节点快了 24 倍以上!无论是大规模数据集清洗,还是实时生图辅助,它都能让你的工作流飞起来。
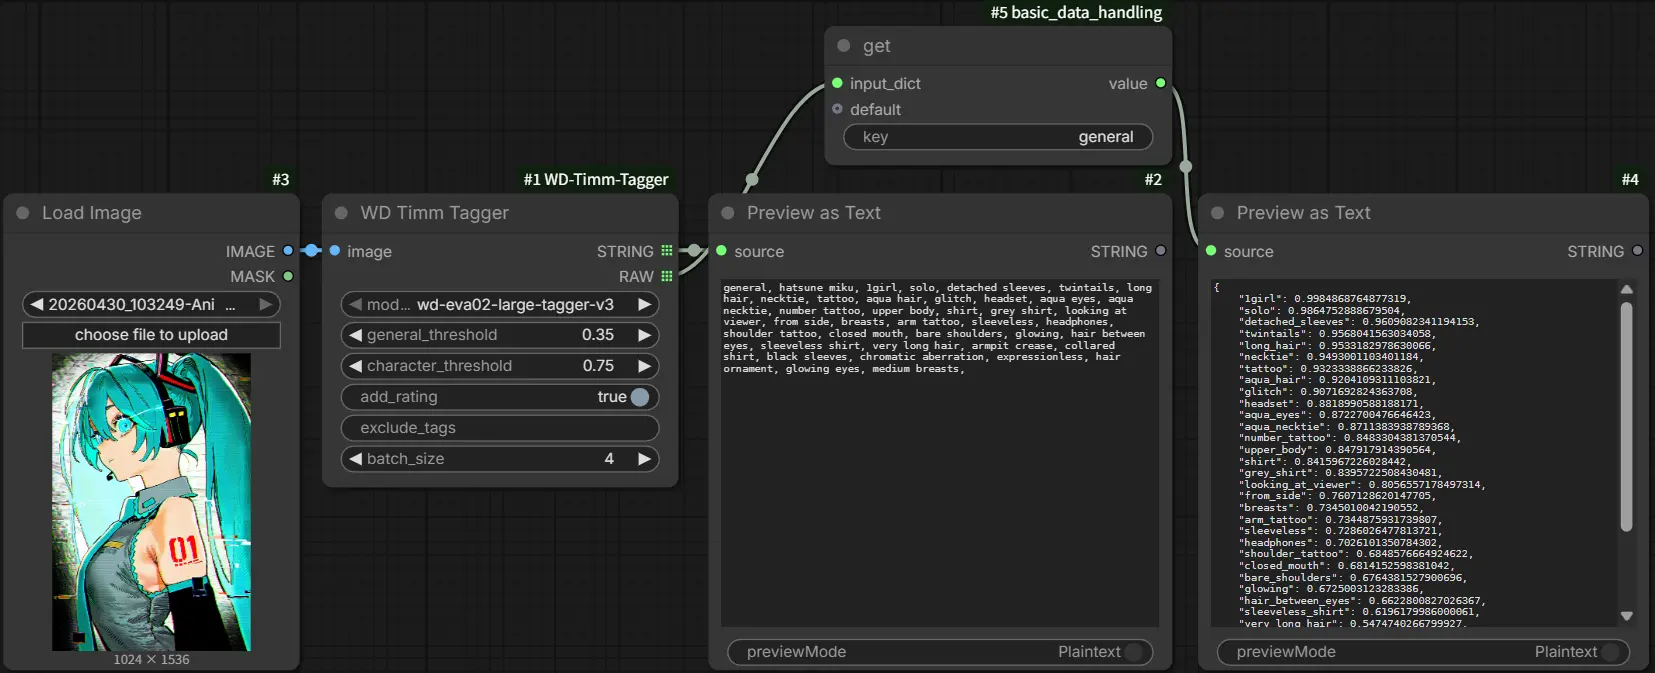
核心亮点:极速、兼容、灵活
1. 极致性能,批量处理无压力
- 24倍提速:得益于
timm库的高效实现与硬件加速优化,推理速度呈指数级提升。 - 批量支持:原生支持图像批次输入,通过调整
batch_size进一步挖掘 GPU 潜力,大幅缩短大规模任务耗时。 - 低延迟体验:即使是单张图像打标,也能实现毫秒级响应,无缝融入实时生成工作流。
2. 全面支持 WD v3 主流模型
内置并自动管理多种高性能 tagging 模型,涵盖不同架构与场景:
- Eva02 Large (
wd-eva02-large-tagger-v3):综合性能最强,推荐首选。 - ViT Large / ViT (
wd-vit-large-tagger-v3,wd-vit-tagger-v3):视觉 Transformer 架构,平衡速度与精度。 - SwinV2 (
wd-swinv2-tagger-v3):滑动窗口 Transformer,擅长捕捉局部细节。 - ConvNext (
wd-convnext-tagger-v3):卷积神经网络架构,稳健可靠。 - Pixai / OppaiOracle:特定社区优化模型,满足特殊需求。
- 自定义模型:只需将模型文件夹放入
models/wd_taggers/,即可自动识别并使用。
3. 精细化控制,满足专业需求
- 双阈值调节:
general_threshold:控制通用标签(如 “1girl”, “outdoors”)的置信度门槛。character_threshold:控制角色标签(如特定动漫人物名)的置信度门槛,避免误标。
- 标签过滤:支持
exclude_tags参数,一键排除不需要的标签(如 “watermark”, “text”)。 - 评级前置:可选
add_rating,在输出字符串前添加安全评级(如 “safe”, “questionable”)。 - 精度选择:支持
auto,bf16,fp16,根据显卡特性优化显存占用与计算速度。
4. 开箱即用,自动管理
- 自动下载:首次使用时,节点会自动从 Hugging Face 下载所需模型至
models/wd_taggers/,无需手动配置。 - 标准输出:
- STRING:格式化的逗号分隔标签字符串,可直接连接 CLIP Text Encode。
- RAW:包含
ratings,character,general详细分数的字典,便于后续逻辑判断或调试。
快速开始
1. 安装节点
cd ComfyUI/custom_nodes/
git clone https://github.com/your-repo/ComfyUI-WD-Timm-Tagger.git
cd ComfyUI-WD-Timm-Tagger
pip install -r requirements.txt
重启 ComfyUI。
2. 使用示例
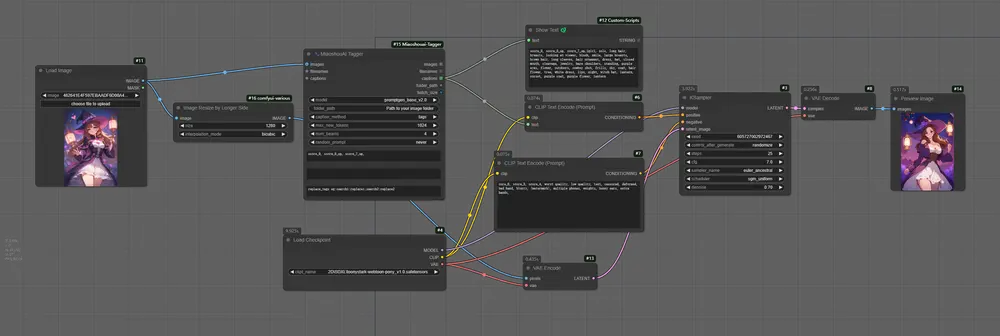
- 加载图像:使用
Load Image或Image Batch节点输入图片。 - 添加 Tagger 节点:搜索并添加
ComfyUI-WD-Timm-Tagger。 - 连接输入:将图像连接到
image端口。 - 配置参数:
model_name: 选择eva02(推荐)。dtype: 选择bf16(若显卡支持) 或fp16。general_threshold: 默认 0.35,可根据需要调整。character_threshold: 默认 0.75,角色识别敏感时可降低。
- 获取输出:将
STRING输出连接到CLIP Text Encode (Prompt)的text端口,即可用于生图或训练。
3. 性能对比实测 (RTX 5090, 291 张图像)
| 节点 | 耗时 | 备注 |
|---|---|---|
| ComfyUI-WD-Timm-Tagger | 9.34s | 🏆 极速推荐 |
| ComfyUI-WD14-Tagger | 226.99s | 传统方案,较慢 |
💡 提示:对于大批量图像处理,建议适当增加
batch_size(如 8, 16, 32),以充分利用 GPU 并行计算能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。