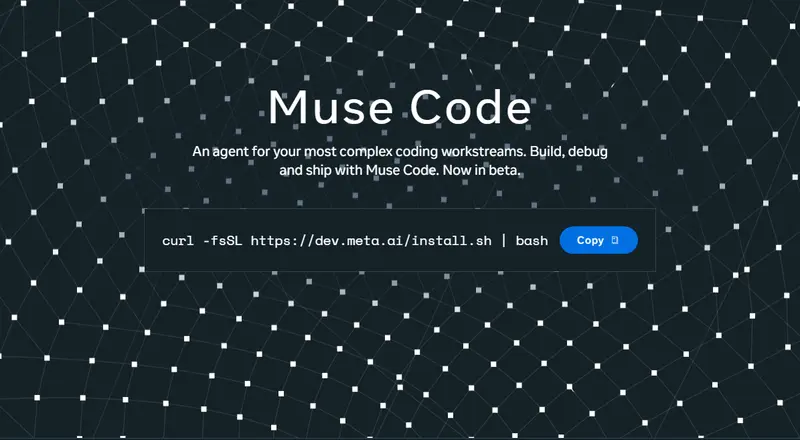
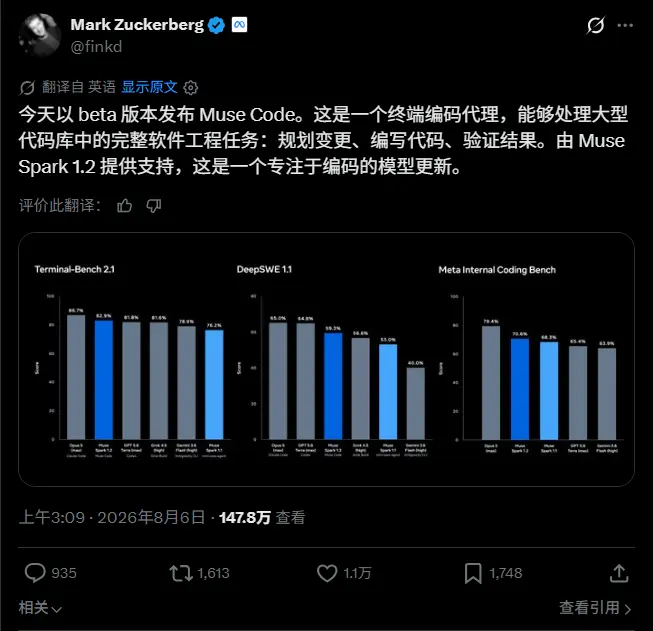
Meta 正式发布测试版编码代理 Muse Code,由协同训练的 Muse Spark 1.2 模型驱动,定位于处理仓库级复杂工程任务。该工具支持多文件修改、命令执行、测试验证及并行子代理协作,并通过本地事件日志保障长时程任务的崩溃恢复能力。其定价策略包含标准层与大幅折扣的贡献者层级,后者价格仅为标准层的约 5%–8%,但要求用户授权 Meta 使用提示词与补全内容训练未来模型。当前仅支持 macOS 与 Linux 原生安装,Windows 用户需依赖 WSL。
- 官方说明:https://research.meta.ai/blog/introducing-muse-code-and-muse-spark-1-2
核心架构与运行时特性
Muse Code 的设计围绕长周期、高复杂度软件工程场景展开,关键机制包括:
- 持久化异步子代理:后台子代理在整个会话期间保持活跃,避免按任务临时创建进程带来的上下文重建开销,可复用已收集信息
- 本地只追加事件日志:记录所有模型调用、编辑操作、用户审批及工具执行,作为单一可信状态源,支持精确重放与断点续跑
- Harness 协同训练:Muse Spark 1.2 与 Muse Code 工具集联合优化,训练数据包含拒绝采样的真实 harness 轨迹,提升端到端任务完成率
这些设计使 Muse Code 区别于仅做代码补全的工具,更适合重构、迁移、长期调试等需要跨文件协调与状态维持的场景。
定价结构与隐私权衡明细
Muse Spark 1.2 提供两级定价,差异显著且绑定明确的数据使用条款:
| 计费项 | 标准层级(美元/百万 token) | 贡献者层级(美元/百万 token) | 折扣幅度 |
|---|---|---|---|
| 输入 token | 1.25 | 0.10 | 92% |
| 缓存输入 token | 0.15 | 0.002 | 98.7% |
| 输出 token | 4.25 | 0.20 | 95.3% |
选择贡献者层级的唯一条件是:用户必须明确授权 Meta 将其提示词与模型补全内容用于未来模型训练。这意味着代码片段、业务逻辑、内部 API 结构等敏感信息可能被纳入训练数据集。对于处理专有代码或受合规约束的团队,此条款构成实质性隐私取舍。标准层级无此要求,但成本高出近一个数量级。
部署现状与平台兼容性
- 安装方式:通过终端脚本安装原生二进制文件,支持 macOS 与 Linux
- Windows 支持:官方未发布 Windows 版本,但可通过 Windows Subsystem for Linux (WSL) 运行 Linux 构建
- 模型访问:Muse Spark 1.2 仅以托管 API 形式提供,无开放权重;全球访问权限已开放
- 版本状态:当前为测试版,生产环境使用前需评估稳定性与安全审计流程
值得注意的是,Muse Code 与 Claude Code、Codex 等竞品形成直接竞争,但其低价策略的独特代价是数据使用权让渡。开发者在选型时应将隐私成本纳入总拥有成本计算,而非仅比较 token 单价。对于开源项目或个人学习场景,贡献者层级可能具备吸引力;但对于企业代码库,标准层级或替代方案或许是更稳妥的选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。