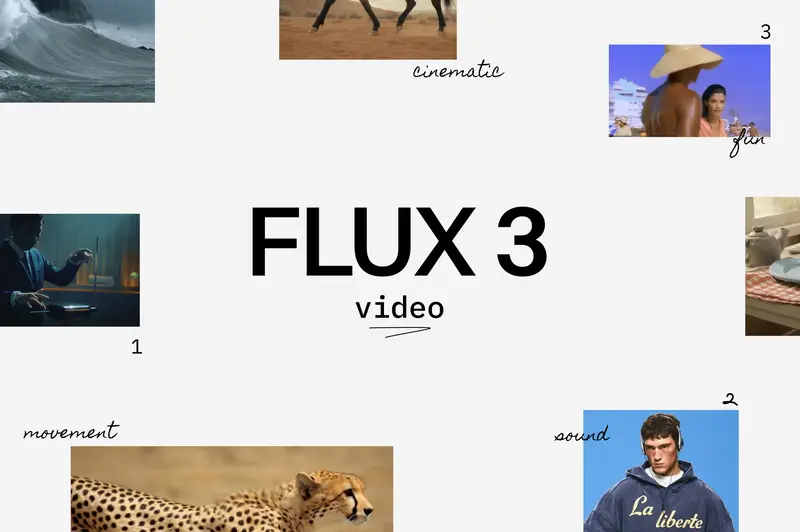
Black Forest Labs 正式推出 FLUX 3 Video,这是其前沿多模态模型 FLUX 3 的视频生成能力首次对外开放。该模型支持文本生成视频、图像生成视频、视频续写及多语言对话生成,原生输出最长 20 秒、1080p 分辨率片段,并同步生成匹配画面的音频。产品已通过 BFL API 及精选合作伙伴上线,提供草稿模式用于低成本创意探索,2K、4K 分辨率及开放权重版本将在后续发布。
- 官方介绍:https://bfl.ai/blog/flux-3-video
- 模型:https://bfl.ai/models/flux-3
- API:https://dashboard.bfl.ai/playground
核心生成能力与多模态特性
FLUX 3 Video 的设计目标是精确建模现实世界的多模态本质,而非局限于特定视觉风格。其输出可覆盖原始纪实、电影美学、趣味娱乐等多种调性,且在同一模型内保持一致的可控性。当前版本支持以下功能:
- 文本生成视频:接受简单描述或复杂指令,同步生成符合场景逻辑的运动、画面与音频
- 图像生成视频与关键帧控制:从单张图像出发,指定结束帧或设置多个关键帧,模型按序连接并保持视觉语言连贯
- 视频续写:输入最多 4 秒现有视频与音频,模型跨接缝延续运动、镜头行为、对话及环境音
- 多镜头序列:在单次生成中切换场景与机位,维持叙事连贯性
- 原生音频与对话:同步生成环境音、音效及多语言对话,口型与语音精确对齐
- 多语言支持:涵盖英语(多方言)、中文、西班牙语、法语、德语、日语、葡萄牙语、俄语、意大利语、印尼语、土耳其语、印地语、旁遮普语等
- 世界知识接地:结合预训练知识与实时上下文,适用于纪录片及短格式教育内容
草稿模式允许用户以较低成本快速预览提示词效果,确认方向后再以全质量渲染最终视频。最终输出与草稿版本在主体、构图、运动上保持一致,避免重复调试。
基准表现与安全部署措施
在内部评估中,FLUX 3 Video 在文本生成视频任务上明显优于现有 SOTA 模型;在图像生成视频任务上与 Seedance 2.0 持平,并超越其他同类模型。人工评分者在两类任务中均将其列为首选。
安全方面,Black Forest Labs 与第三方机构 Cinder 合作,在发布前完成多模态风险评估,验证了针对非自愿亲密图像(NCII)及儿童性虐待材料(CSAM)等滥用场景的缓解措施有效性。相关保障机制贯穿发布前、发布中及发布后全流程。
后续路线图与接入方式
FLUX 3 Video 现已通过 BFL API 及精选合作伙伴提供服务。后续更新计划包括:
- 支持图像、视频、音频参考组合的混合生成
- 推出 FLUX 3 Image 用于图像生成与编辑
- 发布开放权重变体 FLUX 3 Dev
- 扩展 2K 与 4K 分辨率支持
对于内容创作者与开发团队,建议优先通过草稿模式验证提示词策略,再投入全质量生成资源。多语言与音频同步能力为本地化内容与无障碍创作提供了新选项,但需注意各语言口型同步精度可能存在差异,建议在目标语种上进行专项测试。
© 版权声明
文章版权归作者所有,未经允许请勿转载。