Zyphra 发布 ZONOS2:首个开源 MoE 架构实时 TTS 模型,支持 600 万小时多语言数据训练与高保真语音克隆,Apache 2.0 协议免费商用
Zyphra 正式发布了其最新的文本转语音(TTS)模型 ZONOS2。作为首个采用 混合专家(MoE) 架构的开源实时 TTS 模型,ZONOS2 在超过 600 万小时 的多语言语音数据上训练,不仅实现了与顶级专有提供商相媲美的表现力与质量,更在高保真语音克隆、低延迟推理及多语言支持上取得了突破性进展。遵循 Apache 2.0 许可协议,ZONOS2 为全球开发者提供了一个强大、自由且可商用的语音合成基础设施。
- 官方介绍:https://www.zyphra.com/our-work/zonos2
- GitHub:https://github.com/Zyphra/Zonos2/
- 模型:https://huggingface.co/Zyphra/ZONOS2
核心亮点:MoE 架构、实时高保真、广泛多语言
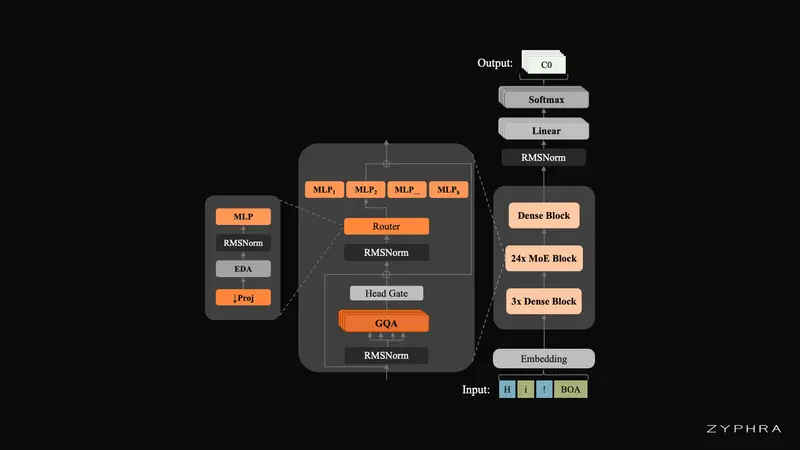
1. 首创开源 MoE TTS 架构
- 高效扩展:拥有 80 亿总参数,激活参数仅 9 亿。通过引入 MoE 并消除对分类器自由引导(CFG)的依赖,模型规模大幅扩大,同时实时吞吐量比前代提升 4 倍。
- 实时推理:基于 Mini-SGLang 构建的高性能推理服务器,确保在消费级硬件上也能实现低延迟流式输出。
2. 卓越的零样本语音克隆
- ECAPA-TDNN 嵌入:采用带宽提高 20 倍 的新说话人嵌入模型,结合新的克隆训练方案,能捕获更多声音细微差别。
- 双模式选择:
- 稳定模式:修饰背景噪音与失真,输出“录音室级”干净语音。
- 表现力模式:忠实还原源音频的情感、韵律甚至瑕疵,追求极致的自然度与保真度。
3. 真正的多语言与语码转换
- UTF-8 字节分词:摒弃传统的音素化步骤,直接处理原始 UTF-8 字节,大幅提升了中文、日韩语等非欧洲语言的性能,并天然支持语码转换(Code-switching)。
- 三级语言支持:
- 一级:英语、普通话、日语。
- 二级:韩语、俄语、法西德意葡越荷希等 10 种。
- 三级:印地语、阿拉伯语、泰语等 20+ 种小语种。
技术架构与创新
1. 数据过滤与三阶段训练
- 海量数据:训练集从 20 万小时扩展至 600 万小时,覆盖多样录音条件。
- 动态过滤:引入网络规模音频过滤方法,在预训练、中期训练及退火阶段逐步提高转录本一致性要求,有效减少幻觉与发音错误。
- 训练流程:
- 预训练:无说话人克隆信息,最大化数据多样性。
- 中期训练:聚焦高质量干净数据,减少幻觉。
- 退火训练:引入说话人嵌入、语速及质量调节,提升泛化能力。
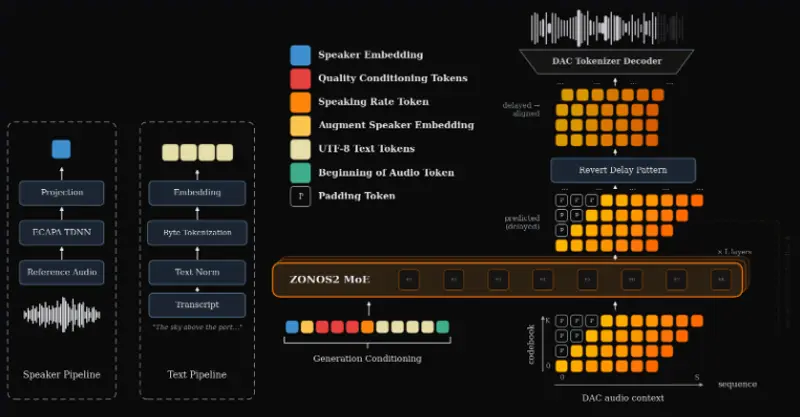
2. Descript Audio Codec (DAC) 集成
- 高保真输出:预测 DAC token,生成 44.1 kHz 录音室质量音频。
- 复杂建模:通过增加模型与数据规模,克服了 DAC token 建模的高难度,在保持强劲生成性能的同时保留极高音频质量。
3. 全新评估基准:ZTTS1-Eval
针对现有评估(Seed-TTS-Eval, CV3-Eval)的语言单一、模型过时及数据偏差问题,Zyphra 推出了 ZTTS1-Eval:
- 多样化数据集:包含 9 种语言的“干净”音频(FLEURS-R)及 17 种语言的“野外”音频(VoxBlink2)。
- 先进评估模型:使用 Qwen3-ASR 进行识别,ReDimNet 评估说话人相似度,MSR-UTMOS 评估声学质量。
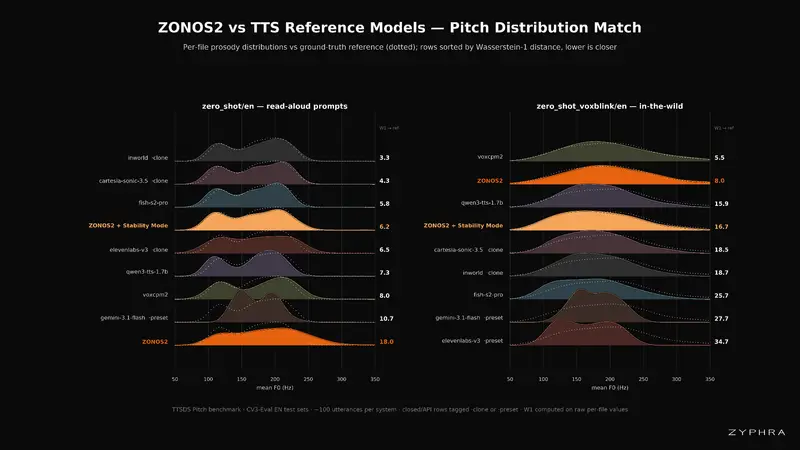
- 韵律与多样性:引入 TTSDS 韵律指标及 DS-WED 语义单位距离,更全面地衡量生成语音的自然度与分布真实性。
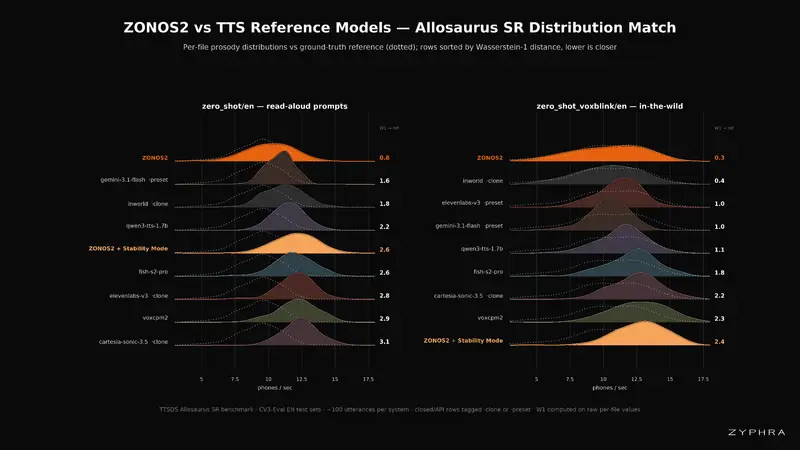
性能对比与定量分析
| 特性 | ZONOS2 | 传统 TTS 模型 |
|---|---|---|
| 架构 | MoE (8B 总参 / 0.9B 激活) | 稠密 Transformer |
| 输入处理 | UTF-8 字节 (无需音素化) | 音素/音标 (依赖语言标签) |
| 语音克隆 | 高保真,保留源音频特征 | 往往过度清洗,丢失个性 |
| WER 表现 | 接近真实人类语音错误率 | 往往过低,反映“过度干净” |
| 许可证 | Apache 2.0 (开源免费) | 多为闭源或受限许可 |
注:ZONOS2 在说话人相似度和韵律指标上表现尤为出色,其输出分布紧密贴合真实数据,避免了传统模型改变声音分布“形状”的问题。
对于希望构建多语言应用、数字人助手或个性化语音内容的开发者而言,ZONOS2 提供了一个既强大又自由的基石。
© 版权声明
文章版权归作者所有,未经允许请勿转载。