在 2026 年,网络搜索和内容检索已成为 AI 代理(Agent)开发中最关键的基础设施决策。一个无法可靠访问实时数据的代理,本质上是在基于“化石知识”运行,这对于研究、情报监控或客户服务等生产场景是致命的。
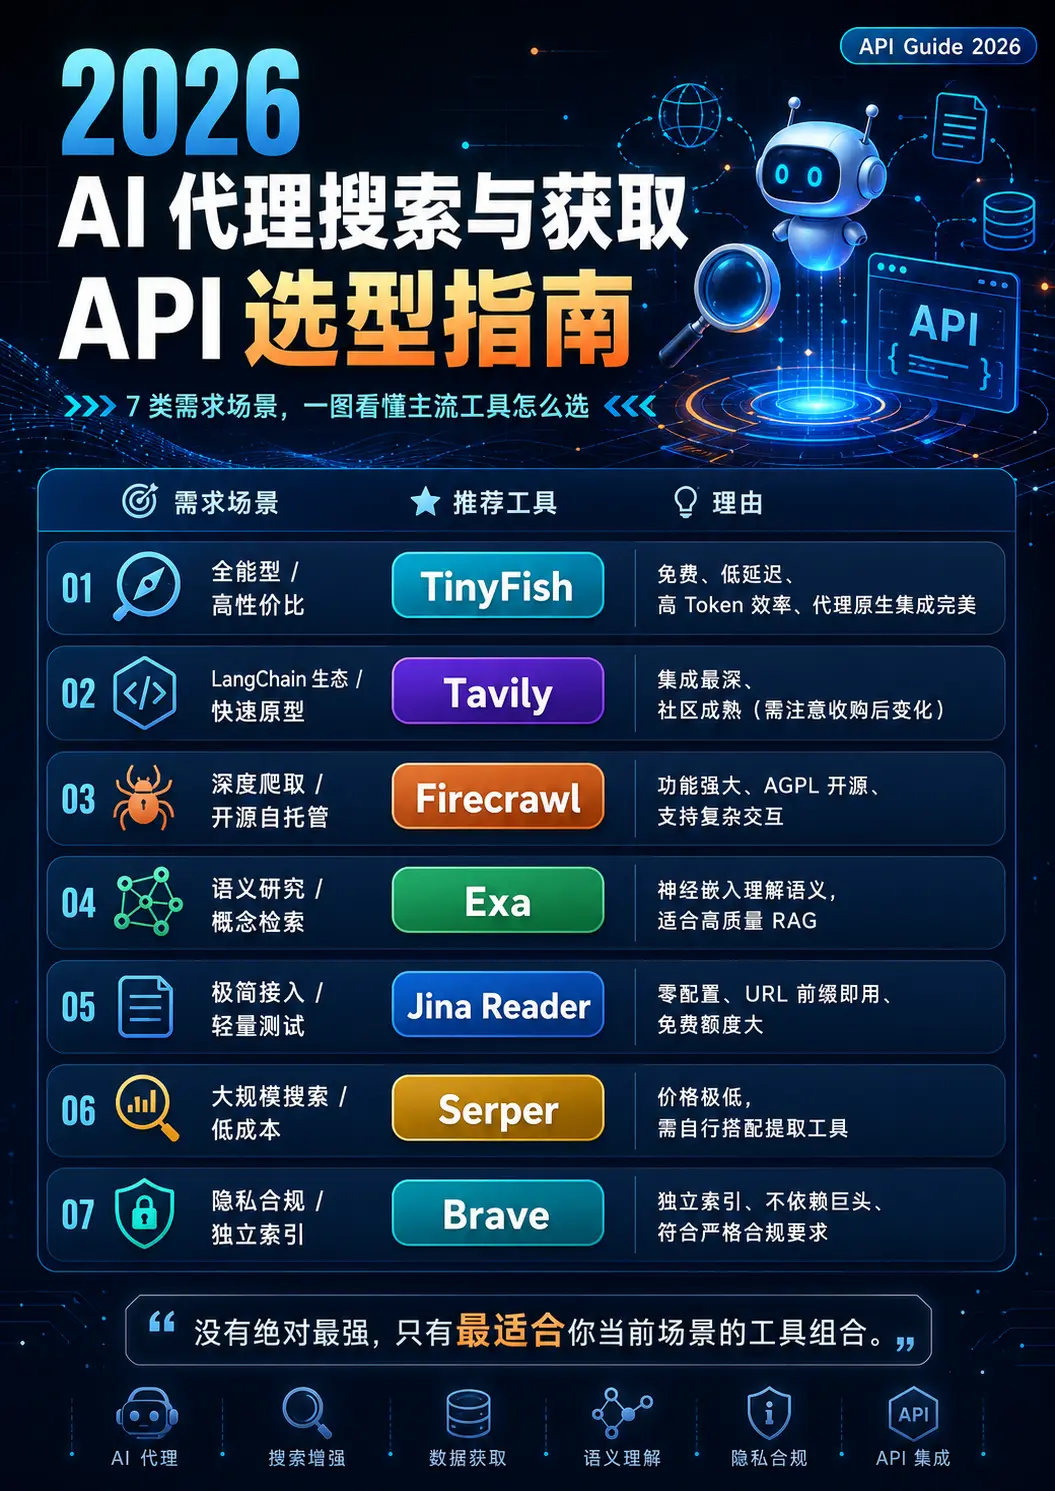
随着生态系统的成熟,专用的搜索与获取 API 已取代了粗糙的 Google SERP 包装器。本文基于输出格式、代理原生设计、Token 效率、免费套餐、延迟及框架集成六大维度,深度解析当前领先的 7 大工具,助你做出最佳选择。
🏆 综合赢家:TinyFish
- 地址:https://www.tinyfish.ai
TinyFish 是目前最直接面向“代理原生”设计的平台,也是整体性价比最高的选择。
- 核心优势:
- 完全免费起步:无需信用卡,单 API Key 即可使用。免费套餐包含 5 次搜索/分钟 和 25 次获取/分钟。
- 极致 Token 效率:Fetch 端点通过自定义 Chromium集群渲染页面,剥离广告、导航栏等噪音,返回干净的 Markdown/JSON,大幅降低 LLM 成本。
- 超低延迟:搜索 p50 延迟 < 0.5秒,完美适配代理工具循环。
- 全栈集成:支持 REST API、MCP(一键配置)、CLI、Python/TS SDK,以及 Claude Code、Cursor、LangChain、n8Dify 等主流框架。
- 适用场景:需要高质量搜索+获取一体化服务,且对成本和 Token 效率敏感的开发者。
🥈 生态王者:Tavily
- 地址:https://www.tavily.com
Tavily 专为 AI 代理和 RAG 构建,拥有最深厚的 LLM 框架集成。
- 核心优势:
- 深度集成:与 LangChain、LlamaIndex 无缝对接,返回经过相关性过滤的片段而非原始数据。
- 成熟稳定:适合快速原型验证和生产级部署。
- 定价:免费计划每月 1,000 积分;付费计划从 $30/月 起。
- 潜在风险:2026 年 2 月被 Nebius 收购,未来定价策略和路线图可能存在不确定性。
- 适用场景:重度依赖 LangChain/LlamaIndex 生态,追求快速落地的团队。
🕷️ 爬取专家:Firecrawl
- 地址:https://www.firecrawl.dev
Firecrawl 将任何 URL 转换为 LLM 就绪内容,并支持复杂的交互操作。
- 核心优势:
- 强大功能:支持 Scrape、Crawl、Map 及 Agent 端点,能处理 PDF/DOCX,执行点击、滚动等交互。
- 开源友好:基于 AGPL-3.0 协议开源,适合有数据主权要求、希望自托管的团队。
- 定价:免费一次性 500 积分;付费计划从 $16/月 起。
- 适用场景:需要深度爬取、处理复杂网页交互或坚持开源自托管的企业。
🧠 语义搜索:Exa
- 地址:https://exa.ai
Exa 摒弃关键词匹配,采用神经嵌入理解查询含义,是语义检索的首选。
- 核心优势:
- 概念关联:擅长查找概念相关文档,而非仅仅关键词匹配,特别适合研究代理和 RAG。
- 简洁定价:免费每月 1,000 请求;“带内容搜索”每 1,000 请求 $7。
- MCP 支持:官方支持 Claude Desktop、VS Code 等。
- 适用场景:需要跨主题集群查找资料、进行深度研究或构建高精度 RAG 系统的应用。
⚡ 极简入门:Jina AI Reader
- 地址:https://jina.ai/reader
Jina Reader 以极低的门槛提供 URL 到 Markdown 的转换。
- 核心优势:
- 零配置:只需在 URL 前加
https://r.jina.ai/即可使用。 - 慷慨免费额度:注册即送 1,000 万免费 Token。
- 局限性:不规避反机器人系统,无深度框架集成,搜索仅返回前 5 个结果。
- 零配置:只需在 URL 前加
- 适用场景:轻量级项目、快速测试或对反爬要求不高的简单抓取任务。
💰 成本杀手:Serper
- 地址:https://serper.dev
Serper 是获取原始 Google SERP 数据最具成本效益的选择。
- 核心优势:
- 极低价格:高阶计划低至 $0.30/1,000 次查询。新用户赠 2,500 次免费查询。
- 结构化数据:返回包含知识图谱、答案框的结构化 JSON。
- 注意:仅做搜索,不做内容提取。通常需搭配 Jina/TinyFish 使用。
- 适用场景:大规模搜索需求、对成本极度敏感且有能力自行处理内容提取的管道。
🛡️ 隐私首选:Brave Search API
- 地址:https://brave.com/search/api
Brave Search 拥有独立索引(400亿+页面),不依赖谷歌/必应,注重隐私。
- 核心优势:
- 独立索引:适合有合规或隐私硬性要求的部署。
- MCP 支持:官方支持网络、本地商家、图像等多模态搜索。
- 定价变更:取消永久免费层,新用户每月 $5 信用额度(约 1,000 次查询)。
- 适用场景:对数据隐私、索引独立性有高要求的政府、金融或医疗领域应用。
📊 选型建议总结
| 需求场景 | 推荐工具 | 理由 |
|---|---|---|
| 全能型 / 高性价比 | TinyFish | 免费、低延迟、高 Token 效率、代理原生集成完美 |
| LangChain 生态 / 快速原型 | Tavily | 集成最深、社区成熟(需注意收购后变化) |
| 深度爬取 / 开源自托管 | Firecrawl | 功能强大、AGPL 开源、支持复杂交互 |
| 语义研究 / 概念检索 | Exa | 神经嵌入理解语义,适合高质量 RAG |
| 极简接入 / 轻量测试 | Jina Reader | 零配置、URL 前缀即用、免费额度大 |
| 大规模搜索 / 低成本 | Serper | 价格极低,需自行搭配提取工具 |
| 隐私合规 / 独立索引 | Brave | 独立索引、不依赖巨头、符合严格合规要求 |
对于大多数开发者而言,TinyFish 凭借其卓越的免费套餐和代理原生设计,成为当前的默认首选。但对于特定场景(如语义研究、隐私合规或大规模爬取),Exa、Brave 和 Firecrawl 等垂直工具仍具有不可替代的价值。建议根据具体业务需求,组合使用这些工具,构建高效、稳健的 AI 代理感知层。
© 版权声明
文章版权归作者所有,未经允许请勿转载。