大模型应用的故障模式,和传统软件完全不一样。
同样的提示词,输出结果却飘忽不定;检索环节返回错误文档,但接口全部返回200正常状态码;AI代理陷入无休止的工具调用循环,消耗大量Token,最后给出一份看起来有理有据实则完全错误的答案。
传统APM应用性能监控,只能拿到延迟、报错、吞吐量这类指标,完全识别不出这类语义层面的问题:提示词输出质量、检索相关性、代理推理链路。
而LLM可观测与评估平台,解决的正是这一类问题。它完整记录大模型流水线的全链路信息:提示词、模型返回内容、检索结果、工具调用、Token消耗、延迟、成本,再通过自动化评估组件对输出质量打分。到2026年,这类工具已经不再是锦上添花的附加组件,而是生产环境运行AI业务团队的必备基础设施。
从行业数据也能看到赛道的快速扩张。The Business Research Company数据显示,2026年LLM可观测平台市场规模达到26.9亿美元,对比2025年19.7亿美元大幅增长,预计2030年将来到92.6亿美元,复合年增长率36.2%。Gartner也给出预判:到2028年,LLM可观测相关投入将占到生成式AI项目部署成本的50%,2026年初这一比例仅为15%。
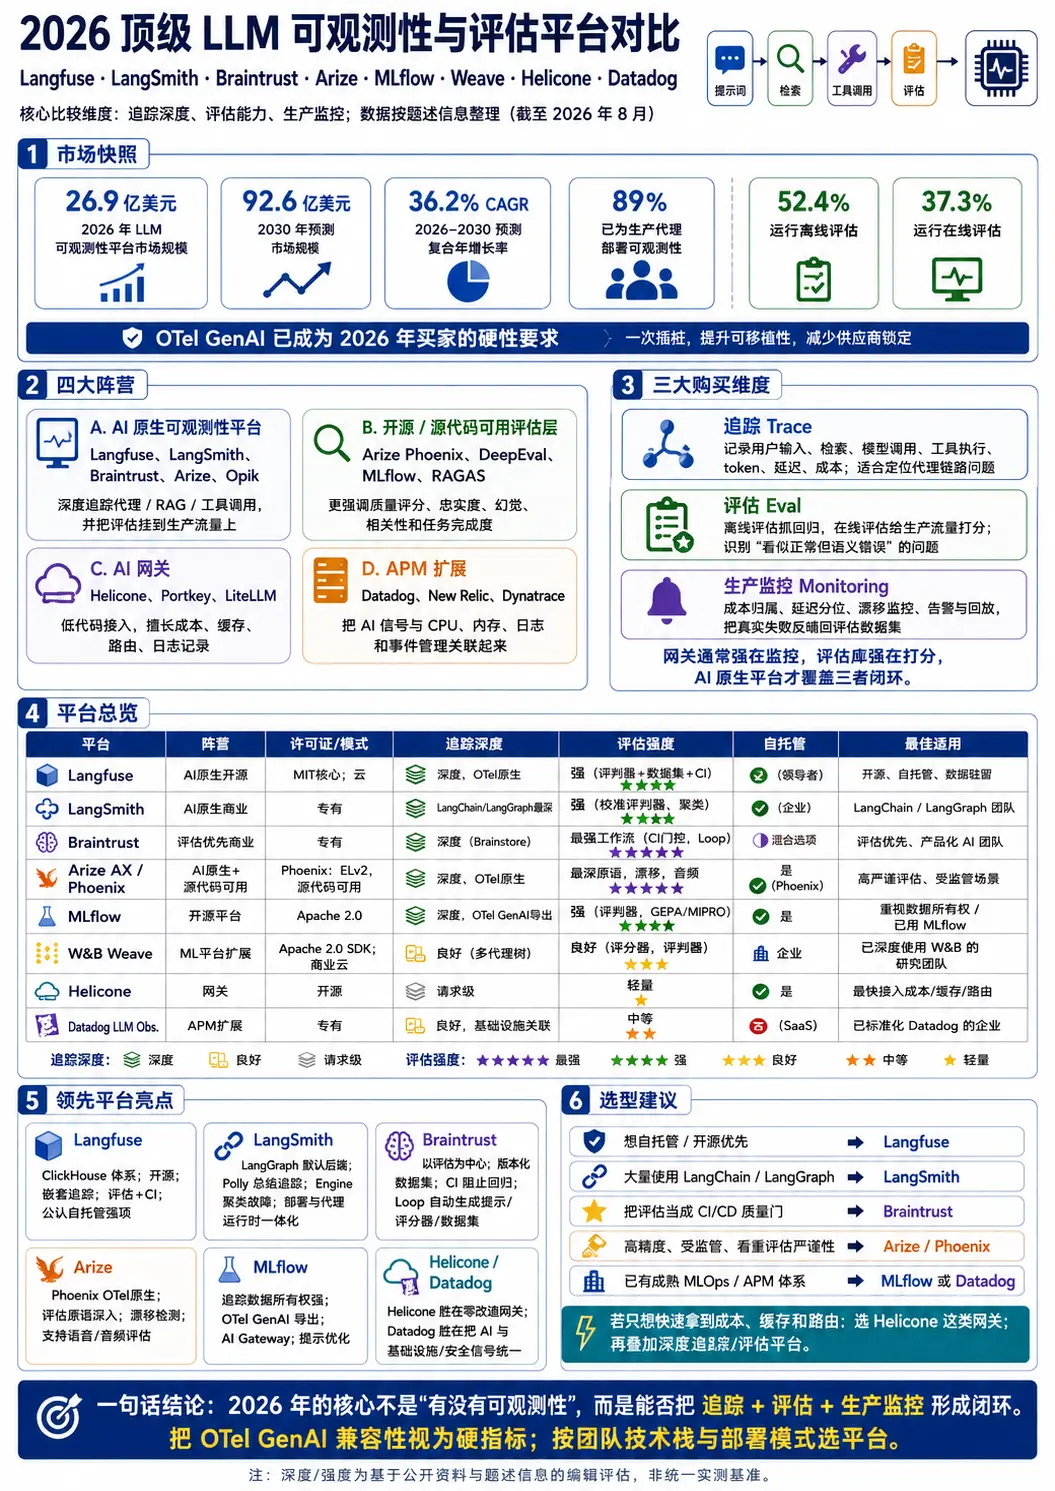
LangChain针对1300余名从业者开展的《代理工程现状》调研也很有参考价值:57%受访者已经在生产环境部署AI代理,接近89%都接入了可观测能力。但评估环节依旧普遍滞后:52.4%仅做离线评估,37.3%上线在线评估,还有29.5%完全没有评估流程。32%的团队认为,输出质量问题是阻碍生产落地的最大障碍。
本文将从追踪深度、评估能力、生产监控三个核心维度,对比当下主流平台Langfuse、LangSmith、Braintrust、Arize等。信息截止2026年8月,内容参考各厂商公开文档与官方公告,文中的“最佳适用”属于编辑综合判断,并非严格实测跑分。(来源)
当前市场分为四大阵营
理解赛道格局,比单纯罗列功能更重要,目前行业大致划分成四类产品。
AI原生可观测平台:Langfuse、LangSmith、Braintrust、Arize、Opik。核心目标就是LLM链路追踪,可以捕获代理、检索器、工具之间嵌套调用链路,并且把评估分数绑定到真实生产流量之上。
开源评估库与平台:Arize Phoenix、DeepEval(Confident AI)、MLflow、RAGAS。重心偏向输出打分,依靠LLM‑as‑a‑judge完成幻觉、忠实度、答案相关性等质量评估。
AI网关:Helicone、Portkey、LiteLLM。部署在业务与模型服务商中间做代理,少量代码改动即可实现日志记录、缓存、成本统计、模型路由。
传统APM扩展方案:Datadog LLM Observability、New Relic、Dynatrace。在原有基础设施监控能力之上叠加LLM追踪,可以把AI业务指标和CPU、内存、网络指标做关联分析。
现在整个行业正在收敛到同一套标准:OpenTelemetry GenAI语义约定。这套由CNCF维护的中立规范定义gen_ai.*系列属性,统一描述模型调用、Token消耗、代理步骤、工具执行。谷歌云、AWS、Azure、Datadog都已经采纳这套规范。
不止监控平台,编码代理工具也在向该标准靠拢:GitHub Copilot代理遥测输出gen_ai.*链路,Claude Code支持可选OTel追踪,Codex原生支持OTel导出。业务侧完成一次插桩即可获得后端可移植性,减少各个平台专属埋点代码。2026年做技术选型,OTel兼容性应当视作硬性要求,而不是附加功能。
三个核心概念:追踪、评估、生产监控
市面上厂商对名词定义五花八门,先把三者边界梳理清楚。
追踪:完整记录LLM应用发生的全部行为。一条Trace包含多层Span:用户输入、每一次检索、每一次模型调用以及完整提示词参数、工具执行过程、最终输出。代理场景下调用链路深度嵌套,单次对话会产生大量数据。大模型输出具备不确定性,相同提示词得到不同结果十分常见,如果没有调用时刻完整的输入、参数记录,故障根本无法复现。
评估:用来回答追踪回答不了的问题——输出质量到底好不好。离线评估在上线前,针对测试数据集打分,提示词、模型、检索库改动之后用来捕捉质量退化;在线评估作用于真实生产流量,一般借助LLM‑as‑a‑judge,抽样对真实业务数据做忠实度、相关性、任务完成度打分。最棘手的故障,不是接口报错,而是返回结果语法正常,但业务领域层面完全错误,这类问题传统监控指标完全无法感知。
生产监控:形成业务闭环。包含仪表盘、按模型/用户做成本拆分、延迟分位数、提示词漂移检测,质量下跌时触发告警。优秀的平台还可以把线上真实故障回流到评估数据集,让真实业务问题成为后续回归测试用例。
不同产品侧重点差异很大:网关擅长监控,但缺少深度链路追踪;评估库专注打分,缺少完整生产监控能力。下面的平台排序,依据三者综合覆盖能力进行。
Langfuse(ClickHouse)
Langfuse被称为采用度最高的LLM工程平台,开源社区数据也支撑这一判断。
- 追踪:兼容OpenTelemetry、LangChain、OpenAI SDK、LiteLLM,捕获完整嵌套链路。标志性的树状视图,可以展开查看RAG与代理每一步的延迟、Token消耗。2026年3月新数据模型带来十倍以上仪表盘性能提升,为v4版本铺路,官方宣称部分场景最高提速165倍。
- 评估:支持LLM裁判、人工标注队列、自定义评分,还可以接入GitHub Actions在CI流程运行数据集回归测试,内置幻觉、毒性、相关性评估模板。
- 生产监控:按模型、用户、会话统计成本,支持会话回放。
- 部署:核心代码MIT协议开源,Docker Compose快速自托管,也可以使用托管云版本,提供免费层。
✅最佳适用:追求完整能力、开源无关框架、对数据本地化有强要求的团队。
LangSmith(LangChain)
LangChain旗下商业平台,面向代理的观测、评估、部署一体化工具。虽然支持多语言SDK与OTel,但它是LangChain、LangGraph的默认后端,原生集成成本最低。
- 追踪:完整对话与代理步骤追踪,内置AI助手Polly用来总结超长链路定位问题;LangSmith Engine可以把线上故障聚类,定位根因并给出修复建议。
- 评估:支持代码式、LLM裁判、多轮评估,评估器支持对齐人类偏好;上线前可以并排对比实验效果;标注队列交给领域专家复核输出。
- 生产监控:在线评估直接作用生产流量,自动聚类识别故障模式;2026版本实现统一成本视图,把LLM调用、检索、外部API开销全部纳入统计。
- 部署:支持AWS/GCP托管、混合部署、企业自托管,还附带代理运行时,支持人工审批流程。
✅最佳适用:基于LangChain / LangGraph开发,希望把可观测、评估、代理托管收拢到同一套体系的企业。
Braintrust
这是一份以评估为核心的平台,也是2026这个赛道融资规模最大的项目之一。
- 追踪:多语言SDK,框架无关,完整代理链路采集;自研Brainstore数据库,高效处理海量复杂Trace查询。
- 评估:属于产品核心能力。数据集版本管理、自动+人工评分、提示词实验、CI回归测试,在上线前拦截质量退化。内置Playground,直接拿线上真实数据测试提示词改动。自带Loop代理,可以分析链路给出提示词优化建议,自动生成评分器、构建数据集。
- 生产监控:实时观测提示词、响应、工具调用、延迟成本,监控幻觉、输出漂移、业务退化。
✅最佳适用:产品导向AI团队,希望把评估作为工作流中心,打通CI/CD质量门禁与线上反馈闭环。
Arize AX 和 Arize Phoenix
Arize采用双产品路线:企业级Arize AX;Phoenix作为源代码可用的自托管组件。
- 追踪:Phoenix原生基于OpenTelemetry,Elastic License 2.0,可自托管,和LlamaIndex、OpenAI Agents SDK深度集成,月下载量超200万次。
- 评估:继承传统ML可观测能力,评估原语能力很强,包含RAG专项质量指标、漂移检测,可以捕捉缓慢发生的输出退化;新增音频评估能力面向语音类应用,同时开放OpenEvals、AgentEvals开源研究项目。
- 生产监控:支持嵌入聚类、漂移检测,同时兼容传统ML与生成式业务,深度对接Azure AI Foundry。
✅最佳适用:强监管、高精度业务场景,同时维护传统机器学习与大模型业务的组织。
MLflow
Databricks主导、Linux基金会旗下开源项目,已经演变为完整代理可观测平台。
- 追踪:原生代理追踪,数据完全归业务方所有,支持OTel GenAI标准导出,不绑定私有格式。
- 评估:自带LLM评判器,支持多轮评估,可对接RAGAS、DeepEval等第三方工具;提供GEPA、MIPRO算法自动优化提示词。
- 生产监控:AI网关统一管理模型访问,实现路由、限流、降级,跨多家大模型厂商统计使用情况。
✅最佳适用:看重数据所有权、不想被商业平台锁定,已经在用MLflow做实验管理的团队。没有MLflow使用基础的团队,上手成本会高于Langfuse这类轻量化方案。
Weights & Biases Weave
W&B在原有实验追踪基础上扩展出的LLM追踪评估组件。
可以完整记录多智能体系统执行链路,保留代理之间父子调用关系,捕获输入输出、延迟、Token消耗。优势是可以直接对接W&B内部已有的模型、数据集、实验历史。
计费按照数据摄入量,免费版每月1GB,Pro版每月60美元起包含1.5GB,超出之后按MB计费。大提示词、长检索文档会带来较高成本。整体LLM相关能力成熟度弱于它家传统实验追踪产品。
✅最佳适用:已经深度使用W&B,不想切换平台,需要做生产大模型追踪的ML研究团队。
Helicone
AI网关赛道代表项目,开源实现。只需要把流量路由经过网关,几乎不用改动业务埋点,就拿到成本、Token、延迟大盘。自带响应缓存,可以显著降低API开销,同时支持提示词实验,方便非技术人员参与调优。
它的优势也正是局限:数据以请求为中心,缺少深度代理调用树、细粒度Span链路,完整生产评估闭环不是产品重点。很多团队会把Helicone网关,搭配专门的追踪评估平台一起使用。
✅最佳适用:希望极低工作量拿到多模型成本统计、缓存、路由能力的团队。
Datadog LLM Observability
传统APM扩展代表。在Datadog原有基础设施监控之上接入Token、单次请求成本、模型延迟、提示注入安全信号,把AI业务状态和上千种系统指标关联,原生支持OTel GenAI v1.37以上版本。后续逐步补齐评估、代理监控、AI安全告警。
产品侧重点和AI原生平台有明显区分:强项是打通AI和基础设施、安全、运维体系;面向开发调优的CI评估能力偏弱,企业经常会在此之上叠加专门评估工具。
✅最佳适用:已经全套使用Datadog,希望把LLM观测融入现有运维体系的企业。
快速一览(编辑主观评级,非实测基准)
| 平台 | 阵营 | 许可证/模式 | 追踪深度 | 评估强度 | 自托管 |
|---|---|---|---|---|---|
| Langfuse | AI原生开源 | MIT核心;云 | 深度,OTel原生 | 强(评判器+数据集+CI) | 是(领导者) |
| LangSmith | AI原生商业 | 专有 | LangChain/LangGraph最深 | 强(校准评判器,聚类) | 是(企业) |
| Braintrust | 评估优先商业 | 专有 | 深度(Brainstore) | 最强工作流(CI门控,Loop) | 混合选项 |
| Arize AX / Phoenix | AI原生+源代码可用 | Phoenix: ELv2,源代码可用 | 深度,OTel原生 | 最深原语,漂移,音频 | 是(Phoenix) |
| MLflow | 开源平台 | Apache 2.0 | 深度,OTel GenAI导出 | 强(评判器,GEPA/MIPRO) | 是 |
| W&B Weave | ML平台扩展 | Apache 2.0 SDK;商业云 | 良好(多代理树) | 良好(评分器,评判器) | 企业 |
| Helicone | 网关 | 开源 | 请求级 | 轻量 | 是 |
| Datadog LLM Obs. | APM扩展 | 专有 | 良好,基础设施关联 | 中等 | 否(SaaS) |
© 版权声明
文章版权归作者所有,未经允许请勿转载。