Cmpnd 正式推出 dspy-wsp,这是一个将前沿的“权重空间编程”(Weight-Space Programming, WSP)技术集成到 DSPy 框架中的原型优化器。通过名为 WeightSpace 的模块,开发者可以利用大型语言模型(LLM)直接读取并编辑小型决策模型的权重张量,无需传统的梯度下降、训练循环或微调数据集。这一创新为小型模型的快速迭代和性能提升提供了一种低成本、高精度的新路径。
- GitHub:https://github.com/cmpnd-ai/dspy-wsp
核心概念:从提示优化到权重编辑
在传统的 DSPy 工作流中,开发者通常通过优化提示词(如 MIPROv2)或进行微调(如 BootstrapFinetune)来提升模型表现。而权重空间编程则开辟了第三条道路:
- 提示优化:仅改变输入文本,模型权重不变。
- 微调:通过梯度下降改变权重,需要大量数据和算力。
- 权重空间编程 (WSP):由一个强大的“写入者”LLM(如 GPT-6-Astra)分析学生模型的权重张量,推理其计算逻辑,并直接编写代码修补特定权重以匹配自然语言描述的目标。
工作原理:三方协作的沙箱环境
dspy-wsp 的运行机制涉及三个关键角色:
- 学生 (Student):待优化的本地小模型(0.6B 到 9B 参数),其权重加载到 Python 进程中。
- 写入者 (Writer):前沿 LLM(推荐 GPT-6-Astra),负责推理权重结构并生成编辑代码。
- 沙箱 (Sandbox):安全执行环境(macOS 使用 sandbox-exec,Linux 使用 bubblewrap),用于运行写入者生成的权重读写代码。
优化流程:
写入者在限定的轮次(默认 25 轮)内工作。每轮它可以选择:
- 读取/编辑权重:生成 Python 代码直接在沙箱内修改张量。
- 前向传递验证:在练习集上运行模型,观察输出变化。
当预算用尽后,系统会在隐藏的验证集上对比原始模型与编辑后模型的表现,最佳编辑将被保存为补丁。
性能表现:小模型增益显著
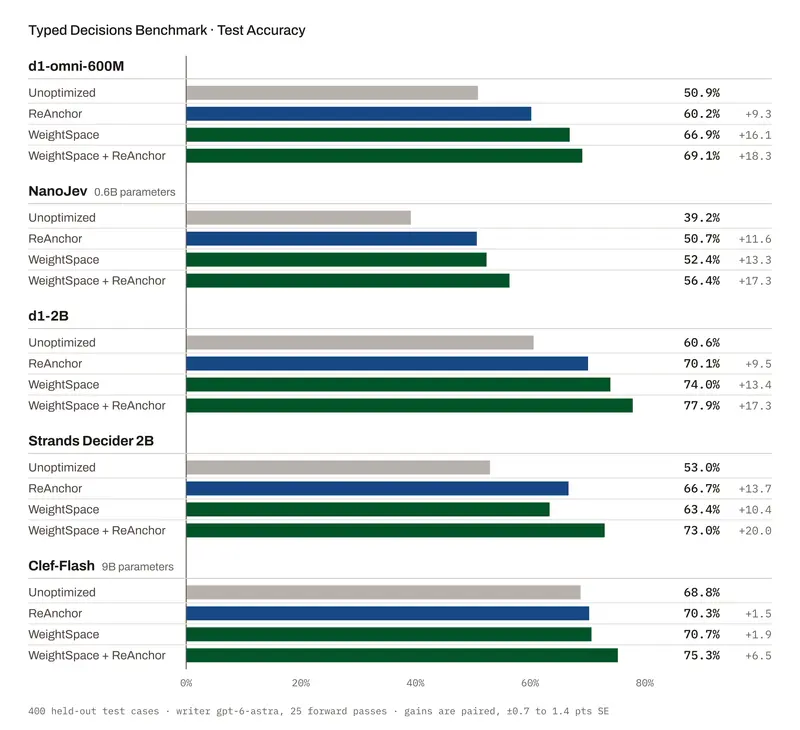
在 Typed Decisions 基准测试中,WeightSpace 展现了惊人的优化能力,尤其是在与 Cmpnd 的另一款优化器 ReAnchor(重新校准输出阈值)结合使用时:
| 模型 | 未优化准确率 | WeightSpace (+16.1) | ReAnchor (+9.3) | WS + ReAnchor (+18.3) |
|---|---|---|---|---|
| d1-omni-600M | 50.9% | 66.9% | 60.2% | 69.1% |
| NanoJev (0.6B) | 39.2% | 52.4% | 50.7% | 56.4% |
| d1-2B | 60.6% | 74.0% | 70.1% | 77.9% |
| Clef-Flash (9B) | 68.8% | 70.7% (+1.9) | 70.3% | 75.3% (+6.5) |
注:对于较大的 9B 模型,单独使用 WeightSpace 增益有限,但与 ReAnchor 结合后仍有显著提升。
成本与效率
- 经济高效:每次优化运行(25 轮)的成本约为 5.42 至 7.63 美元(取决于写入者模型)。
- 时间消耗:单次运行耗时约 78 至 167 分钟。
- 资源需求:极低。2B 模型仅需约 6GB 内存,可在普通 Mac 或单张 GPU 上运行。
部署与兼容性
优化后的模型以“补丁”形式发布(仅包含更改的权重条目及哈希校验),确保可复现性:
- 决策模型:可直接写入检查点并在本地运行(支持 Apple Silicon MLX 或 Linux PyTorch)。
- 文本 LLM:可通过
dspy-wsp apply命令应用补丁,并使用 vLLM 等服务引擎部署。 - 支持后端:涵盖 Liquid AI d1 系列、NanoJev (Qwen3)、以及通过 VLLM/HF/MLX 后端支持的通用 LLM。
局限性与展望
尽管潜力巨大,dspy-wsp 仍处于实验阶段:
- 规模限制:在较大模型(如 9B+)上的直接权重编辑效果递减,更适合作为辅助手段。
- 速度较慢:相比自动化的梯度微调,LLM 推理驱动的编辑过程较为缓慢。
- 规则敏感性:若严格禁止写入者在沙箱内重新计算决策头,性能增益会大幅缩水。
dspy-wsp 的发布标志着 AI 优化范式的一次重要探索:让 LLM 不仅作为内容生成者,更成为模型架构的直接“外科医生”。对于追求极致性价比和可控性的开发者而言,这提供了一把无需海量数据即可精调模型的瑞士军刀。
© 版权声明
文章版权归作者所有,未经允许请勿转载。