MOSS-image-edit-grabtag:分区打标工具,为 MOSS-Image/ComfyUI 生成区域色图 + layout.json,CPU 纯 Python 运行
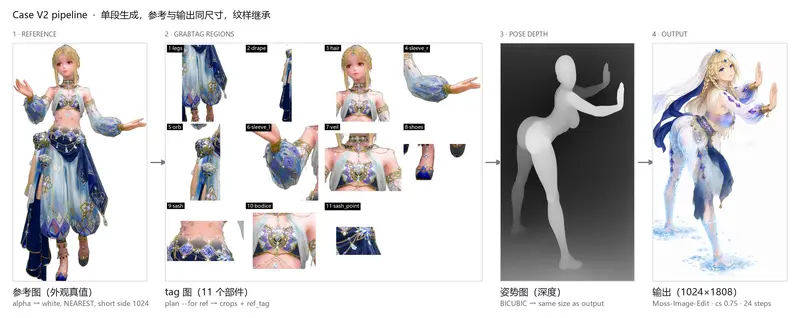
GrabTag 是一款专为 MOSS-Image 与 ComfyUI 工作流设计的图像预处理工具。其核心功能是将单张参考图像划分为多个逻辑区域,并为每个区域分配独立的文本指令,最终输出区域 ID 色图(Colormap)与 layout.json 配置文件。
- GitHub:https://github.com/blackll7/MOSS-image-edit-grabtag
在常规的参考图生成工作流中,模型往往难以精确对齐文本描述与图像空间位置。GrabTag 通过建立“文字说明材质,像素说明位置”的双通道映射机制,使模型明确知晓“哪段提示词对应哪个边界框”,从而在不注入任何 LoRA、不引入训练集风格偏好的前提下,实现对生成画面的细粒度几何与材质控制。
核心机制与适用场景
GrabTag 通过纯 Python 环境运行(依赖 Pillow,可选 OpenCV/Scipy/SAM),不绑定特定框架,也不包含模型权重。其工作逻辑主要解决文本(无几何信息)与像素(无材质信息)在分区感知模型中易发生混淆的问题。
根据输入数据的不同,GrabTag 支持三种几何通道配置:
- 参考图 + 姿势图(文字与深度扛几何):利用深度图锁定整体轮廓,通过提示词明确各区域内容,全程不依赖区域 ID 色图。
- 纯区域 ID 色图(像素扛几何):色图负责定义“在哪里”,对应的文本指令负责定义“是什么”,两者缺一不可。
- 混合模式(色图管落位,指令管材质):结合上述两者,色图控制空间布局,每个区域的独立指令控制局部材质与细节。
环境配置与安装部署
GrabTag 支持 Python 3.9 及以上版本。除非使用 SAM(Segment Anything)模型并启用 CUDA 加速,否则全程可在纯 CPU 环境下运行,无需独立显卡。
1. 基础安装
克隆仓库并进入目录,安装核心依赖(包含 numpy 与 Pillow,支持所有基础子命令):
git clone <本仓库地址> && cd grabtag
pip install -e .
2. 可选依赖安装(按需选择)
- 掩码细化支持:若需使用
--masker grabcut、--fit或--min-area参数进行轮廓细化,需安装 OpenCV 与 Scipy:pip install -e ".[mask]" - SAM 自动分割支持:若需使用
--masker sam-auto进行高精度自动分割,需安装 PyTorch 与 segment-anything:pip install -e ".[sam]"
3. 环境验证
安装完成后,运行以下命令验证工具是否就绪:
grabtag --help
核心工作流:从切区到条件导出
标准工作流分为“规划(plan)”、“人工标注”与“构建(build)”三个步骤。以下以示例文件为例:
步骤 1:执行区域规划
# 生成演示参考图(无需外部素材)
python examples/make_demo.py examples/demo.png

# 执行切区、上色并生成初步清单
python grabtag.py plan --ref examples/demo.png \
       --spec examples/demo_spec.json --out build/demo
步骤 2:人工填充文本指令
打开生成的 build/demo/montage.png(带序号的裁片预览图),对照视觉内容,在 build/demo/regions.json 中为每个区域填写 ref_tag(参考侧标签)与 paint_prompt(生成侧区域指令)。
步骤 3:导出分区条件
python grabtag.py build --dir build/demo
注:若任何区域缺失 paint_prompt,build 命令将直接报错退出,以确保下游数据的完整性。
核心产物说明:
执行完毕后,build/demo/ 目录下将生成以下文件:
regions.json:用户填写的核心配置文件,包含区域 ID、颜色、边界框、裁剪信息及文本指令。tags.json:参考侧标签汇总,供编写全局提示词时参考。cm.png:区域 ID 色图(像素通道),每种纯色代表一个独立区域。montage.png:带序号的区域裁片拼接图,用于视觉核对。layout.json:包含summary.text与items(含 label, paint_prompt, bbox)的结构化数据,供分区感知采样器直接消费。layout.audit.json:在layout.json基础上增加_region、_kept(保留比例)与_warn(警告)字段,专用于排查覆盖冲突。
字段变更说明(2026-11-06 起):参考侧标签字段由 tag 更名为 ref_tag,生成侧指令由 caption 更名为 paint_prompt,全局描述由 summary.caption 更名为 summary.text。代码向下兼容旧名称读取,但仅输出新名称。
命令行参数与高级功能
1. plan 命令(定义区域并上色)
--ref IMG:输入参考图(任意尺寸,可按--size归一化)。
each--bands N:将图像横向等分为 N 段(最快的基线切分方式)。--band a:b:自定义分数切点,例如--band 0.0:0.30。--rect name=x0,y0,x1,y1:通过坐标手动定义自由边界框。--spec FILE:通过 JSON 清单批量定义区域(支持 name, rect, color, ref_tag, paint_prompt, priority 等字段)。--for both|ref|layout:控制输出目标。ref仅输出裁片与 tags;layout仅输出色图;默认两者均输出。--masker grabcut|sam-auto:调用掩码算法将矩形区域细化至真实物体轮廓。--fit bg|depth:仅对主体轮廓上色,保留发丝缝隙与肢体间空隙。--x-inset 0.10:收窄色带宽度。全宽带易被模型误识别为多个独立个体,建议控制在 0.08–0.12。--lint-strict:开启严格自检,若paint_prompt不达标则以退出码 2 终止运行。
2. build 命令(导出分区条件)
--sort small|area|y:排序策略。建议使用small,将小尺寸物件排在前面,降低其在生成时被大区域覆盖的概率。
3. 其他专用命令
colormap:由深度图驱动的横带分区(支持--subject仅对主体上色)。depth-colormap:深度切片模式(支持 seed, band, front, plateau 模式)。chroma:绿幕抠像工具,输出 RGBA 图像及棋盘格预览图(支持--rotate与--metric参数)。
下游集成与实战工程建议
1. 在 ComfyUI / MOSS-Image 中的集成规范
- 色图尺寸限制:区域 ID 色图(
cm.png)不宜过大。基于 16×16 patch 的 VAE 架构限制,需满足(w/16) * (h/16) ≤ 4096,即图像分辨率建议控制在 1024×1024 以内。 - 文件放置:图像 Loader 通常仅接受其专属
input/目录下的文件名,需将cm.png拷贝至该目录并传入裸文件名。 - JSON 注入方式:
layout.json是供分区感知采样器(如 MOSS-Image 的 layout encoder)读取的结构化文本,不可作为图像输入。需将其作为 JSON 文本字符串直接嵌入提示词字段中。
2. 实战六条工程经验
- 一区一物件:若未给特定部件单独划分区域,模型将自行臆造其形态与位置。
- 颜色绝对唯一:不同区域若使用相同的 RGB 值,在 layout 导出时会被强制合并为单一实体。
- 指令必须明确落点:模糊的描述(如 “a lotus ornament”)易导致元素错位;精确的描述(如 “a lotus ornament printed flat on the chest, between the collarbones”)能确保生成位置准确。
- 区域数量阈值:全身像建议控制在 12 个区域左右为最佳甜点区。超过 16 个区域时,小尺寸物件极易在生成中消失。
- 窄框控制策略:使用横带模式时,务必通过
--x-inset参数将色带收窄至 0.08–0.12,避免全宽带将单个人物错误切割为多个独立个体。 - 职责分离原则:色图负责控制几何轮廓,文本指令负责控制材质细节。修改文本指令无法改变物体的基础形状;若需调整几何形态,必须重新生成或修改色图。
© 版权声明
文章版权归作者所有,未经允许请勿转载。