Polymathic AI 联合普林斯顿大学、USC ISI、NYU 及 Flatiron 研究所的研究团队,正式发布了一种名为 FlashMap 的新型推测解码起草器。该模型通过连续流映射技术取代传统的离散扩散起草器,在单次前向传播中即可起草完整的 16 token 块。
- 项目主页:https://jshen.net/flashmap/
- GitHub:https://github.com/al-jshen/flashmap
- 模型:https://huggingface.co/collections/j-shen/flashmap
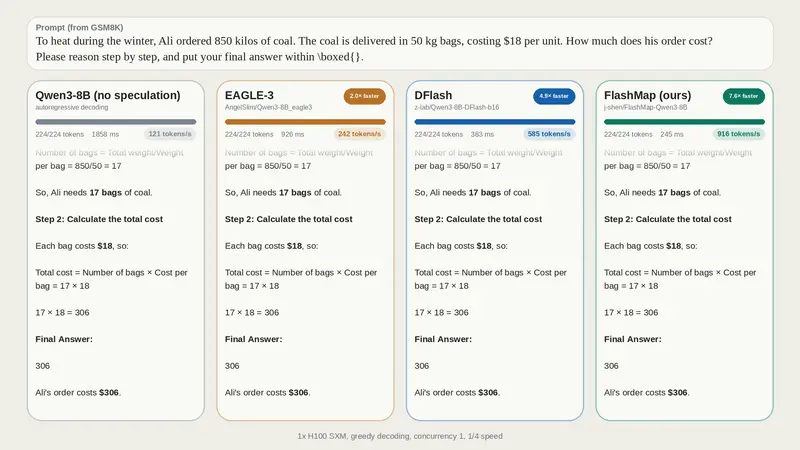
在 Qwen3-8B 模型上,研究团队报告在 GSM8K 测试中实现了高达 6.14 倍的无损加速。目前,相关起草器权重已在 Hugging Face 开源,并配套提供了 vLLM 和 SGLang 插件。
核心机制:连续流映射解决 Token 依赖问题
传统扩散起草器(如 DFlash)通常独立预测块中的每个 token 槽位,这被称为因子化近似。这种机制容易导致 token 间缺乏逻辑关联。
例如,在续写“new york”或“san diego”时,独立起草器可能错误组合出“new diego”,从而在第二步被目标模型拒绝,导致接受率下降。
FlashMap 建立在 Flow Map Language Models 基础之上。它通过将高斯噪声直接映射到完整的 token 块,确保块内 token 的联合一致性。这种设计使得起草的 token 块在逻辑上相互保持连贯,从而显著提升了目标模型的接受长度。
架构设计与两阶段训练流程
FlashMap 起草器的参数量极小(Qwen3-8B 对应 500M,Qwen3-4B 对应 475M),采用 6 块扩散 Transformer(DiT)架构,嵌入维度为 2048,包含 16 个注意力头。
在工作时,它通过读取目标模型第 1、9、17、25 和 33 层的隐藏状态进行预测。其嵌入矩阵和语言模型头直接从目标模型复制并保持冻结,以降低训练成本。
训练过程分为两个阶段:
- 流教师阶段:使用交叉熵在独热 token 块上训练连续的流,并通过时间重新参数化处理 Qwen3 的 151,936 token 词汇表。
- 流映射学生阶段:通过半群蒸馏技术,将流转变为 2 时间降噪器,使模型能够在 1 步内从噪声直接跳转到数据分布。
两个起草器均在来自 Open-PerfectBlend 的 500K 样本上进行训练,总算力消耗约为 H200 GPU 上的 4,600 小时。
基准测试表现与客观局限
在涵盖数学、代码和聊天领域的 9 个基准测试中,FlashMap 展现了明确的性能优势,但也存在特定场景下的局限。
- 速度与接受率:在 Qwen3-8B 的所有任务及两种温度设置下,1 步 FlashMap 均为最快的起草器,平均比重新训练的 DFlash 快约 7%。在 18 个测试设置中,1 步 FlashMap 在 15 个设置下的接受长度击败了 DFlash,且参数量仅为后者的一半。
- 特定场景增益:在聊天任务中(温度 0),其相对 DFlash 的增益达到 11.1%;在数学任务中增益为 5.5%。若开启 2 步模式,接受长度在 18 个设置中全部击败 DFlash,平均高出 10%。
- 性能局限:在温度 1 的 Alpaca 测试中,加速比降至 2.28 倍。此外,在 Qwen3-4B(温度 0)的 9 个任务中,有 4 个任务的表现落后于 DFlash。
工程部署与主流框架集成
开发者可通过 uv pip install flashmap 快速安装,运行环境仅需 torch 和 transformers>=4.56。spec_generate 调用可在单块 GPU 上同时运行起草器和目标模型。
针对生产环境的服务部署,官方提供了两条主流路径:
- vLLM (0.31):在
--speculative-config中传入起草器配置,并将num_speculative_tokens设为 16。若需温度大于 0 的采样,需额外设置"draft_sample_method": "probabilistic"。 - SGLang (0.5.20):使用
--speculative-algorithm DSPARK参数,并指定 FlashMap 的草稿路径。
在实际应用中,若需进一步提升接受率,可将 num_steps 设置为 2,以少量推理速度换取更稳定的输出质量。
© 版权声明
文章版权归作者所有,未经允许请勿转载。