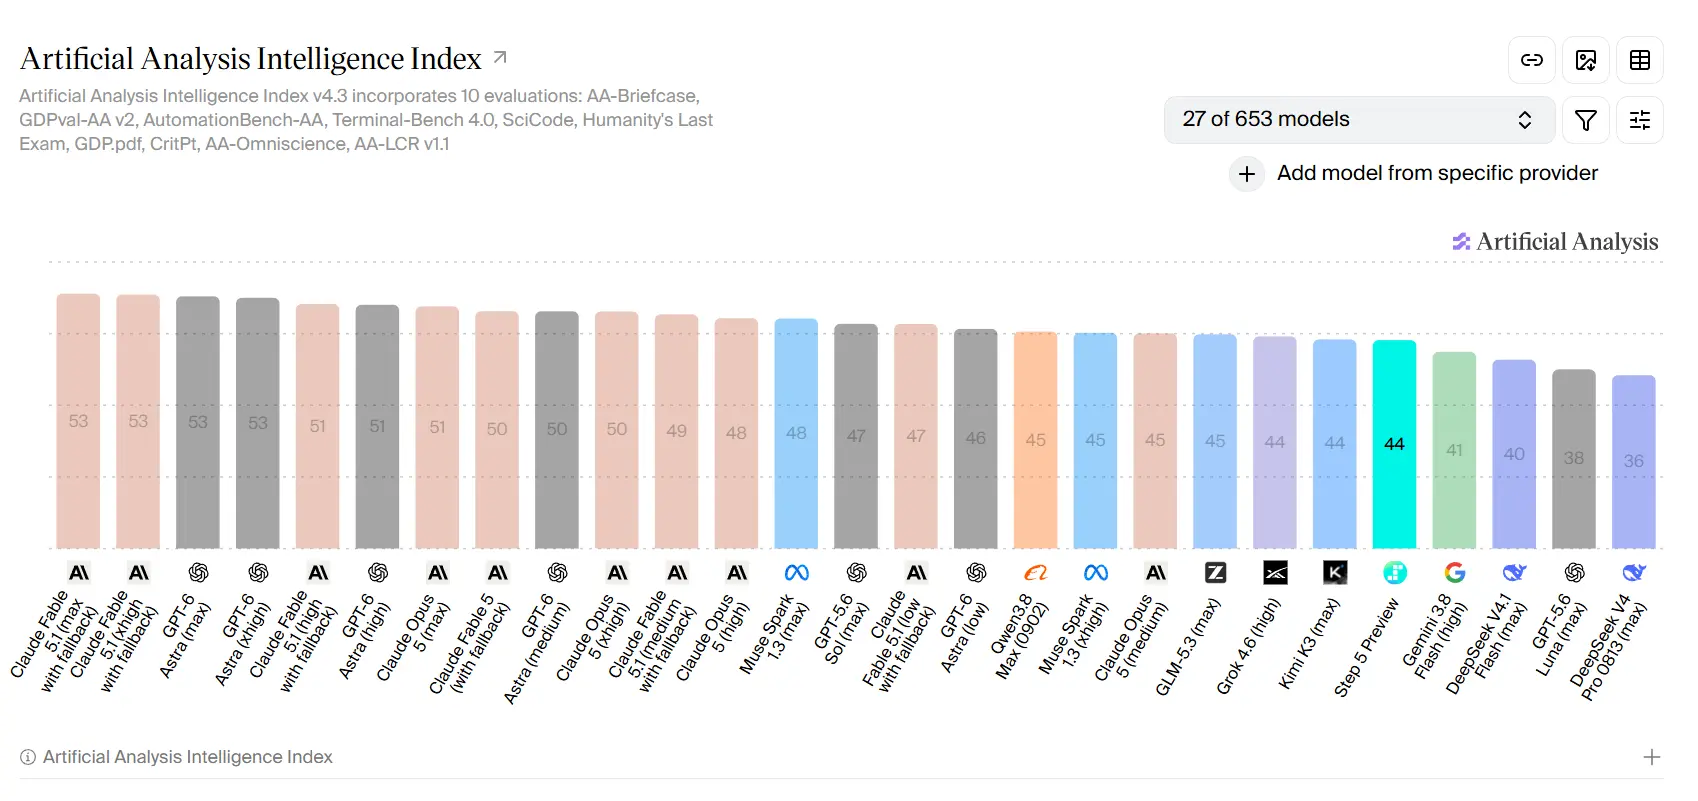
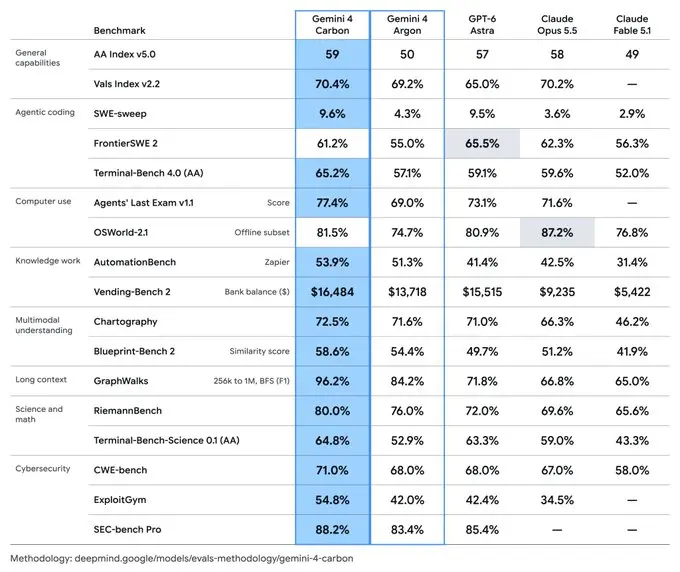
今天,谷歌正式发布了新一代前沿模型 Gemini 4 Carbon。该模型在网络安全防御和长时程任务处理方面进行了针对性优化。在最新更新的 Artificial Analysis Intelligence Index v5.0 中,Carbon 以 59 分的成绩位列第一。
综合排名与长时程工程任务优化
Carbon 建立在两周前发布的 Gemini 4 Argon 基础之上。它专为持续的智能体工作流和复杂的工程问题设计。
在实际应用中,该模型能够连续运行数天,处理大型代码库中的多步工程任务,例如根因分析和细微错误修补。
基于用户反馈,团队重点提升了编码、智能体、科学任务及全栈 Web 开发能力。
在 Web 开发领域,输出和制品质量得到改善。Carbon 在 WebDev Arena 的评分提升了 89 个 elo 点,达到 1768 分,排名升至第四位。
在内部实时编码环境中,Carbon 的代码生成错位率和捏造率均有明显下降。
网络安全防御的三项关键指标
在网络安全方面,Carbon 覆盖了漏洞检测、验证和修复的完整生命周期。在关键外部基准测试中(无护栏状态),其具体表现如下:
- 发现真实漏洞:在 SEC-bench Pro 测试中得分 88.2%,能够自主发现现实世界软件中的复杂缺陷。
- 利用验证风险:在 ExploitGym 基准测试中得分 54.8%,帮助防御者优先评估漏洞的可利用性。
- 根因修补:在 Collinear 的 CWE-bench 测试中得分 71.0%,将验证结果转化为可执行的代码修复。
内部测试数据显示,Carbon 生成安全代码的成功率比 Argon 提升超过 2 倍。Chrome 团队反馈,其在生成高质量补丁方面的表现比另一家实验室的前沿模型高出 10 倍以上。云安全平台 Wiz 也观察到其在 Web 渗透测试基准上的领先表现。
模型安全护栏与行为对齐优化
Carbon 延续了多层安全与保障架构,并在模型对齐方面进行了具体改进,以应对复杂任务:
- 减少捷径与作弊:在 Terminal-Bench 4.0 测试中,成功作弊率降至 0.0%,作弊尝试降至 0.4%。内部环境中高严重性错位警报下降近 80%。
- 降低无根据声明:内部测试显示,无根据声明数量比 Argon 减少约 2 倍。模型会将方法论警告直接写入交付物,或在行动受阻时提供待办清单,避免含糊其辞。
- 改善歧义处理:面对模糊指令,模型会先检索相关来源并向用户展示差异,而不是强行猜测或推进。
- 执行边界控制:越界行为减少 26%,服务不足情况减少 29%,确保多步计划在项目约束内可靠执行。
- 抵御提示注入:在 Gray Swan 的间接提示注入(IPI)基准测试中,攻击成功率从 Argon 的 0.7% 降至 0.0%。
定价策略与分阶段开放计划
Gemini 4 Carbon 维持了与 Argon 相同的初始定价:
- 输入 token 价格:每百万 2 美元。
- 输出 token 价格:每百万 10 美元。
- 缓存输入 token:享受输入 token 价格 95% 的折扣。
在发布节奏上,谷歌采取了分阶段推进的策略,并参与了美国政府的发布前模型自愿测试流程。
本周起,Carbon 将优先向部分网络防御者开放。随后通过 Fairwind 计划逐步向更多可信合作伙伴提供访问权限。
在持续收集反馈并迭代安全护栏后,该模型将尽快通过产品界面向开发者、企业和消费者全面开放。
© 版权声明
文章版权归作者所有,未经允许请勿转载。